MIT历史学者林德奎斯特研究早期AI工程师为何刻意在算法中注入随机性以模拟人类创造力。他指出这种随机性正是当今大模型产生“幻觉”的源头,创造力与可预测性之间存在必然权衡。早期研究者重视系统偶尔给出意外答案,如今商业系统则压制这种怪异。他提醒,消除幻觉可能付出牺牲创造力的代价。
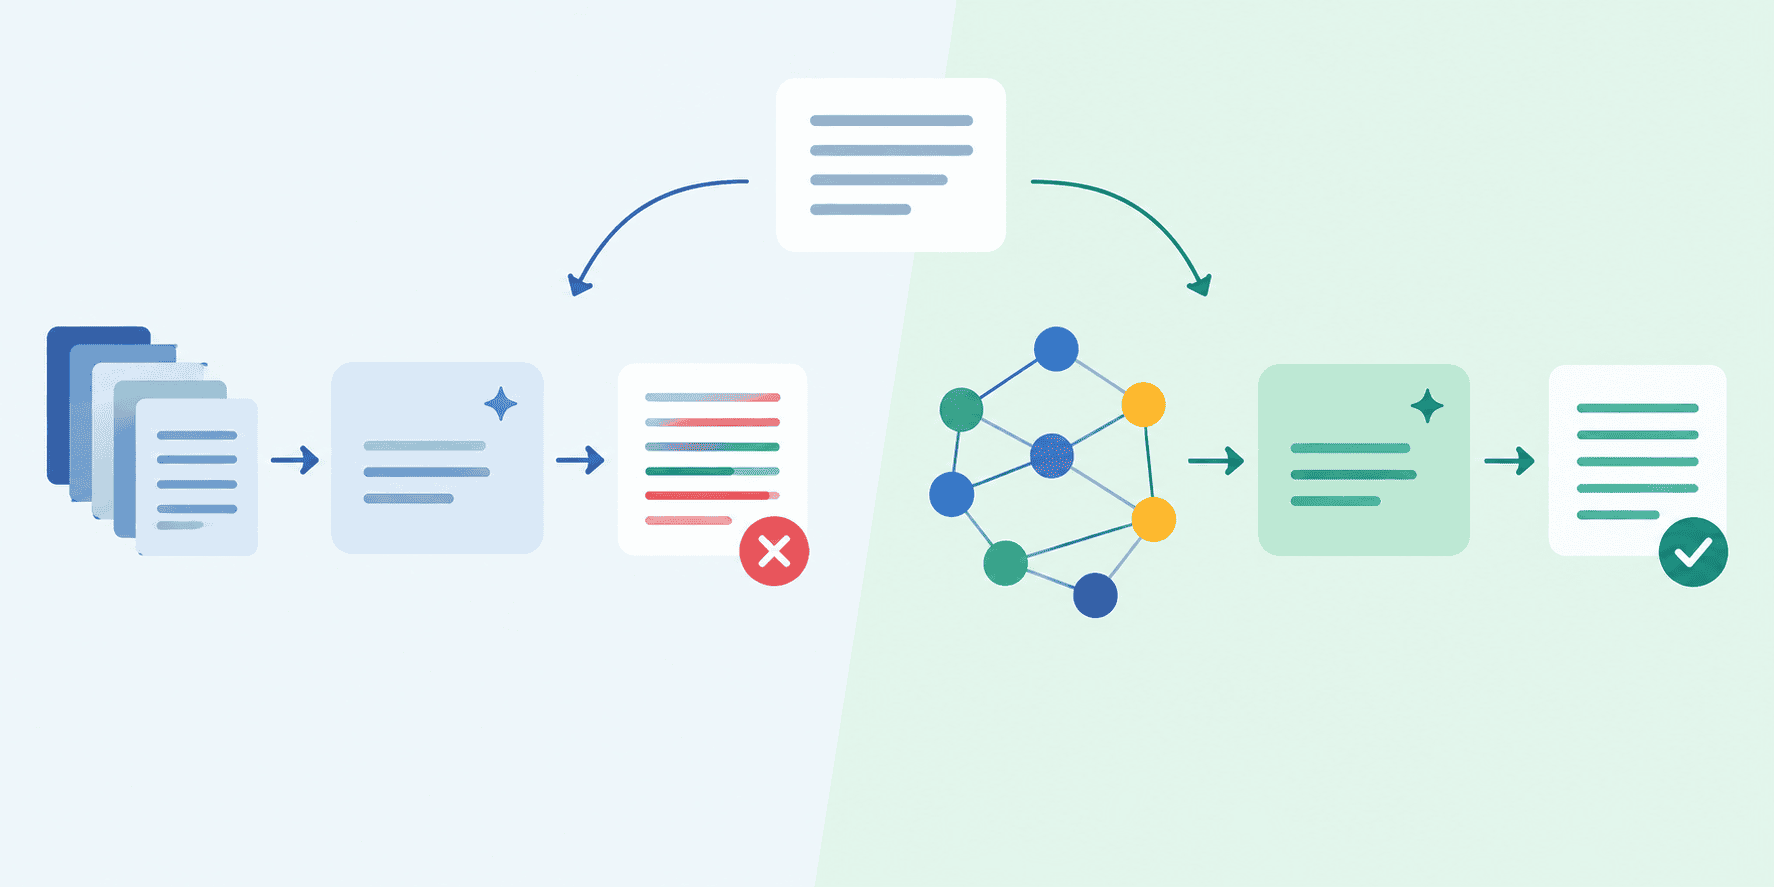
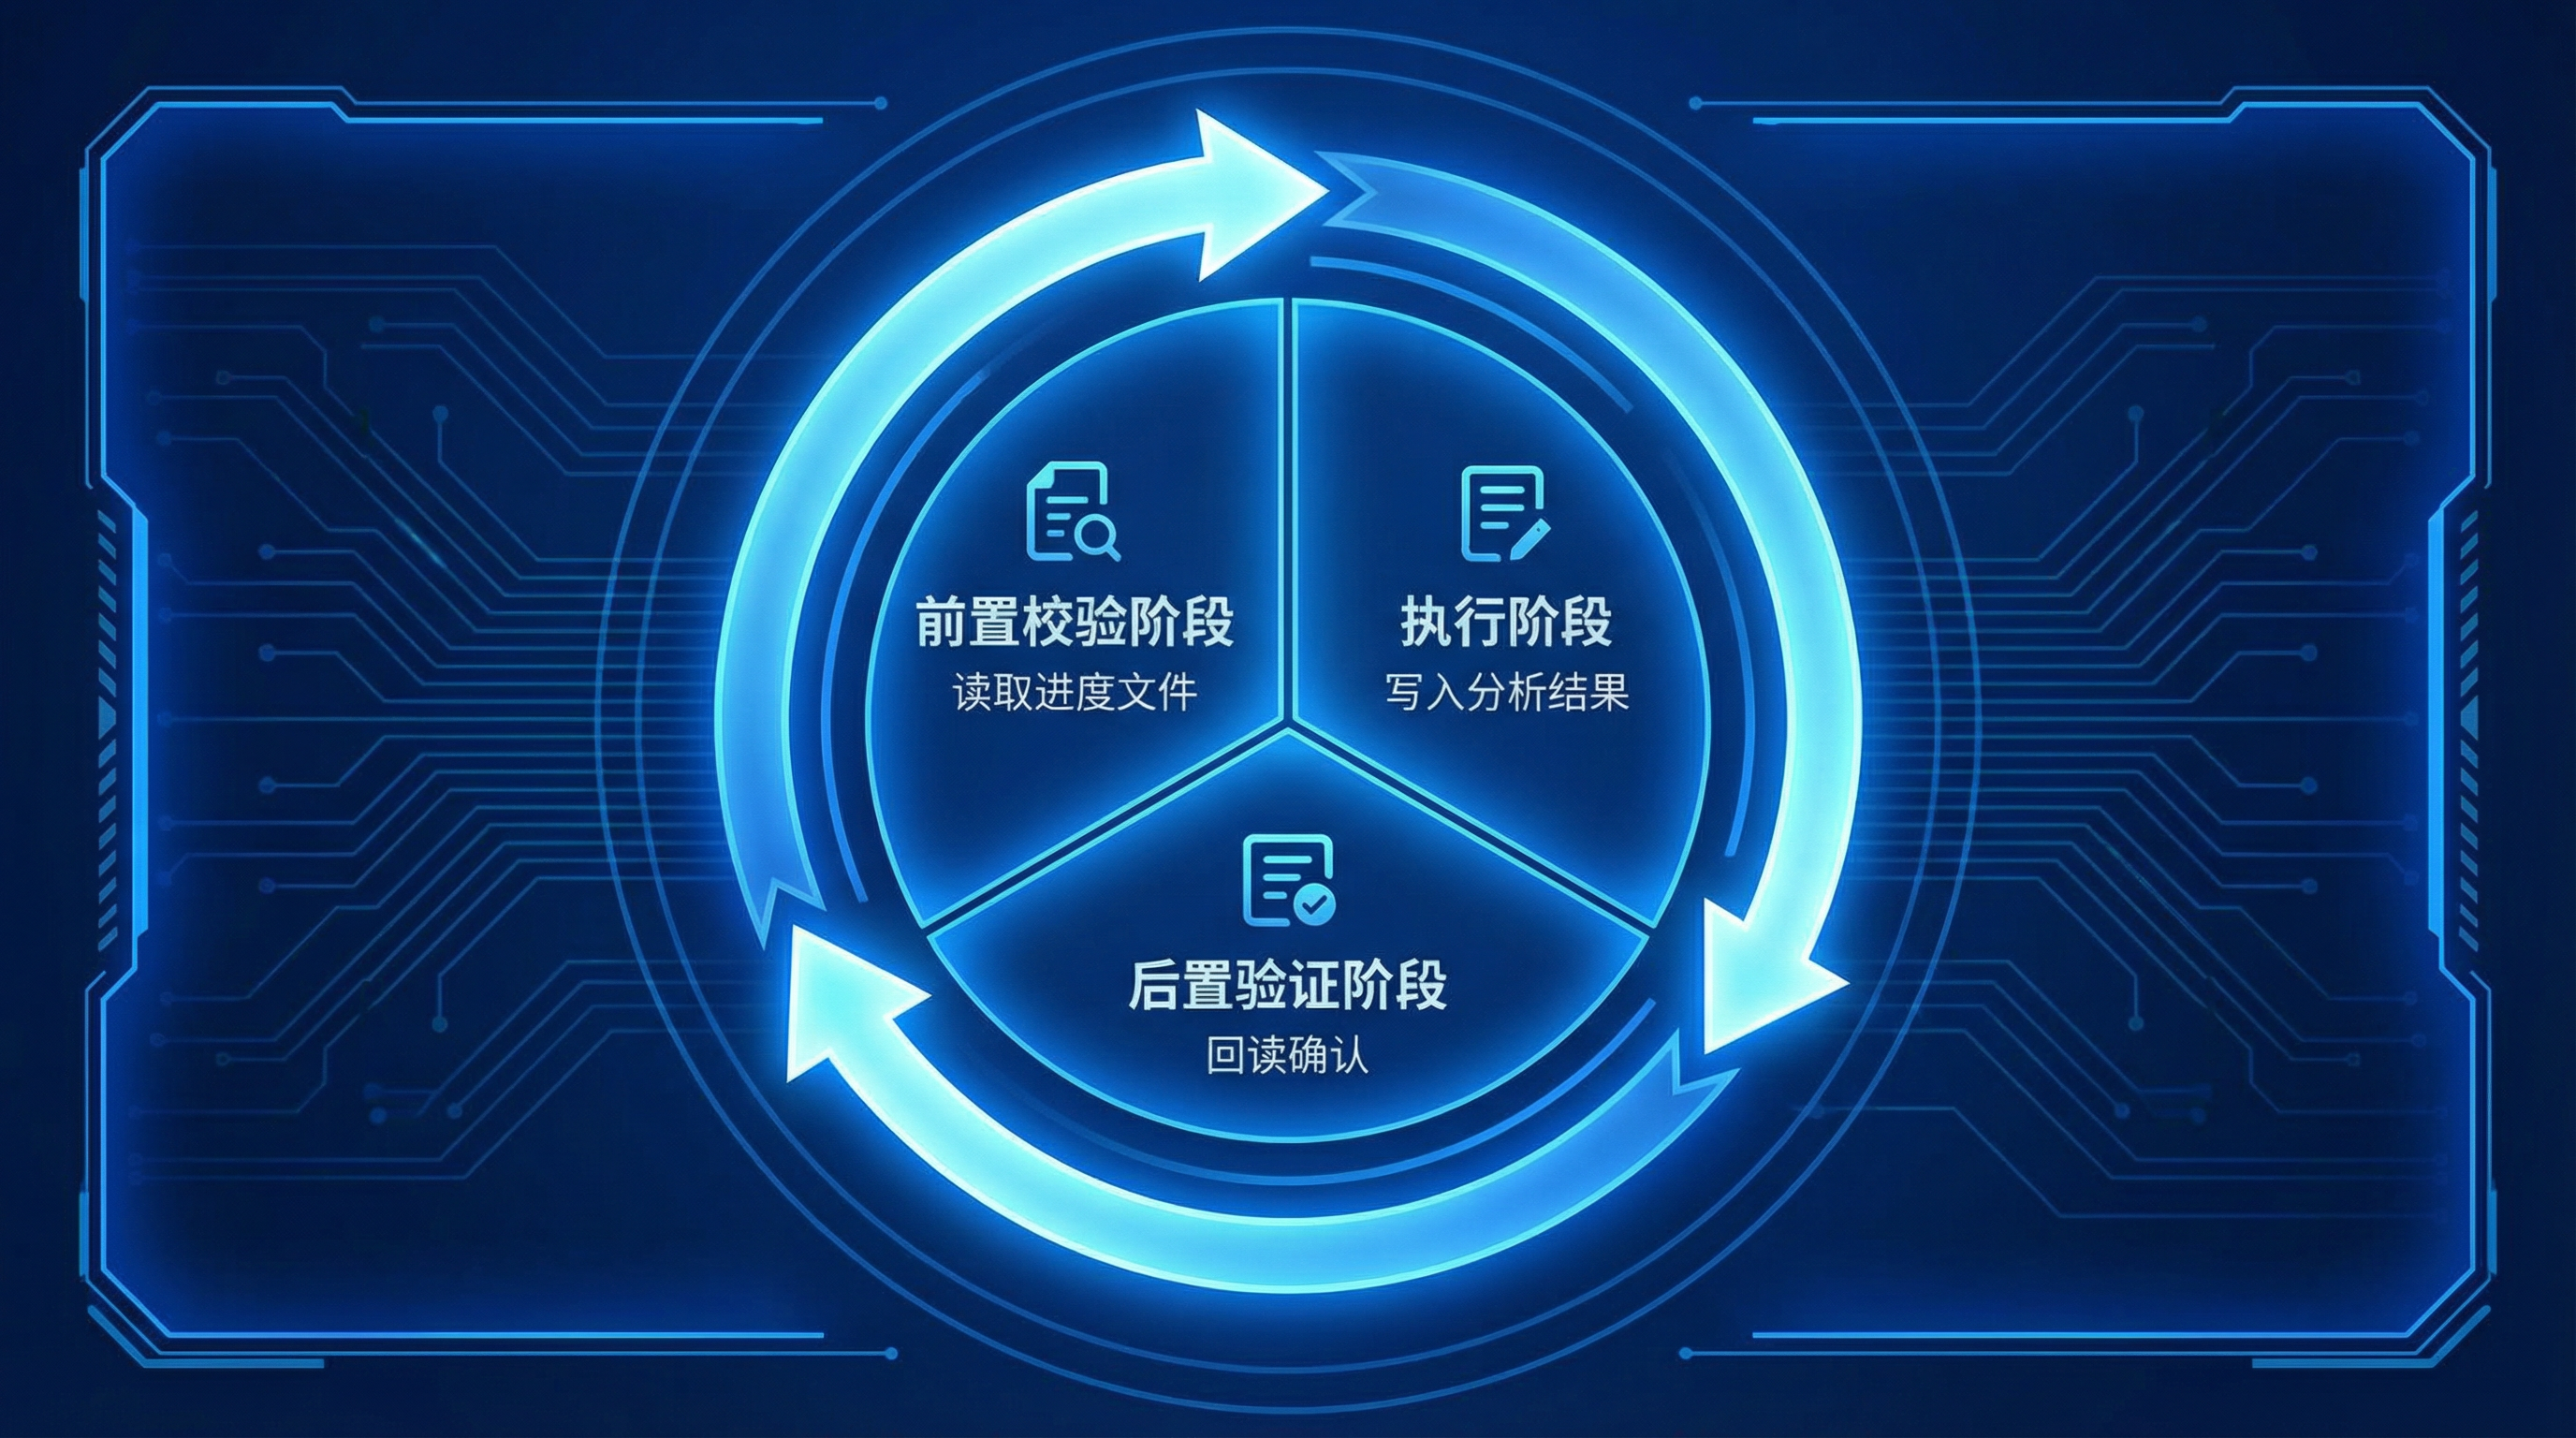
大语言模型易产生幻觉,检索增强生成(RAG)通过外部知识降低错误。但标准RAG流程线性、仅单次检索,难以应对多步推理、跨文档综合等复杂查询。Agentic RAG将模型变为自主推理引擎,形成“规划—执行—评估—循环”,具备查询路由、查询分解、自我反思与工具调用四种机制。简单查询宜用标准RAG,复杂高精度场景宜用Agentic RAG,也可混合使用。
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
生成式AI普及后,顾客常将ChatGPT的回答视为权威,甚至以此质疑服务人员。餐厅服务员遇到客人无视过敏警告,坚持AI称菜品安全;侍酒师被ChatGPT取代,客人点不存在的酒。公园护林员、幼教老师也发现游客和家长更信AI而非专业人士,导致荒谬行程和育儿建议。客服人员普遍抱怨AI幻觉让顾客更难沟通。
Gemini 4 Argon幻觉率15%全网吹爆,但96%的DeepSeek其实更诚实! 等等,15%的幻觉率被吹成“解决幻觉”,96%的却被骂成智障,这两个数字背后藏着一个让所有人都搞反了的真相! 这篇要扒的是AI圈最新的“大字报陷阱”——AA-Omniscience幻觉率排行榜。谷歌Gemini 4 Arg
大语言模型会产生“幻觉”,即生成看似自信却与事实或给定材料不符的内容。原因是模型逐词预测文本,追求语言流畅而非核实真伪,且训练激励其猜测而非承认不确定。应对方法包括:用RAG检索提供证据、用工具查询缺失事实、允许“信息不足”作为有效回答、对答案进行独立核查。可靠性需在真实场景中评估,兼顾准确性与实用性。
音乐初创公司Thoughtful Things为采样器Engram发起众筹。该设备本地运行定制小型AI模型,可扭曲音频并生成幻觉般的新声音,面向实验音乐创作,而非一键生成歌曲。固件将开源,支持加载自定义模型。众筹价675美元起,零售价预计850至900美元。
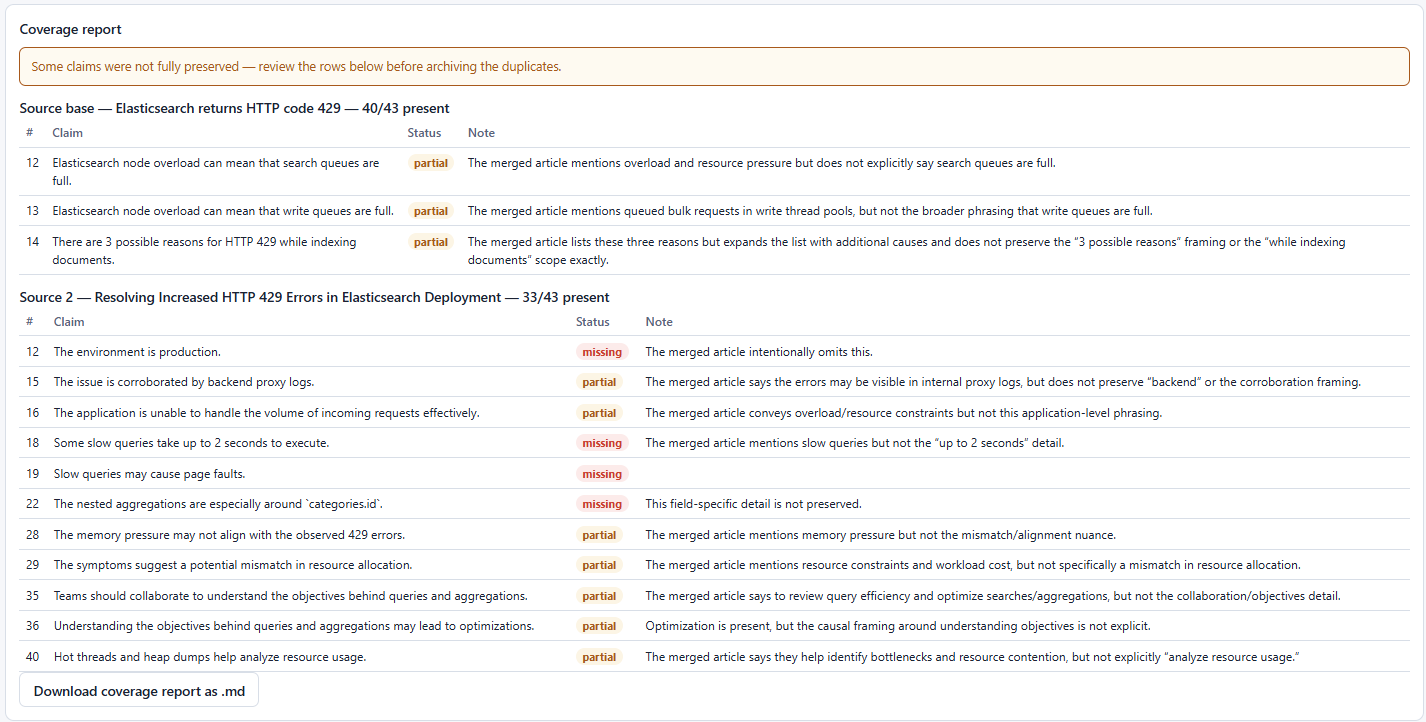
文章介绍用“原子声明核查”防止大模型幻觉,核心是生成与验证分离:第一遍合并重复知识库文章,代码、命令、版本号等原样保留;第二遍将原文拆成最小可核查声明,逐条比对合并稿,标记存在、部分或缺失,并记录冲突。人工只需裁决少量异常项,约五分钟完成一次合并,避免遗漏被误写入知识库。
TypeSafe发布JEV模型,定位为“System One”决策引擎,仅做结构化判断,不生成文本。支持是非、多选、打分三种原语,输出带概率与置信度,响应70~500毫秒,输出免费,结构上不会产生格式幻觉。LangChain、Vercel已集成,用于模型路由、工具风险拦截等。JEV不擅长生成、计数和日期比较,本质是更聪明的if语句,而非替代大模型。
TypeSafe推出判断模型Jev,专用于分类判断而非文本生成,可核查事实、校验引用、重排搜索结果、归类笔记、诊断智能体失败原因。其响应仅0.35至0.52秒,比Gemini 3.5 Flash快三到八倍,准确率多数持平或略逊。Jev让智能体实时自检成为可能,但准确率约79%,复杂长轨迹表现仍待验证。
AI幻觉是生成式AI模型产生的看似合理但错误或虚构的输出,源于模型预测机制而非感知。它带来法律、财务和声誉风险,如谷歌Bard错误导致市值损失、Air Canada聊天机器人误导客户被裁定担责。减少幻觉需结合数据治理、检索增强生成、明确边界、持续评估和人工审核,尤其在高风险领域如医疗、法律和金融。
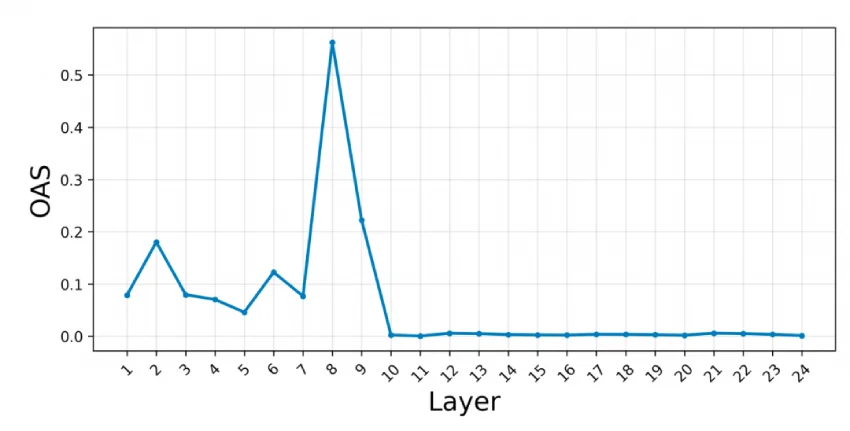
论文针对基于大语言模型的语音合成在复杂文本上出现的重复、漏读等稳定性幻觉问题,提出通过注意力引导进行优化。作者从CosyVoice 2的自注意力中发现对齐注意力头,提出最优对齐分数(OAS)评估对齐质量,并据此强化前向注意力约束;同时利用伪对齐路径构建位置思维链,通过稀疏文本Token和进度条预测显式告知模型合成位置。实验表明,该方法在困难文本上词错误率相对下降约35%,且不损害自然度和说话人相似度。
GraphEval是亚马逊研究者提出的框架,利用知识图谱检测大语言模型的幻觉问题。它通过构建语义三元组,并用自然语言推理模型评估每个三元组是否被上下文蕴含,未蕴含的即标记为幻觉。该框架强调可解释性,便于定位幻觉根源。
LLM并非许愿机,而是概率机,输出取决于上下文信息。任务分压缩、转录、补全三类,补全易致幻觉,需外部验证。有效使用需提供足量原始材料、允许提问、接入搜索工具,并建立反馈闭环(如Plan模式、日志)以修正偏差。多agent系统应保留可追溯证据链,避免信息层层失真。
大模型Skill开发中,核心术语选择影响巨大:用“漏洞”准确率89.3%,用“风险”仅62.1%。原因是“风险”语义宽泛,触发模型发散性输出,突破约束。构建高质量Skill需结构化工作流、校验循环、定义文件和定制工具。应选窄边界词,用否定清单、硬输出格式锚定边界,并可用语义陷阱检测器自动化排查。
文章讨论了在构建可靠AI系统时,处理金融报告PDF所面临的问题。由于自动化数据提取错误,导致信息不准确。为了解决这一问题,团队重新设计了数据管道,采用确定性检查,以确保数据的准确性和完整性,从而提高系统的可靠性并降低成本。
DeepSeek V4 Pro的幻觉率高达96%,但在编程方面表现出色。Minimax M3以16%的低幻觉率显示出更好的自我认知能力。高幻觉率并不意味着模型能力差,而是由于过度自信导致的错误。这表明在不同任务中选择合适的模型至关重要。
《立方体》是吉姆·汉森于1969年创作的超现实剧本,讲述一名男子在白色立方体中醒来,面临现实与幻觉的困惑。剧中人物不断挑战他的理智,探讨存在的本质。尽管鲜为人知,该剧的怪异风格与现代反乌托邦系列《黑镜》相似。
AI的幻觉、越狱和误拒问题源于结构熵与语义熵的失衡。维持临界点负零点零三的平衡是实现通用智能的关键。通过熵平衡训练法,可以提升AI的创新、准确性、泛化能力和自我校正能力。
Mozilla推出MDN MCP服务,旨在解决AI在前端开发中因过时数据导致的“幻觉”问题。该服务通过MCP协议连接MDN文档,确保AI提供最新、准确的Web规范和兼容性信息,从而提升开发效率,减少错误。
完成下面两步后,将自动完成登录并继续当前操作。