小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
如何测试对话式AI:QA工程师实用指南

本文探讨了对话式AI测试的核心挑战:传统软件测试依赖精确预期结果,而AI回答多变。作者提出应转向意图测试、多维度质量评估、多轮对话测试、知识库验证、幻觉检测、回退与人工升级测试,并建立黄金数据集和风险分级回归测试。最终强调,QA工程师需从“精确匹配”转向“行为正确、安全、有用”的验证思维。

如何测试对话式AI:QA工程师实用指南

freeCodeCamp.org freeCodeCamp.org · 2026-08-24T14:36:56Z

GraphEval是亚马逊研究者提出的框架,利用知识图谱检测大语言模型的幻觉问题。它通过构建语义三元组,并用自然语言推理模型评估每个三元组是否被上下文蕴含,未蕴含的即标记为幻觉。该框架强调可解释性,便于定位幻觉根源。

基于GraphEval的语言模型幻觉评估

KDnuggets KDnuggets · 2026-07-24T13:02:40Z
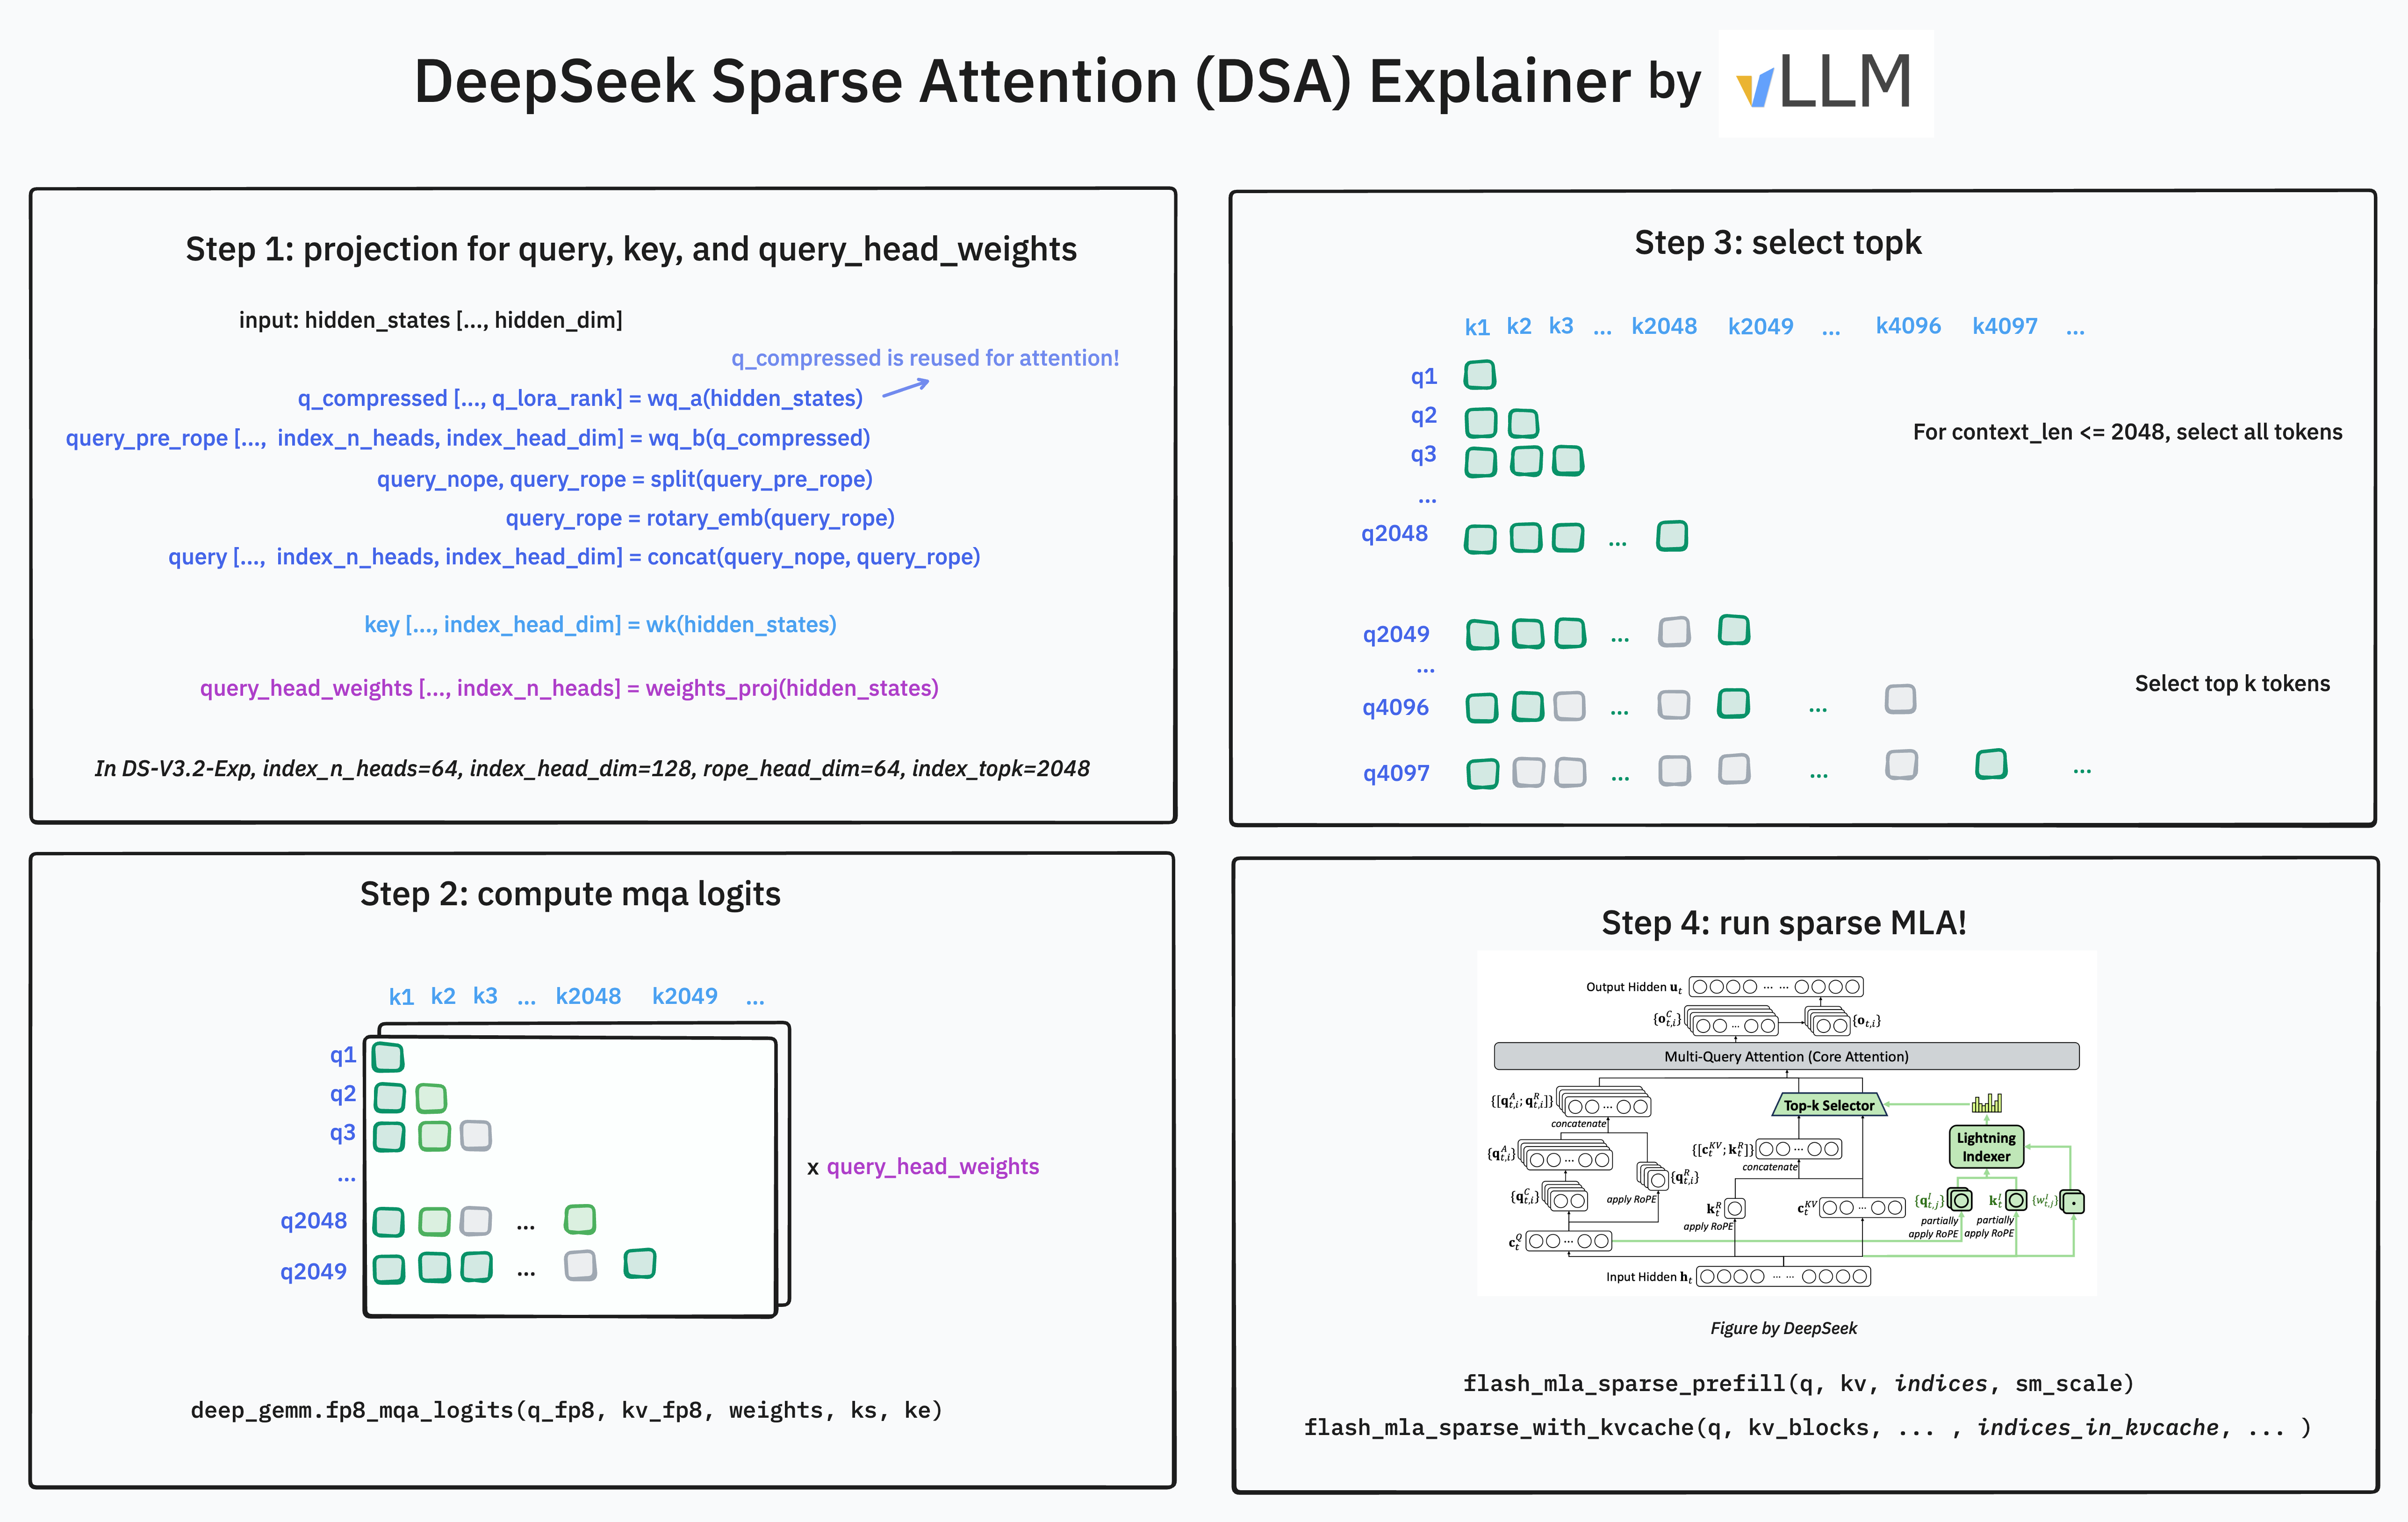
基于令牌的真实检测:面向生产大型语言模型的实时幻觉检测

HaluGate是一个基于令牌的条件性幻觉检测管道,旨在识别不支持的声明,解决大型语言模型在生产中的幻觉问题。通过提取工具调用的上下文,HaluGate实现快速、可解释的验证,确保用户获得准确的信息,避免传统方法的延迟和成本。

基于令牌的真实检测:面向生产大型语言模型的实时幻觉检测

vLLM Blog vLLM Blog · 2025-12-14T00:00:00Z
评估评估指标——幻觉检测的幻影

本文探讨了语言模型中的幻觉检测评估指标,指出现有指标与人类判断不一致,且在参数扩展时表现不稳定。通过对6种幻觉检测指标的实证评估,发现LLM(如GPT-4)在评估中表现最佳,模式寻求解码方法能有效减少幻觉。这强调了需要更强大的指标和策略来理解和减轻幻觉问题。

评估评估指标——幻觉检测的幻影

Apple Machine Learning Research Apple Machine Learning Research · 2025-10-27T00:00:00Z
分离安全适配器实现高效的安全防护和灵活的推理时对齐

现有的AI安全保障方法常常在推理效率与开发灵活性之间妥协。我们提出了分离安全适配器(DSA),通过解耦安全计算与任务优化模型,显著提升幻觉检测和仇恨言论分类的性能,同时允许动态调整对齐强度,从而增强AI的安全性与灵活性。

分离安全适配器实现高效的安全防护和灵活的推理时对齐

Apple Machine Learning Research Apple Machine Learning Research · 2025-06-27T00:00:00Z
视频幻觉检测器:评估大型视频语言模型中的内在和外在幻觉

当前模型在外部幻觉检测方面存在显著问题,尤其是动态内容的识别。现有方法未能有效处理视频幻觉检测。为此,提出了Self-PEP框架以改善这一问题。

视频幻觉检测器:评估大型视频语言模型中的内在和外在幻觉

DEV Community DEV Community · 2025-05-23T00:17:28Z

该研究提出RePPL方法,旨在提升大型语言模型在幻觉检测中的解释能力。通过重新校准不确定性测量,提供可解释的标记级不确定性分数。实验结果显示,该方法在问答数据集上表现优异,揭示了幻觉的混乱模式,具有广泛的应用潜力。

RePPL: Recalibrating Perplexity through Uncertainty in Semantic Propagation and Language Generation for Explainable QA Hallucination Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-21T00:00:00Z

本研究通过引入不确定性量化模块,显著提升了大语言模型对不确定性的捕捉能力,增强了幻觉检测性能和可靠性评估。

One Head for Prediction, One Head for Scrutiny: A Pre-trained Uncertainty Quantification Head for Detecting Hallucinations in Large Language Model Outputs

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-13T00:00:00Z

本研究针对大语言模型在长上下文中生成虚假或矛盾信息的问题,构建了专门的数据集并提出了新架构,显著提高了幻觉检测的效果和推理速度。

Research on Long Context Hallucination Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-28T00:00:00Z

本研究提出了一种零资源幻觉检测框架,专门针对大型语言模型在医疗和金融等高风险领域的应用问题。实验结果显示,该方法在准确性和可靠性上优于传统检测手段。

Uncertainty Quantification in Language Models: A Suite of Black-Box, White-Box, LLM Evaluators, and Ensemble Scorers

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-27T00:00:00Z

本文介绍了一种新系统HDM-2,用于检测企业环境中大语言模型输出的幻觉,填补了研究空白。HDM-2结合上下文和知识验证,实验结果表明其优于现有方法,具有良好的实用潜力。

HalluciNot: Detecting Hallucinations through Context and Common Sense Verification

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-09T00:00:00Z

本研究提出了一种基于Transformer的分类器,旨在有效检测大型语言模型的幻觉现象。实验结果表明,该方法在长输入上下文中优于强基线,具有实际应用价值。

基于多视角注意力特征的幻觉检测

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-06T00:00:00Z

本研究提出了一种名为DASH(系统性幻觉检测与评估)的方法,旨在识别视觉语言模型(VLMs)在开放环境中的幻觉现象。研究表明,通过DASH优化特定图像微调,可以有效减轻VLM的对象幻觉问题。

DASH: Detection and Assessment of Systematic Hallucinations in Visual Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-30T00:00:00Z

本研究提出了一种名为ShED-HD的轻量级幻觉检测框架,旨在解决大型语言模型在高风险领域中产生幻觉的问题。该框架利用BiLSTM架构和单头注意力机制,提高了边缘设备上的幻觉检测性能,增强了生成内容的可信度。

ShED-HD: A Shannon Entropy Distribution Framework for Lightweight Hallucination Detection on Edge Devices

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-23T00:00:00Z

本文提出了MedHallu基准,用于检测大语言模型在医疗问答中的幻觉问题。基准包含来自PubMedQA的10,000对问答,研究表明现有模型在幻觉检测上存在不足,引入领域知识和“无确定答案”选项可显著提高检测精度。

MedHallu: A Comprehensive Benchmark for Detecting Medical Hallucinations in Large Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-20T00:00:00Z

本研究提出了HuDEx模型,旨在提高大型语言模型(LLM)在高事实精度领域的可靠性。HuDEx能够同时检测幻觉并提供详细解释,研究表明其在幻觉检测准确性上超越了Llama3 70B和GPT-4,并适应多种测试环境。

HuDEx: Integrating Hallucination Detection and Explainability to Enhance the Reliability of Large Language Model Responses

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-12T00:00:00Z
RAG幻觉检测技术

本文探讨了在检索增强生成(RAG)系统中检测幻觉的技术,重点介绍了三种主要方法:使用DeepEval库的幻觉指标、基于链式思维的G-Eval框架以及RAG特定的评估指标(包括忠实度评估)。通过实际代码示例,展示了如何量化和测量大型语言模型输出中的幻觉,并强调了生成响应与已知上下文或预期输出的比较。

RAG幻觉检测技术

MachineLearningMastery.com MachineLearningMastery.com · 2025-01-09T16:07:10Z
基于命名实体识别的准确幻觉检测

我们通过命名实体识别(NER)和关键词检测解决了幻觉检测问题,准确率达到67%。该系统快速、简单,适用于实时应用和低资源环境,能够有效识别虚假实体和错误数字。未来计划包括智能实体识别和改进数字处理。

基于命名实体识别的准确幻觉检测

DEV Community DEV Community · 2025-01-08T01:01:53Z

本研究提出了一种监督学习方法,用于检测大型语言模型中的幻觉。通过分析LLaMA模型的标记分数,提取特征以减少过拟合,并使用逻辑回归进行分类。结果在TruthfulQA和MMLU数据集上显示出显著的性能提升,具有良好的有效性和推广潜力。

Improvements to the Hallucination Classifier CHAIR-Classifier

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-05T00:00:00Z

本研究提出VERITAS模型,旨在解决大型语言模型在知识密集型环境中的不可靠性问题,显著提升幻觉检测的性能,并降低延迟和成本。

VERITAS: A Unified Reliability Assessment Method

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-05T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码