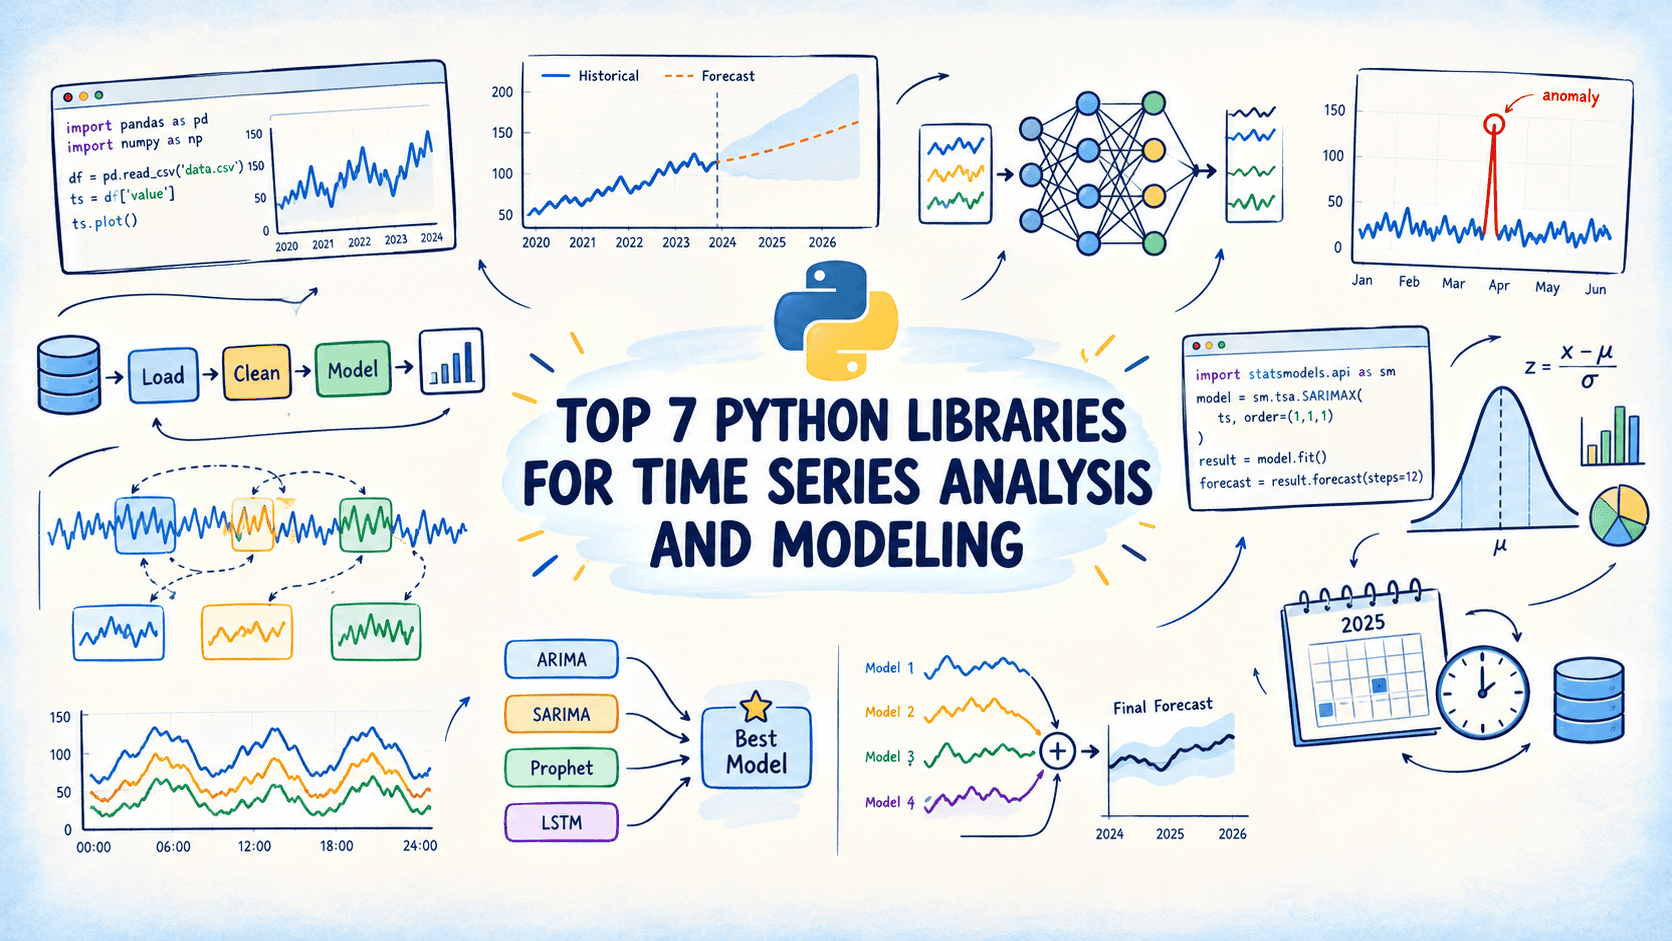
文章介绍了七个Python时间序列库:statsmodels用于可解释的ARIMA等统计建模;pmdarima自动搜索ARIMA阶数;sktime提供统一的机器学习接口与防泄漏交叉验证;Darts支持概率预测、多序列全局模型及异常检测;stumpy通过矩阵轮廓发现模式和异常;PyOD汇集60多种异常检测算法;NeuralForecast提供30多种深度学习预测架构。建议在同一数据集上对比使用这些库。
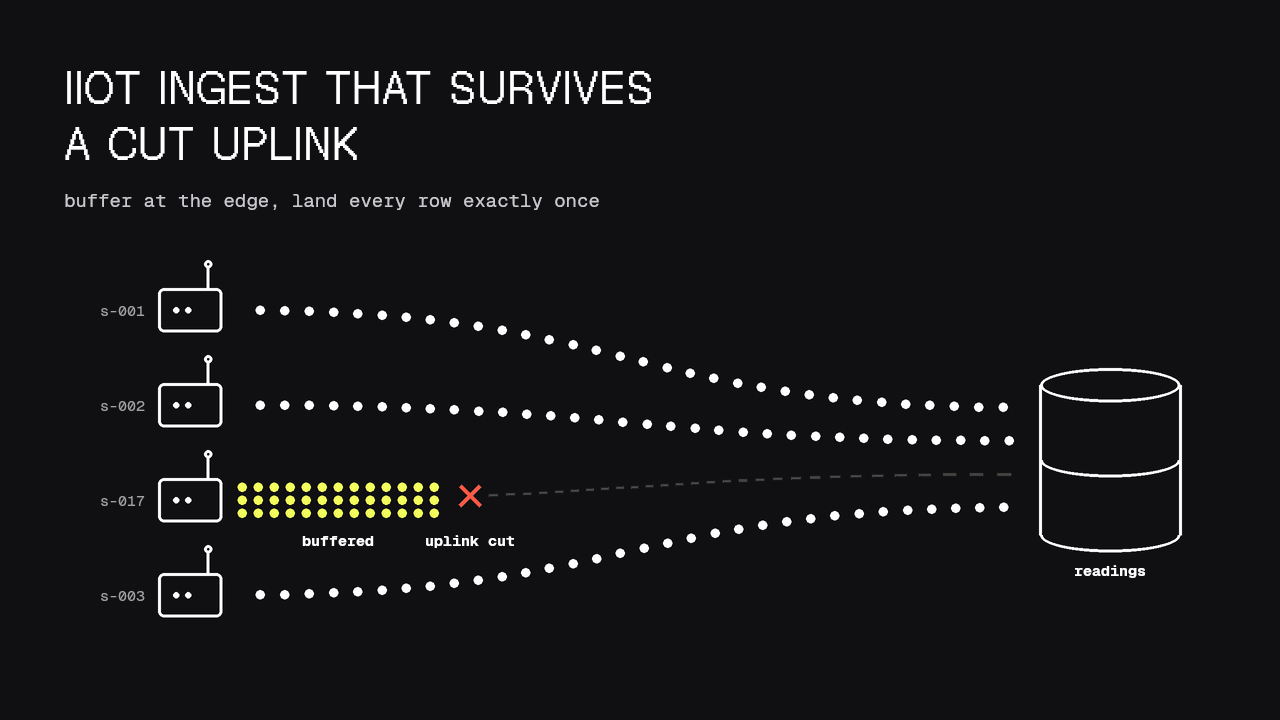
文章探讨工业物联网数据摄取与PostgreSQL运维:设计在上行链路中断时仍能存活的摄取方案,要求校验每条读数的身份、在边缘持久缓冲,并限制重放以免补传挤占实时站点;用SQL构建摄取安全监控,每分钟采样WAL量、副本延迟和死元组,得出可告警的余量百分比;记录查询延迟与行数的关系并拟合曲线,预测查询何时超出目标。
判断整数数组是否为二叉搜索树后序遍历序列的方法:序列末尾元素为根结点;从头查找第一个大于根结点的元素,作为右子树起点;验证右子树所有元素均大于根结点,否则返回false;再递归判断左右子树,均满足则返回true。
文章介绍判断一个序列是否为给定栈压入序列的合法弹出序列的方法:假设元素互不相同,按压入顺序模拟入栈,若栈顶元素等于弹出序列当前元素则出栈并推进弹出序列;全部压入后仍不匹配则序列非法。文中以压入序列12345为例,弹出序列45321合法,43512不合法。
华盛顿大学与NVIDIA等提出RFD4-Proteina,这是首个面向多组分生物大分子复合物的潜空间推理序列-结构联合生成模型。该模型构建统一的化学-构象潜空间,结合流匹配生成与内在/外在双重推理,并用可微Rosetta能量约束原子重构,突破了分子类型窄、序列-结构解耦、伴侣刚性等瓶颈。基准测试中其设计成功率与效率显著优于基线,湿实验验证了高特异性结合蛋白、糖基化与磷酸化识别,并首次从头设计出催化药物合成反应的酶。
PlanetScale 的分片 Postgres 系统 Neki 通过路由器集中执行序列操作,以保证跨分片唯一性。文章区分三类表达式:不可变、稳定(如 now(),在路由器求值一次)、易变(如 nextval(),须按行基数逐行求值)。Neki 先获取表表达式,再在路由器上叠加序列求值,将唯一值下发各分片完成更新。
statsmodels 拟合模型除点预测外还提供更多信息:用 get_forecast 可直接获取预测区间,无需手动计算;append 能在不重新拟合的情况下加入新数据并默认复用已有参数;STLForecast 将 STL 分解与 ARIMA 预测整合,避免手动还原季节性时的错误。这些内置方法比手写实现更短、更快、更准确。
DeepSeek-V4.1 采用分层稀疏索引器降低解码开销:第20层先全量打分,选出最多16384个候选位置,后续Reindex层仅在候选池内打分,使计算量与上下文长度无关。同时,main KV改用FP4存储,每token从584字节压缩至288字节,并结合跨层共享,全局KV总量从V4-Flash的3514字节降至890字节。
DeepSeek-V4.1 的 CSA2 通过跨层共享压缩全局 KV,将 KV cache 从每 token 5.41 条降至 2.5 条。每层全局注意力包含 main KV、indexer K、top-k 索引和注意力四部分,前三者可跨层共用,形成 Full、Reindex、Reuse 三种模式:Full 自建 KV 并选索引,Reindex 复用 KV 但重选索引,Reuse 两者均复用。38 层中仅 4 层为 Full,压缩算子去除了重叠与位置偏置,indexer K 改由 main KV 投影。
DeepSeek-V4.1 借鉴 YOCO,提出 CED 结构:decoder 的全局 KV 由 encoder 末态投影得到;prompt 中多数 token 只计算前 20 层,激活参数约 8B,而 decode 阶段使用全部 40 层,约 16B。为补充 decoder 滑窗 KV,采用 Decoder SWA Bounded Replay,仅回放最后 128 个 token,属于近似重建,但开销远低于精确重建。
VLX-Seek是OmAI Lab推出的细粒度视觉语言模型,面向机器人、无人机等边缘具身视觉场景,结合语言理解与区域级视觉感知,支持目标定位、指代理解、区域OCR、描述与计数,并引入目标缺失拒识机制,为具身智能连接环境感知与行动决策提供基础能力。
SimpleDesign是一种多模态蛋白质设计模型,无需多阶段训练,直接在数据空间端到端训练,结合序列交叉熵与结构回归目标,采用Transformer多模态骨干,在超200万序列-结构对上训练,在协同设计和无条件生成任务上表现优异。
本文详解DeepSeek-V4模型结构:HCA将128个token压缩为一条目,无需稀疏选择;CSA与HCA交错排布,确保全局信息不丢失;滑窗分支弥补压缩导致近token不可见;Q/KV归一化替代QK-Clip;部分RoPE加输出反旋转消除绝对位置;attention sink解决softmax权重分配缺陷;1M上下文KV cache仅5.3GiB,FLOPs约38G。
本文介绍DeepSeek-V4模型中的压缩稀疏注意力(CSA)机制。KV缓存每4个token压缩为一条,1M上下文仍有26万条目,故用lightning indexer打分选择top-1024块。Indexer源自V3.2的DSA,采用64头128维、ReLU加权和FP4量化,通过KL散度模仿主注意力分布训练。V4将索引对象从token改为压缩块,query共享低秩latent。文章详述了indexer实现细节、一层CSA的完整维度流程及参数统计。
本文介绍DeepSeek-V4的注意力机制,从MHA到CSA/HCA的演进,重点分析压缩KV缓存的方法。V4将每4或128个token压缩为一条512维KV向量,采用重叠窗口和逐通道softmax加权,K与V共享单头,配合分组输出投影降低参数。相比前代,V4首次压缩缓存条目数,以支持1M上下文的高效推理。
本文介绍Kimi K3模型结构:采用3:1混合,每四层含一层Gated MLA(无位置编码、满秩sigmoid门),其余为KDA层。MLA低秩压缩KV至576维/token,KDA状态固定约232MB。3:1比例经实验选为质量与吞吐平衡点,1M上下文时KV cache约27.6GB,decode速度约为纯MLA的2.2倍。
本文介绍Kimi K3模型序列维度的chunkwise并行算法:将序列分块,块间递推状态、块内用矩阵乘并行计算。K3将每步log-decay加−5下界,使16-token对角tile也能用BF16矩阵乘,消除FP32逐位置对瓶颈。相比通用DPLR内核,KDA内核因结构简化速度快约一倍。训练和prefill用chunkwise形式,decode用递推形式。
本文介绍Kimi K3模型中KDA(Kimi Delta Attention)的递推形式,从线性注意力、DeltaNet到Gated DeltaNet演进而来。KDA通过逐通道衰减和擦除写入机制更新状态,每头128×128矩阵,不依赖上下文长度。它采用逐头RMSNorm和满秩sigmoid输出门,在合成任务中表现优于基线,并天然具备位置编码能力。
制造业IIoT产生高频传感器数据,传统数据库难以处理。文章指出五大趋势及数据层解决方案,并举例说明TimescaleDB如何优化PostgreSQL,实现存储减少83%、查询提速979倍,解决工业4.0数据挑战。
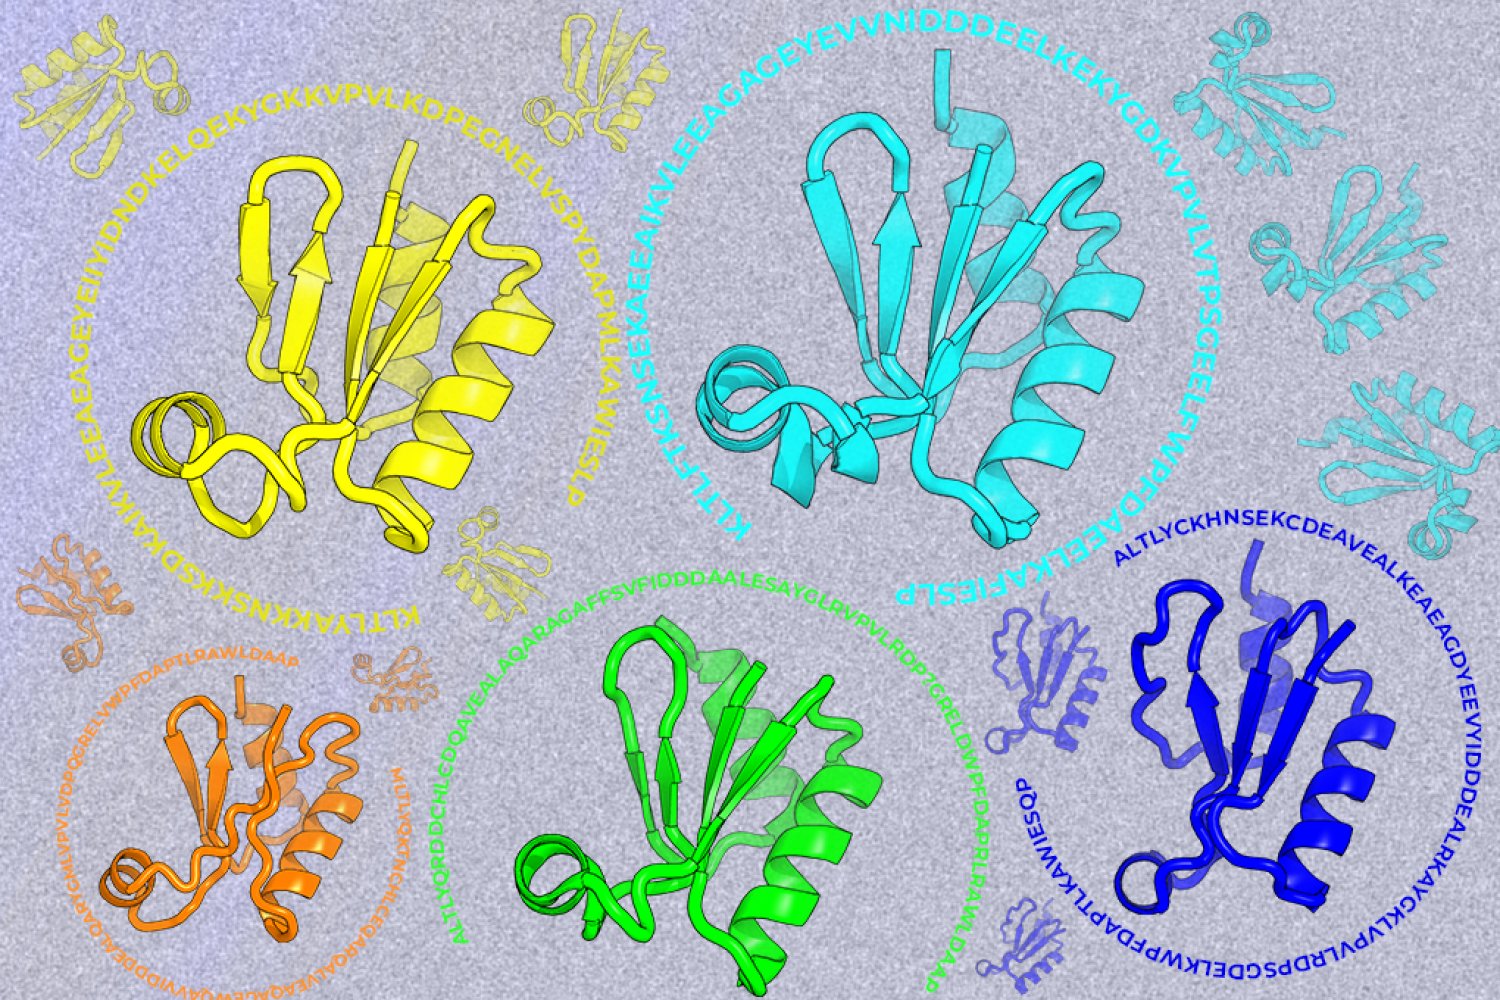
MIT团队开发了名为PottsMPNN的机器学习框架,用于改进计算蛋白质设计。该框架结合物理原理,能更准确建模序列-能量关系,生成结构可行但序列新颖的蛋白质,避免过度模仿天然序列。研究强调,传统以复现天然序列为成功标准并不最佳,PottsMPNN通过引入成对氨基酸相互作用和进化信息,提升了结构兼容性和突变稳定性预测,为设计新型蛋白质奠定基础。
完成下面两步后,将自动完成登录并继续当前操作。