公开基准仅反映模型最优表现,无法保证生产环境中的稳定准确。Nebius的Wang建议结合内部基准与真实工作流评估开源模型,并关注整个推理栈,包括缓存命中率、吞吐与并发、P95/P99延迟和首字延迟。模型并非越大越好,应平衡精度与规模,必要时拆分任务或微调小模型。
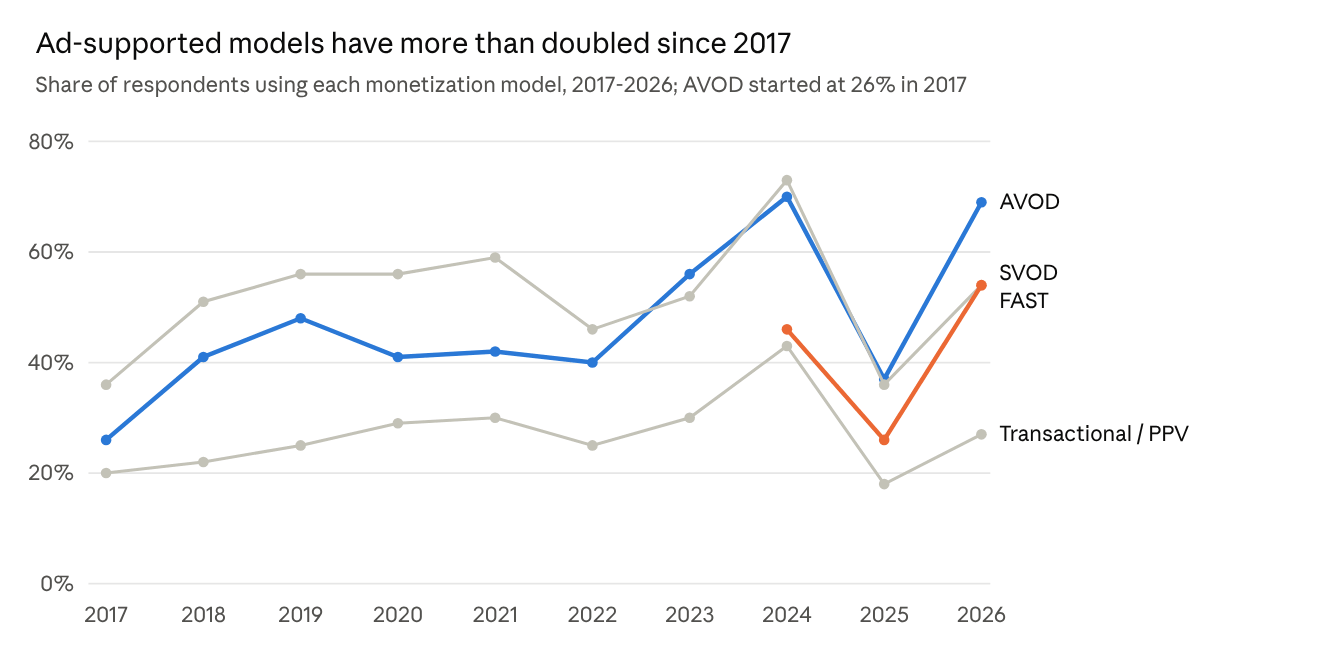
Bitmovin十年报告揭示视频行业趋势:广告变现成为主流,订阅模式预计2024年见顶;AI应用中语音转写持续领先,生成视频仅占18%;QoE指标从启动时间转向缓冲和错误率;亚秒级分发需求从25%降至8%,SRT领跑直播回传,自建CDN减少。团队注意力正从基础设施转向广告、AI和QoE数据。
本文评测12款AI实时翻译工具,涵盖消费应用、会议插件、活动平台和开发者API。Palabra.ai、Gemini、Apple适用于对话与旅行;DeepL、Teams、JotMe、Talo适用于会议;Wordly、Interprefy、KUDO适用于大型活动;Boostlingo适用于医疗、法律等高风险场景。选择时需考虑延迟、语言数量、平台和价格。
irtt 是专业网络延迟波动检测工具,按固定间隔发送 UDP 包,统计 RTT、单向延迟、抖动和丢包,比 ping 精确,适合长时间稳定性测试,能模拟实时业务流量。支持 Alpine 安装或静态交叉编译,输出详细统计与丢包率。
直播码率阶梯需兼顾观众终端、片源、兼容性、延迟与成本。固定阶梯易浪费码率,内容感知决策更优。延迟是全链路预算,分片与随机访问点须严格对齐。封装与DRM应纳入播放设计。规模化下需结合播放与运维指标,AI可辅助搜索但需保留护栏。每档都应挣得其位置。
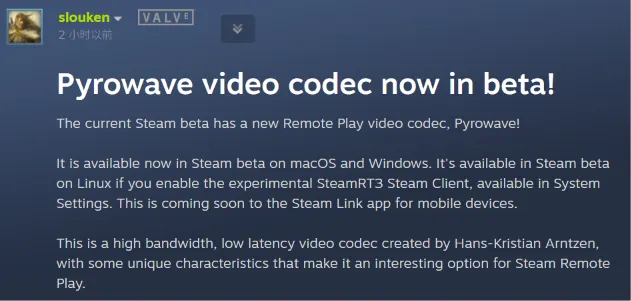
Valve在Steam测试版中推出实验性视频编解码器Pyrowave,由VKD3D-Proton开发者Hans-Kristian Arntzen打造,支持Windows、macOS和Linux。其带宽是其他流媒体编解码器的5到10倍,适合千兆局域网,基于Vulkan API,延迟极低,支持HDR和YUV 4:4:4,可在Steam远程游玩高级设置中启用。
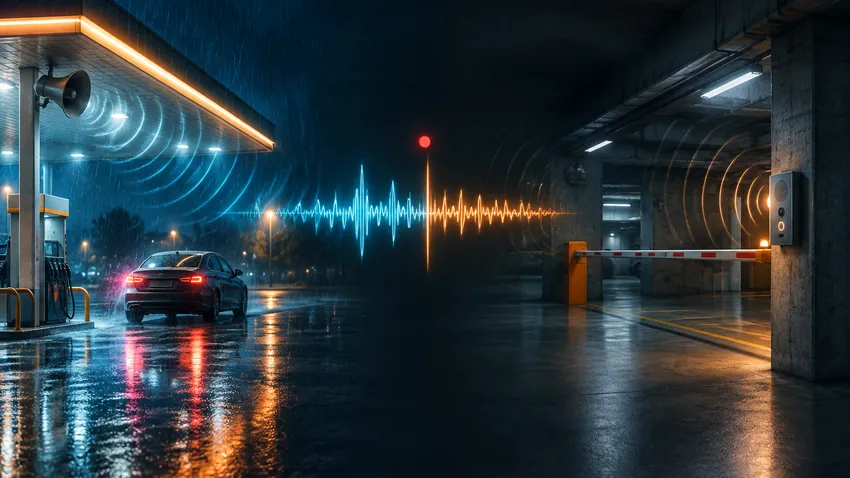
远程喊话的关键是让对方立刻照做,而非仅听得清。三大优先级:延迟压到300毫秒内以形成对话感;喇叭功率与安装位置决定威慑力,降噪算法无法弥补声压不足;录音截图默认开启以留存证据。加油站与停车场噪声、混响条件不同,硬件方案不可照搬,应先定麦克风与扬声器选型点位,再调降噪参数。
AI代理进入生产环境后,基础设施决定其延迟、可靠性和成本。代理工作流是多轮工具调用,步骤串行依赖,任一环节慢都会拖累整体。其需求呈突发性,GPU利用率波动大,传统按平均负载配置易导致p99延迟飙升和成本失控。因此代理需要专为长依赖链、突发需求和持续演进设计的基础设施。
看画面与喊话是两类业务:看画面用HLS等CDN分发,成本优先;喊话须走RTC,延迟优先。TCP重传导致队头阻塞,延迟随丢包非线性上升,不适合喊话。HLS、HTTP-FLV为单向,无反向音频通道。实际项目常两套并存,仅对喊话那路补RTC。纯看画面、无强实时联动时,继续用HLS更经济。
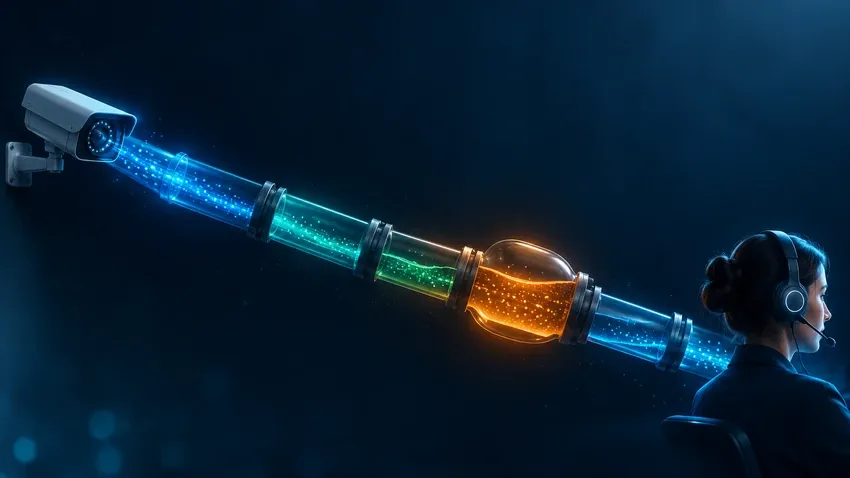
云值守延迟由采集编码、边缘预处理、上行、云端转发、下行、坐席渲染六段组成,并非单纯网络慢。看画面与喊话应分开定指标:喊话需压到300毫秒内,看画面可放宽至1秒。优化前应实测各段延迟,明确归属方与代价,避免只换专线或盲目压延迟。延迟与卡顿不可兼得,应按业务分配预算。
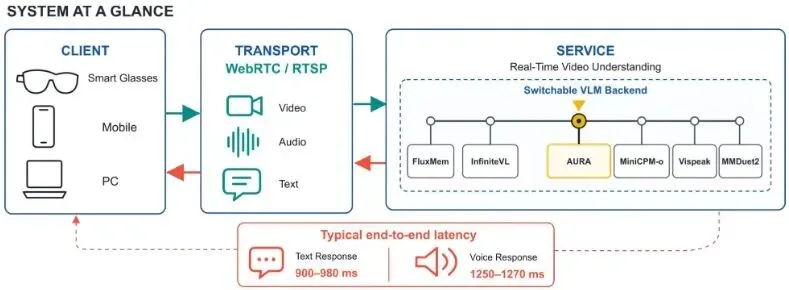
本文提出一套低延迟边云系统,集成六种流式视频VLM后端,共享ASR/TTS与统一编排,支持实时语音交互。实验显示,在合适后端与WebRTC传输下,首句VLM文本延迟约0.9–1.0秒,首段TTS音频约1.3–1.5秒。研究表明实时视频理解是分层系统问题,VLM到TTS交接尤为关键,低首token延迟并不保证快速语音响应。
OpenAI披露Habitat存储平台,每秒处理超7000万请求、500PB数据,支撑10亿周用户。该平台从Python客户端库演变为统一服务,2026年用Rust重写后CPU效率提升6倍、内存效率提升15倍。文章指出AI产品瓶颈常在数据层,应优先优化P95/P99延迟、限流降级与缓存一致性,而非只关注模型。
本文介绍如何使用Visual Studio性能分析器定位分布式.NET应用中的跨进程性能瓶颈。通过Interview Coach示例,作者发现Blazor前端在流式响应中每更新一次就执行Task.Delay(50),导致累积等待约10秒。移除该延迟后,响应时间显著改善。文章强调先确定问题进程,再判断是计算还是等待,并建议用合并UI刷新替代固定延迟。
RTC推流延迟比较需关注整条链路而非单一数字,受协议、网络环境影响。头部厂商如即构(ZEGO)在理想环境下延迟约79-300ms,但真实差异体现在弱网、跨洲和拥塞时,比拼抗丢包、节点覆盖和调度能力。建议用两周实测,控制变量,覆盖关键地区,取分位数对比,而非依赖官网数据。
研究显示,体育直播延迟虽令观众不满,但若平台提供完整回放、多角度或个性化集锦等增值功能,观众愿接受延迟。调查中54%的体育迷愿为高级功能付费,Z世代达80%。未来观众期望多设备切换、控制广告量及即时集锦。专家强调,平台需灵活应对商业模式变化,实时传输赛事。
本文介绍一款在线逻辑门延迟计算工具,用于分析数字电路时序。用户可输入传播延迟、上升/下降时间、级联门数量及负载电容,计算总延迟、平均上升时间、最大工作频率和延迟-功耗积。工具提供CMOS典型延迟参考、预设工艺场景,并说明传播延迟定义及影响因素,辅助电路性能评估。
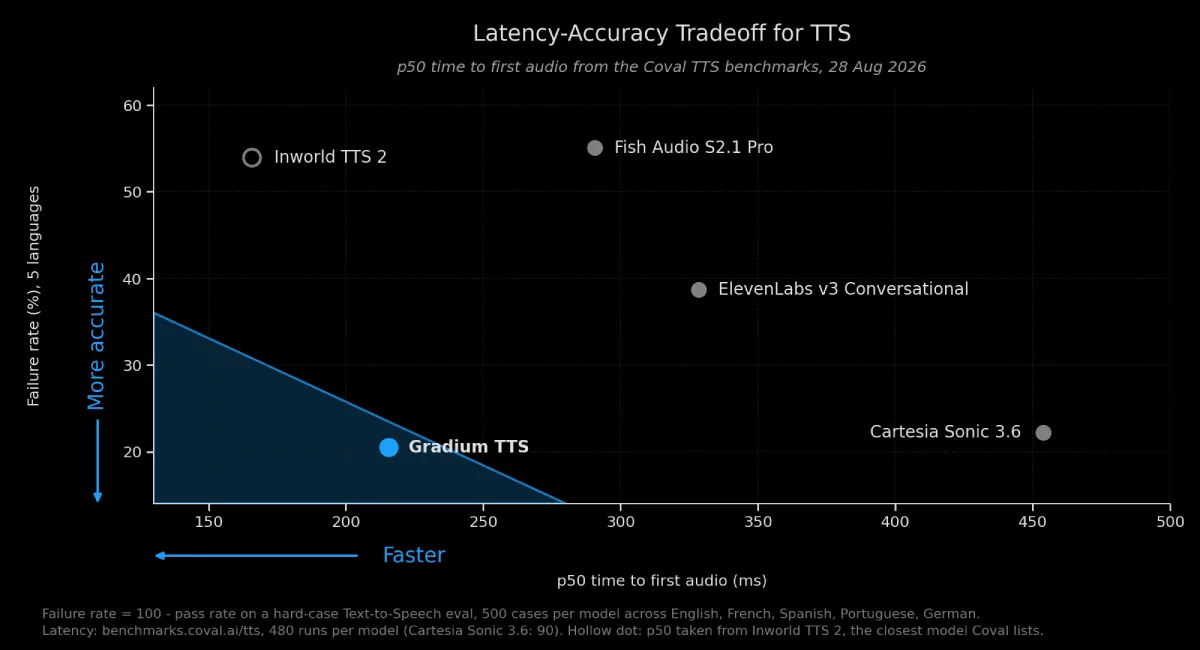
Gradium AI发布新TTS模型并设为默认,在500句难例测试中人工评分通过率81%,领先Cartesia和ElevenLabs。首音频延迟216毫秒,低且稳定。支持多语言,无需文本归一化即可准确朗读号码和邮箱。基准测试由厂商运行,评估集已开源。
本文探讨语音智能体延迟指标,指出TTFT(首Token时间)仅是起点,真正影响体验的是TTFS(首句时间)。文章基准测试了LLM、STT、TTS及语音到语音各层,强调需结合TTFT和输出速度评估,并给出约700ms的LLM预算参考。关键建议包括同区域部署、限制推理努力、预留工具调用预算,以及关注p95尾部延迟而非仅p50。
TAG Video Systems将在IBC2026展示实时非压缩制作新性能,包括ST 2110流延迟降至两帧内、支持800 Gbps聚合带宽,并扩展MXL互操作性。新增音频、色彩、HDR质检工具及Dolby Vision检测,助力直播制作实时监控。
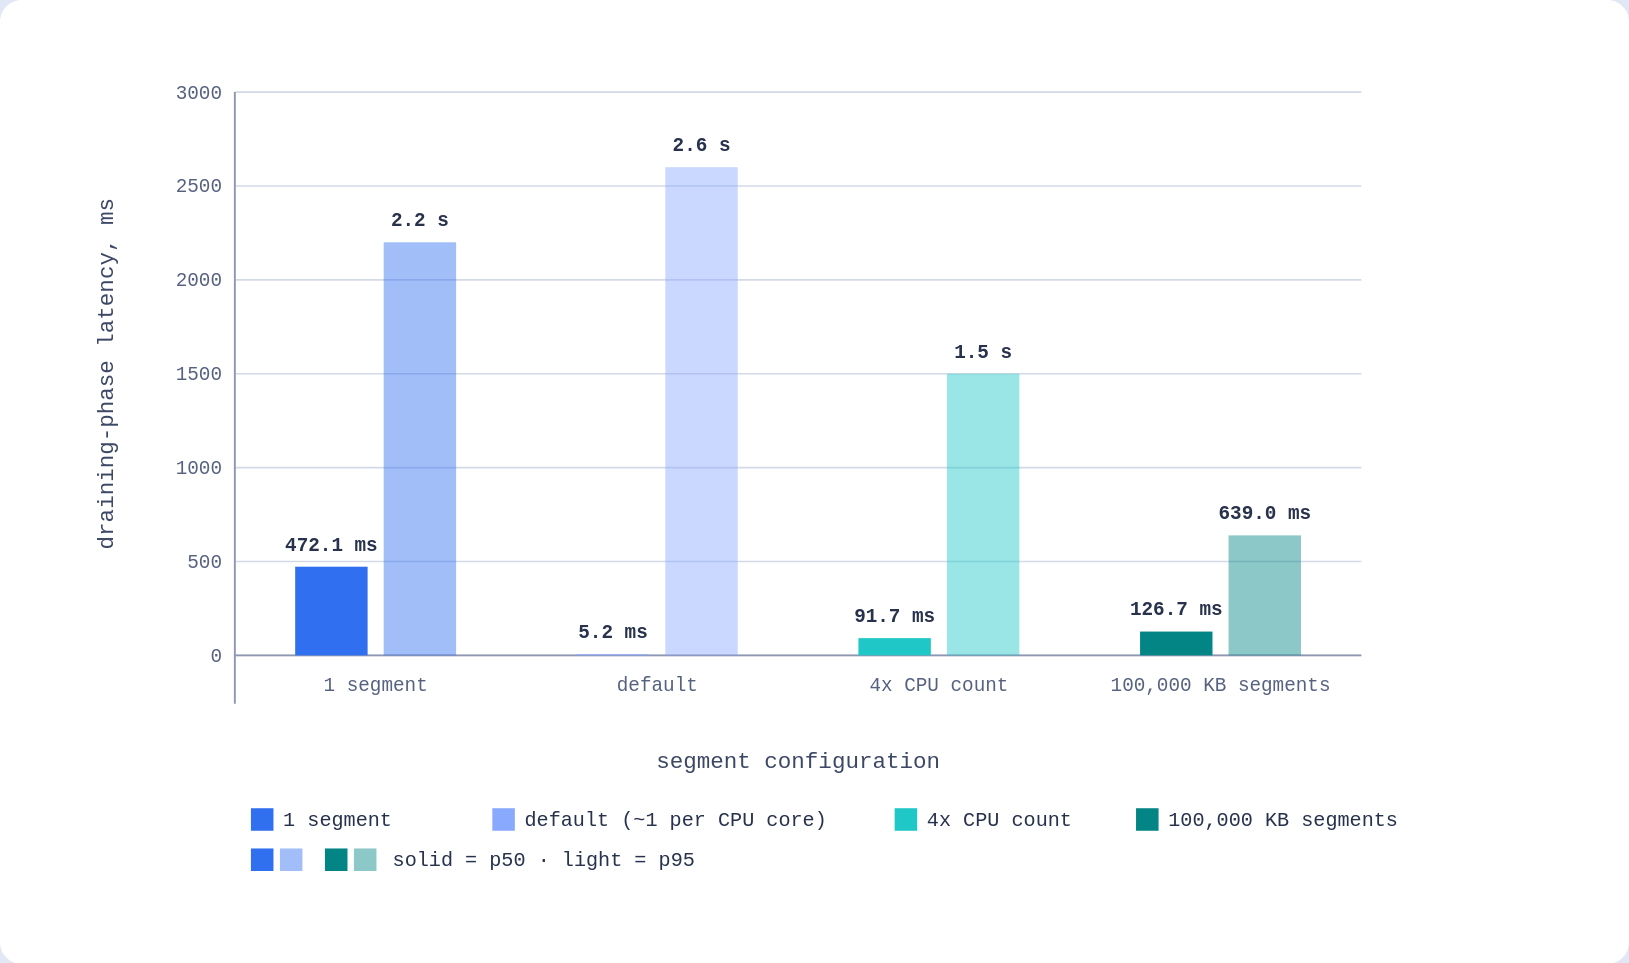
本文通过基准测试,量化了Qdrant优化器配置对搜索延迟的影响。连续索引虽在加载后需恢复期,但稳态延迟可降180倍;启用prevent_unoptimized能大幅降低排空期延迟,但新点暂不可见。单段配置稳态最快但恢复慢,限制段大小则相反。串行化优化线程可平滑延迟但延长排空。提高删除阈值可避免真空干扰。建议根据负载权衡配置。
完成下面两步后,将自动完成登录并继续当前操作。