Xthings 为智能家居平台引入自然语言控制,基于 Amazon Bedrock AgentCore 与 Nova Lite,采用上下文预加载加异步下发的四段式架构,将模型调用从两轮减至一轮,受理延迟 P95 控制在 1 秒内,MVP 两三周投产。文章还分享了 UUID 白名单校验、别名权威来源、长期记忆写入治理等经验,并指出敏感动作执行层校验仍待补齐。
NVIDIA公布HSTU推荐部署流程,采用PyTorch AOTI编译、FlexKV缓存与Dynamo-Triton服务,八层模型满命中时延迟最高改善5.93倍,但收益取决于用户历史前缀复用率,50%命中时加速不足2倍。建议先验证输出一致性,再测试各命中率下的延迟、缓存失效与显存淘汰,并将推荐质量纳入验收,按每千次请求节省的GPU毫秒决策。
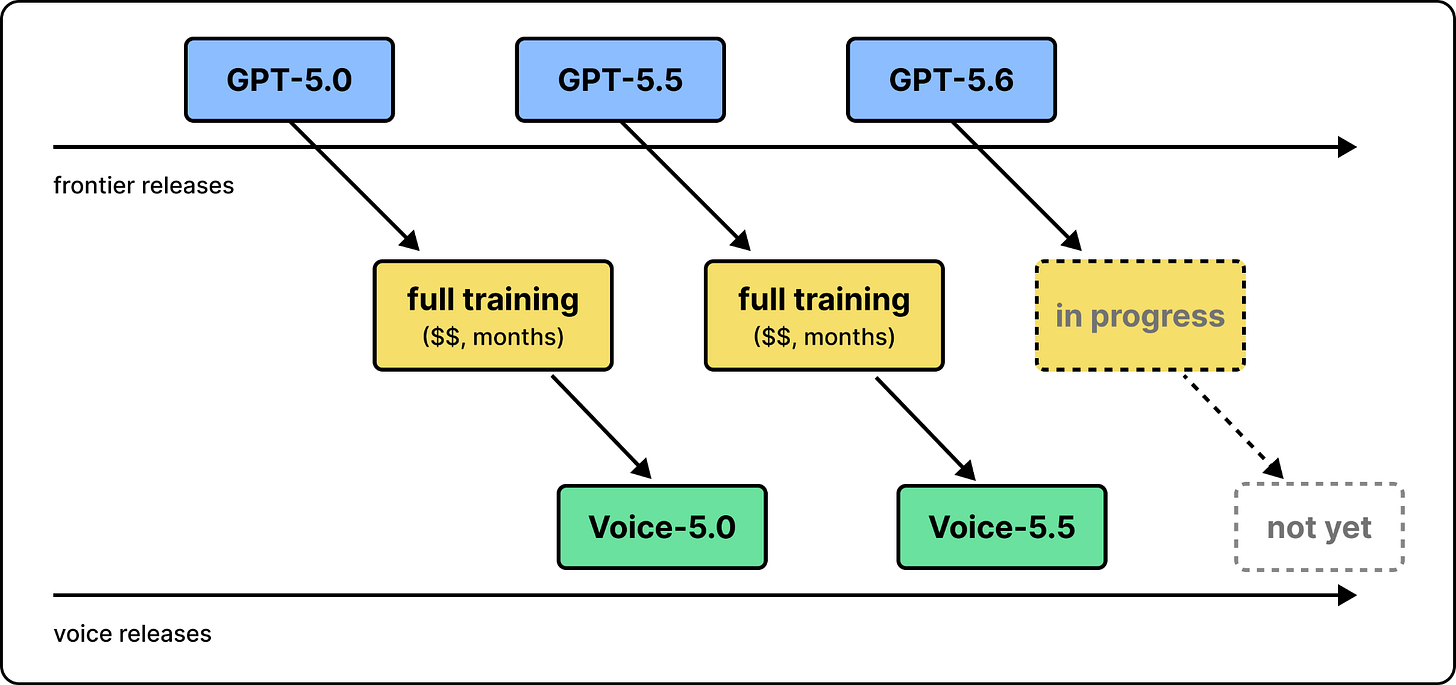
OpenAI的GPT-Live-1采用全双工架构,可边听边说,取消轮次检测,使对话更自然。系统将说话与思考分离:小型语音模型负责实时对话,前沿模型处理推理与工具调用。服务分实时音频路径和异步路径,并通过WARP、GPU状态保持、实例交接等优化延迟。评估关注对话行为、流健康与真实流量,需按p999设计。
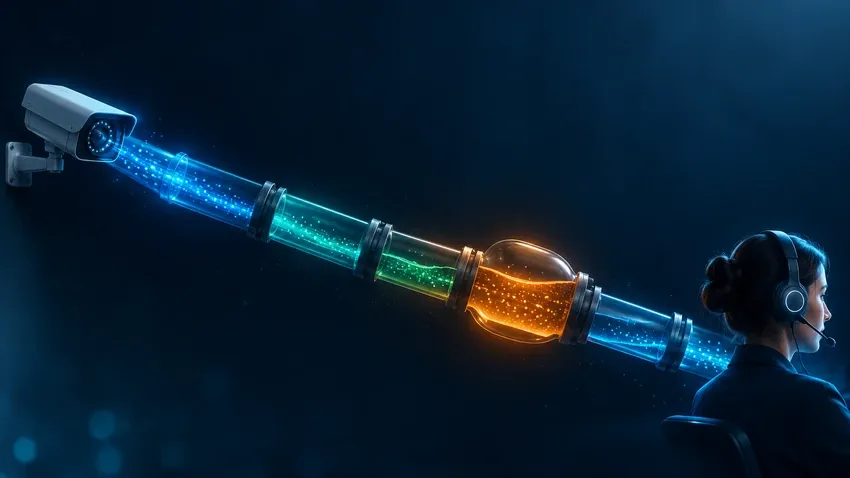
云值守延迟由采集编码、边缘预处理、上行、云端转发、下行、坐席渲染六段组成,并非单纯网络慢。看画面与喊话应分开定指标:喊话需压到300毫秒内,看画面可放宽至1秒。优化前应实测各段延迟,明确归属方与代价,避免只换专线或盲目压延迟。延迟与卡顿不可兼得,应按业务分配预算。
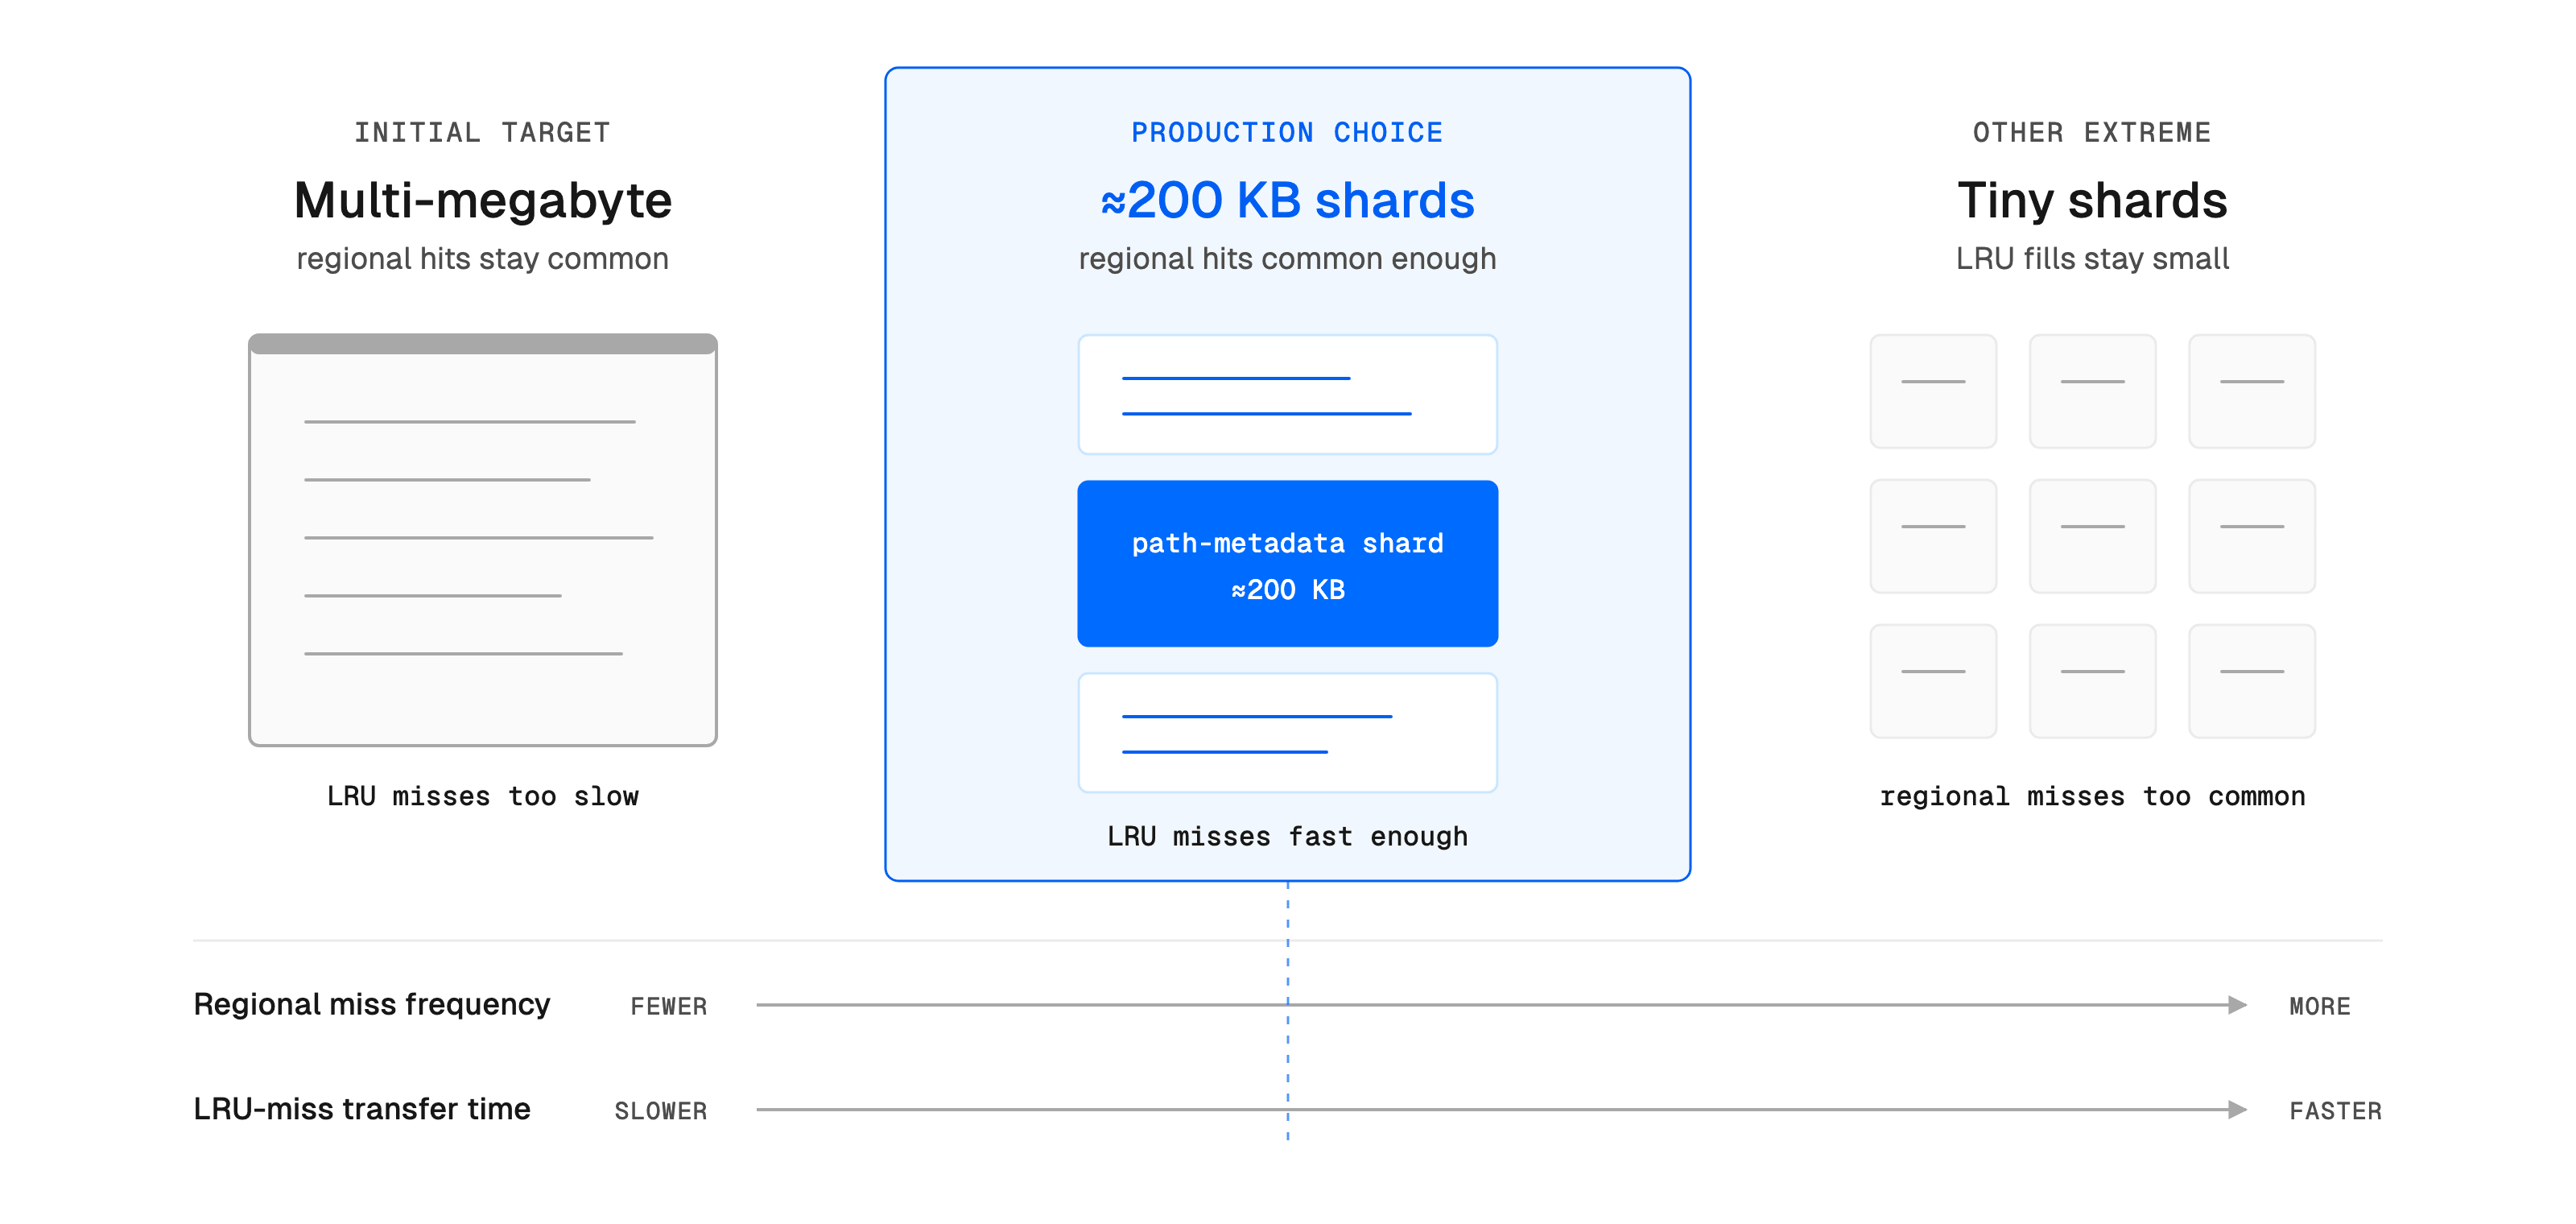
Vercel CDN每秒处理超8000万次路由查询,原按路径逐个获取元数据导致大型站点缓存频繁失效。团队将元数据分组为约200KB的索引分片,一次获取即可缓存多条路径,并支持二分查找。生产测试显示P99查找延迟降低91%,平均延迟降低79%,部署速度提升约10%。
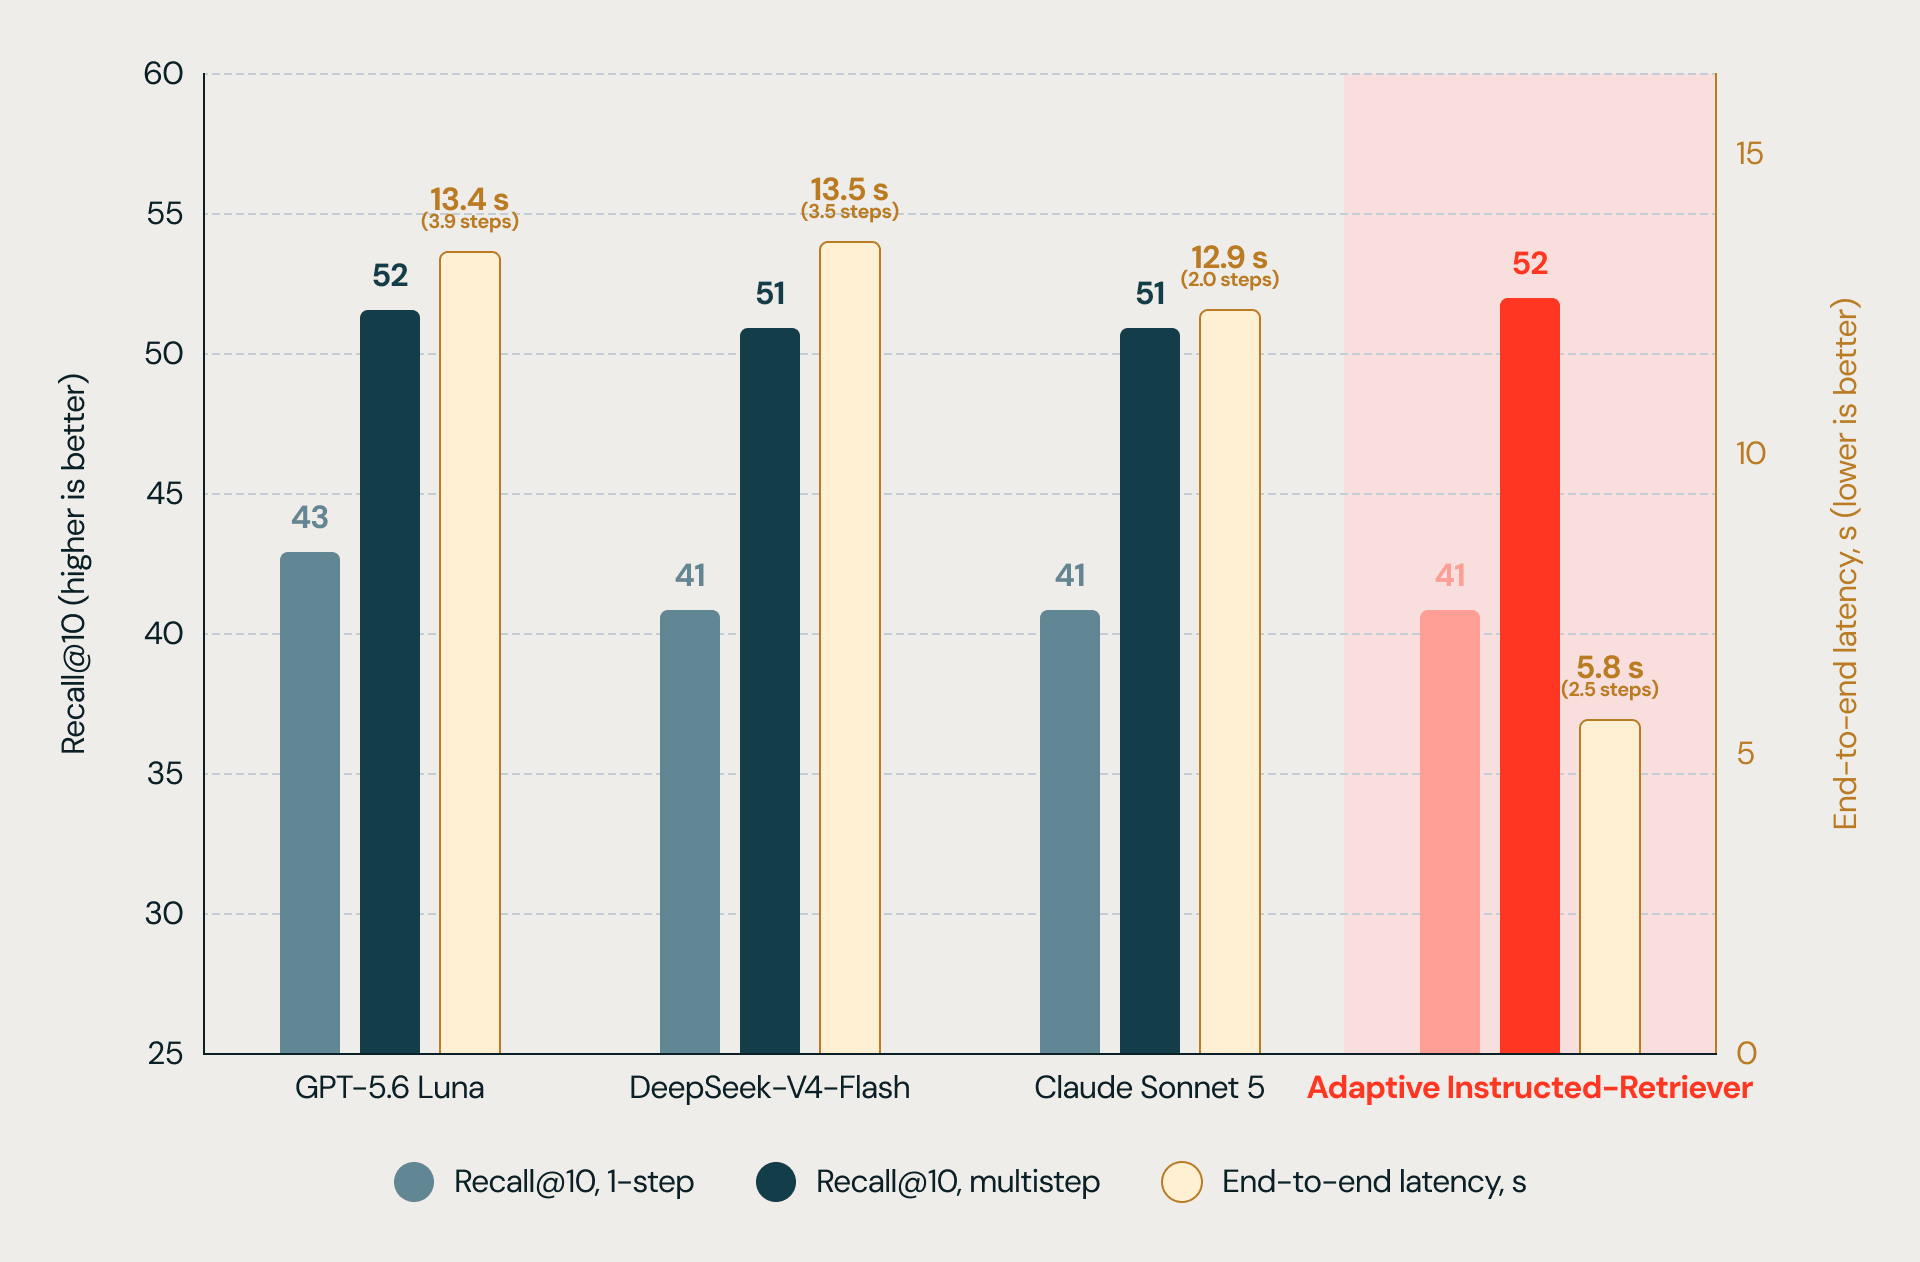
Databricks推出自适应指令检索器,结合并行与顺序搜索,根据查询复杂度动态调整步骤,平衡质量与延迟。训练采用在线强化学习,优化步骤惩罚,实现2倍低延迟且性能媲美顶级模型,适用于企业数据代理场景。
Vercel Sandbox公共域名请求路由速度提升18倍,通过sandbox.domain()创建的域名现从最近区域副本解析,延迟从62ms降至3.4ms,远距离地区查询速度提升显著,自动应用于所有沙箱域名请求,无价格变动。
本文探讨了小型语言模型(SLM)在窄自动化任务中的优化,重点介绍了约束输出空间技术。通过直接评分候选标签而非生成自由文本,该方法消除了解析错误,降低了延迟(例如处理600条工单的时间从134秒降至94.5秒),并提供置信度分数以支持人工复核。该技术使SLM成为固定输出场景下高效的生产选择。
本文介绍通过参数化查询模板缓存降低Text2SQL延迟的方法。系统将SQL查询泛化为模板,用语义搜索匹配用户问题,命中时跳过LLM生成,直接执行查询。生产部署中,缓存命中率达60%,端到端延迟降低80%,token消耗减少超50%,并支持强化学习持续扩充缓存。
Anthropic工程师发现,将AI大脑与执行环境紧耦合会导致失败传染、扩展受限和启动延迟高。他们采用事件溯源日志解耦,会话独立持久化,工具通过execute接口调用,Harness无状态化。新架构使p50启动延迟降60%,p95降90%,凭证安全隔离,支持水平扩展,如同操作系统抽象,让AI系统更稳定可规模化。
本文阐述音视频同步(A/V同步)的原理与实现,指出采集、编码、网络、渲染等环节均可能引入偏差。核心采用“音频主时钟”策略,视频追赶音频,通过PTS比较判定渲染、等待或丢帧。提供C核心代码及Swift封装,并给出PTS生成规范、调试工具和实战案例,最终将180ms偏差降至10ms内。
本文探讨音频编码中常被忽视的问题,指出AAC默认参数导致延迟高、文件大及低端设备爆音。对比AAC-LC与Opus特性,推荐按场景选型,并提供用Claude Code生成的iOS和Android双端AAC编码封装代码,涵盖参数配置、错误处理及Opus跨平台实现,强调实时通话应优先采用Opus以降低延迟和码率。
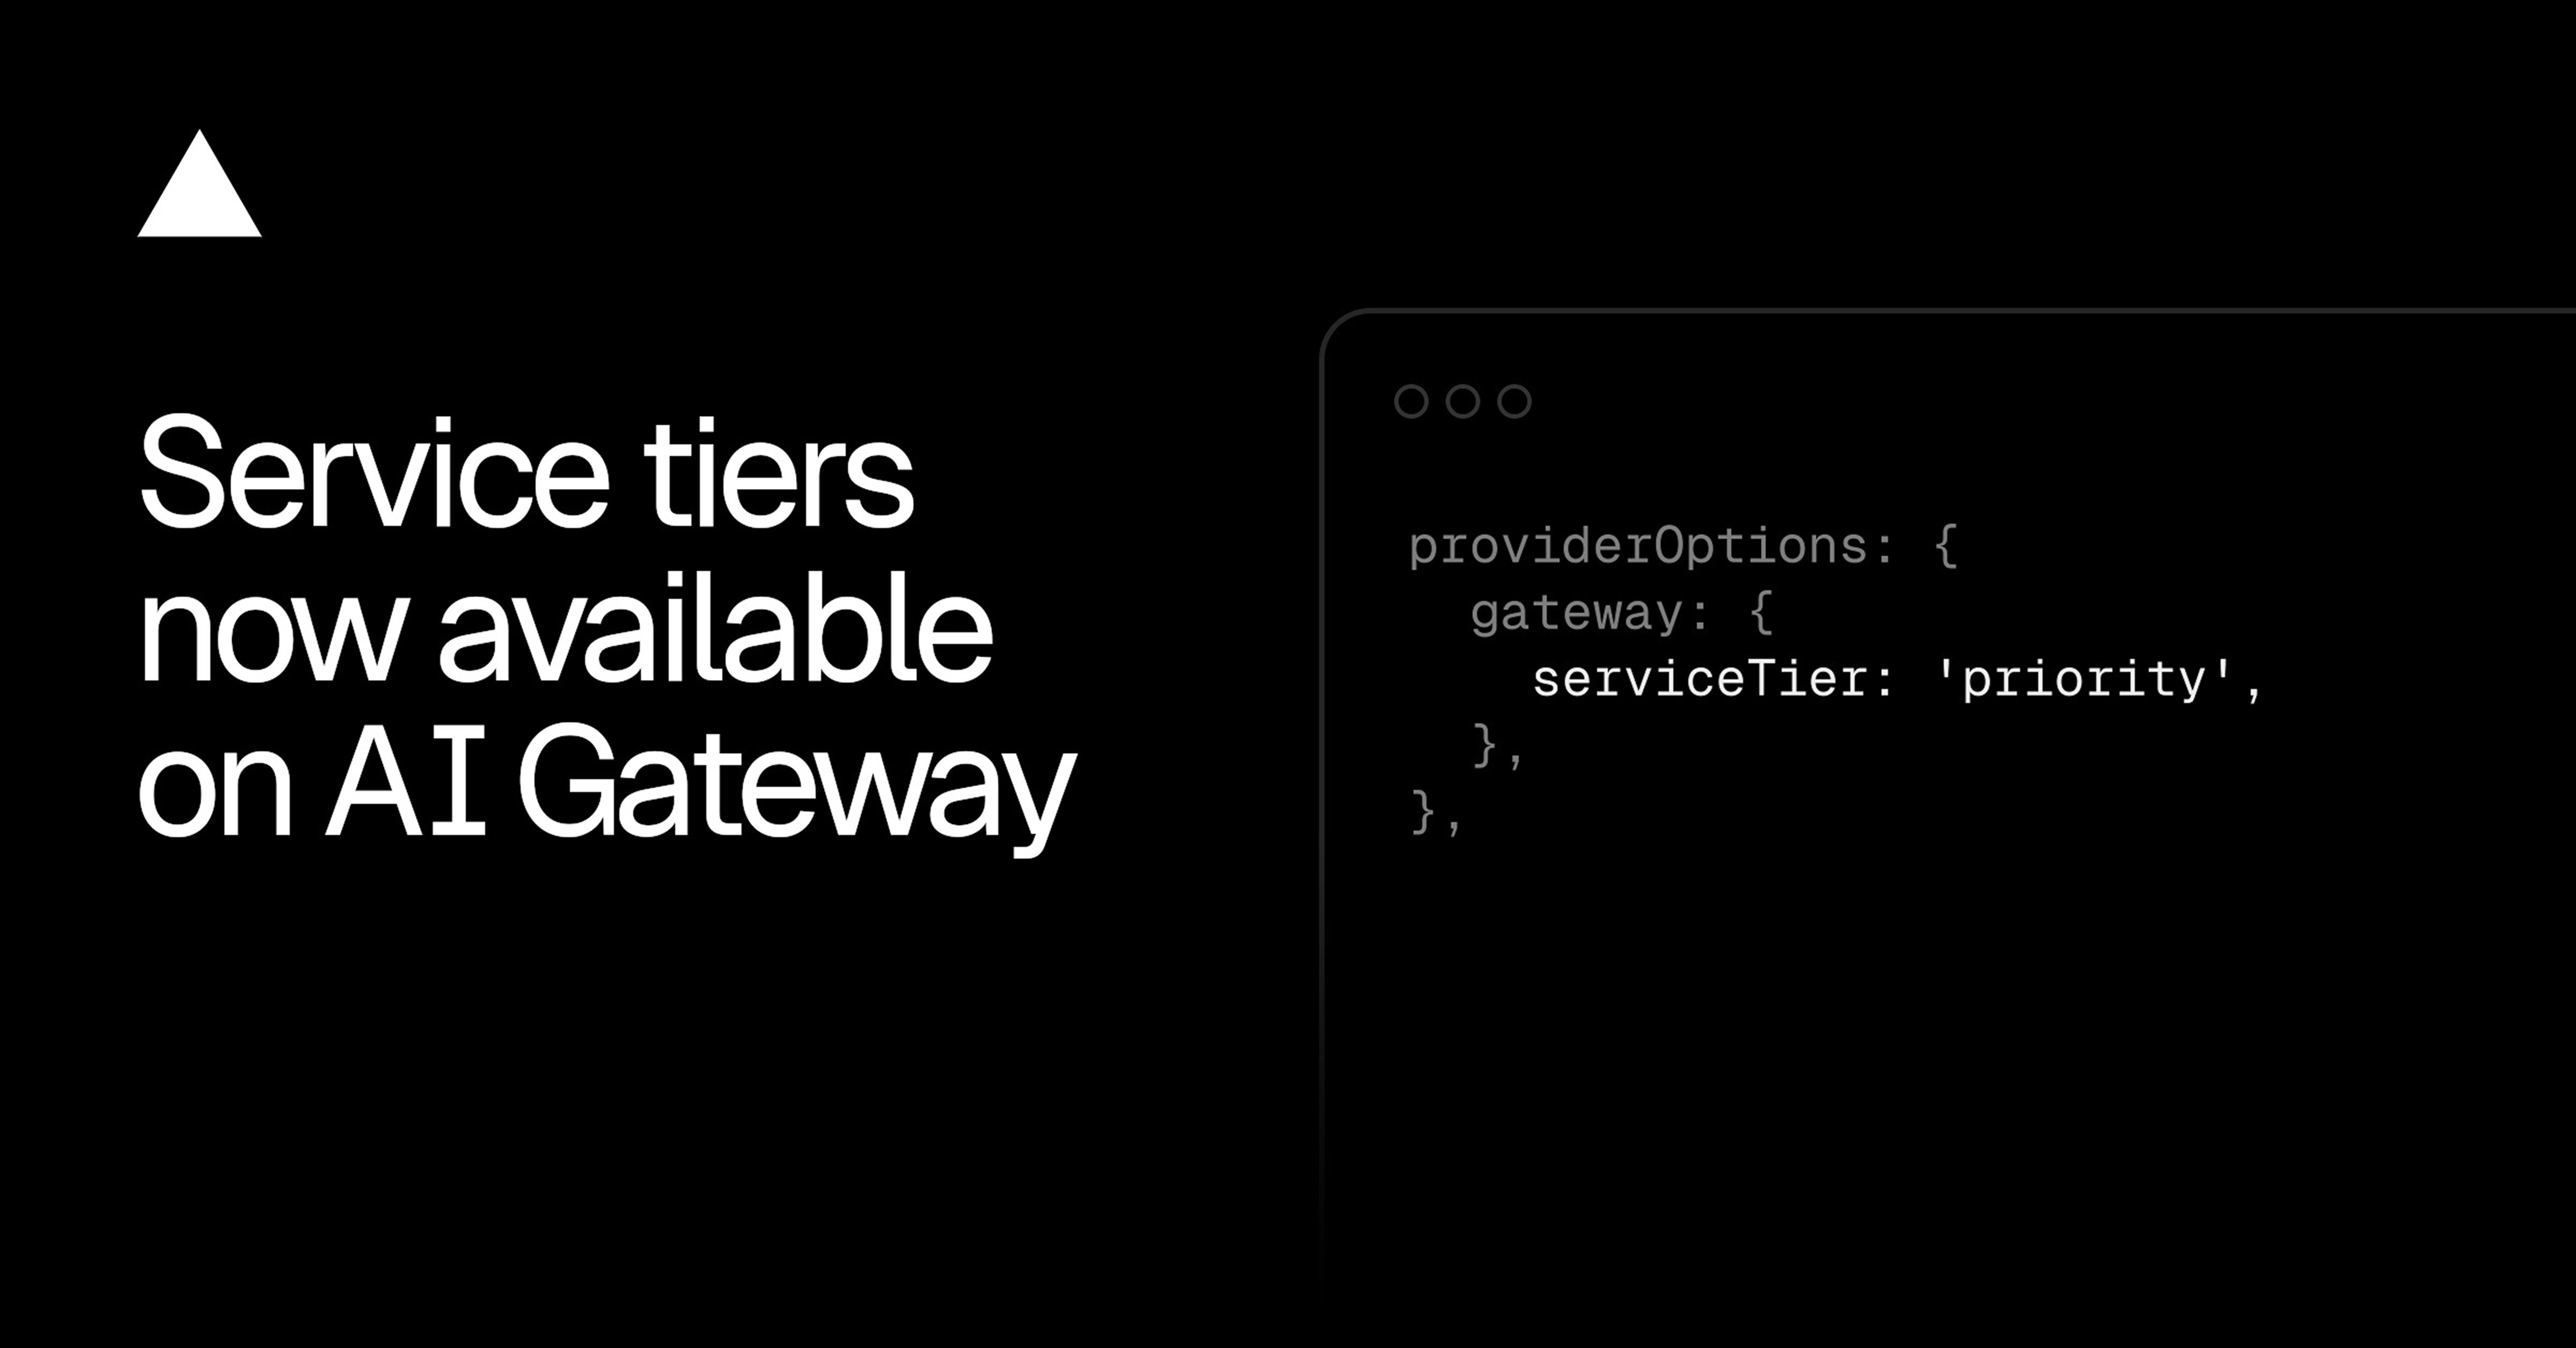
AI Gateway新增服务分层功能,支持默认、优先和灵活三种层级,分别优化延迟、吞吐和成本。用户可通过providerOptions指定层级,适用于OpenAI和Gemini模型,支持多种API格式。计费按实际使用层级自动调整,优先请求降级时按默认费率计费。
直播延迟优化需全链路考虑,包括推流端、传输层和播放端。推流端应使用硬件编码、合理码率和流量控制;传输层通过自建网络优化路径以降低延迟;播放端使用L3协议减少缓冲。连麦互动需理解混流和CDN延迟,整体策略在保证流畅性的同时优化延迟。
AI语音聊天机器人的实现依赖多个模块的协同,关键在于整体架构、流式串联、并行与预测、传输与端侧优化。通过优化各环节,端到端延迟可降低至700~900毫秒,接近真人对话速度。团队应明确延迟目标,利用成熟技术平台降低工程门槛,专注于对话逻辑创新。未来,随着技术进步,延迟有望进一步降低。
AI语音体验的延迟至关重要,超过1秒会影响用户感受。优化延迟的步骤包括流式处理、选择快速模型、缩短上下文、合理分句和就近接入节点。优化需兼顾质量与延迟,以确保良好的用户体验。
Amazon GameLift Servers推出了Player Gateway和Ping Beacons功能,旨在解决多人在线游戏中的DDoS攻击和延迟问题。Player Gateway通过中继网络隐藏服务器IP并验证流量,Ping Beacons提供全球UDP延迟测量,帮助优化玩家区域选择。这两项功能均免费,集成简单,支持C++ SDK,提升游戏安全性和用户体验。
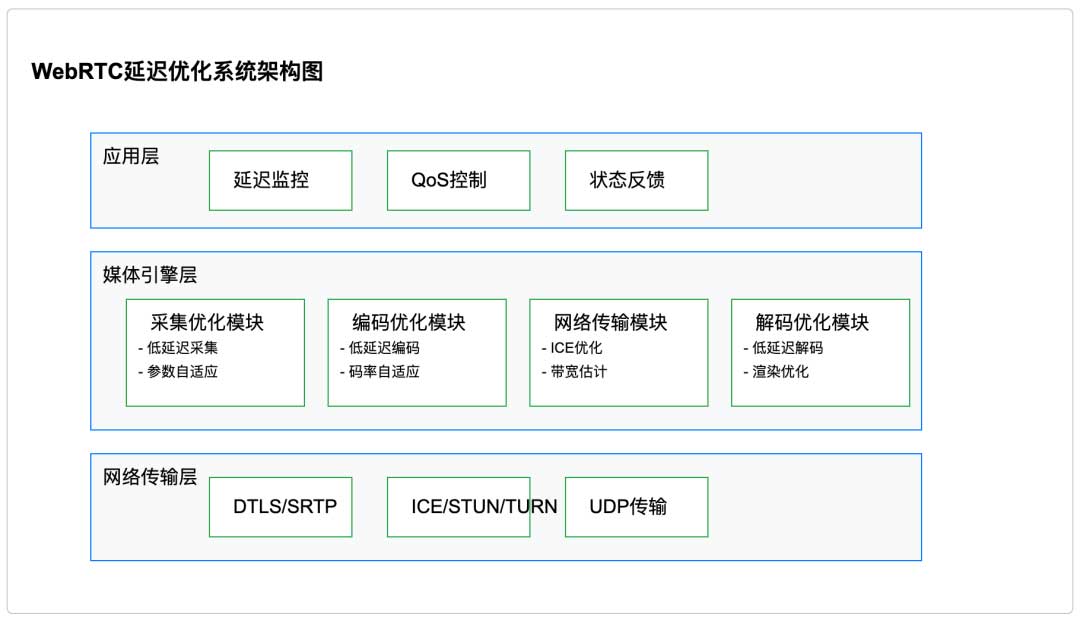
WebRTC视频通话的延迟优化涉及采集、编码、传输、解码和渲染等环节。延迟来源于硬件、编码、网络传输和接收端处理。优化措施包括降低采集分辨率和帧率、选择低延迟编码、优化网络ICE设置和动态调整码率,目标是将延迟控制在150-500ms之间。
游戏加速器如ExitLag、WTFast通过VPN将游戏流量转发至自有服务器,优化路由以降低延迟、抖动和丢包。作者用ExitLag将《英雄联盟》延迟从82ms降至60ms,但城市用户因靠近服务器效果有限,建议先试用。
完成下面两步后,将自动完成登录并继续当前操作。