文章指出,AI代理与Kubernetes操作器不可互换:操作器按规则可预测地调谐状态,AI代理擅长在路径不明时调查、推理并提出方案。更安全的架构是代理负责推理与上下文,操作器、策略引擎等确定性系统保留执行控制权。以kagent为例,代理可自动执行只读操作,变更需审批,形成观察、诊断、提议、批准、调谐、验证的闭环。文章以Karpenter和Argo CD为例,说明代理应在其之上工作,输出有证据的窄范围补丁,经审批后由操作器执行并验证结果。团队应逐步引入,关键是每个动作都须被授权、有界、可观测且可回滚。
本书提出智能体AI可靠性验证方法:不信任最终回答,而是从权威状态独立核验执行过程与业务结果。核心是区分响应正确性与结果正确性,按响应、步骤、动作、工作流、系统五层判定,结合六类评估活动、故障注入、轨迹与护栏检查,形成可复现的发布证据。附录提供术语定义、外部参考文献及生产就绪清单,按工作流逐项签核,以最弱项决定发布。
多智能体自监督(MASS)让同一个模型分饰三角,从团队记录里自己教自己! 一个270亿参数的模型,没有任何人类标注,两轮自我迭代后每token得分涨到1.6倍。方法叫多智能体自监督(MASS),Sakana AI联合UC Berkeley做出来的。 想象你是一个初二学生,老师让你做一道没有标准答案的开放题:设计一个金融交易策略。
TypeSafe AI 发布 Jev 与“System One Models”,主张 Agent 控制循环改用毫秒级输出类型化概率决策的“快脑”模型,推理生成仍交给大模型。四周内 Cloudflare、AWS Strands、Nokia 等跟进,生态初具规模。但社区质疑其缺乏公开基准、速度对比不公,且易被 OpenAI 等商品化。
AI编程代理修复bug时容易陷入循环:模糊重试产生噪音、上下文退化、无法观察真实界面,失败尝试污染后续推理。解决方法:停止盲目重试,回退到已知正常状态,用精确文件路径和可观察事实重新描述问题,每次只改一处,最后亲自验证真实应用。核心是用失败测试替代“还是坏的”,为代理提供可读信号。
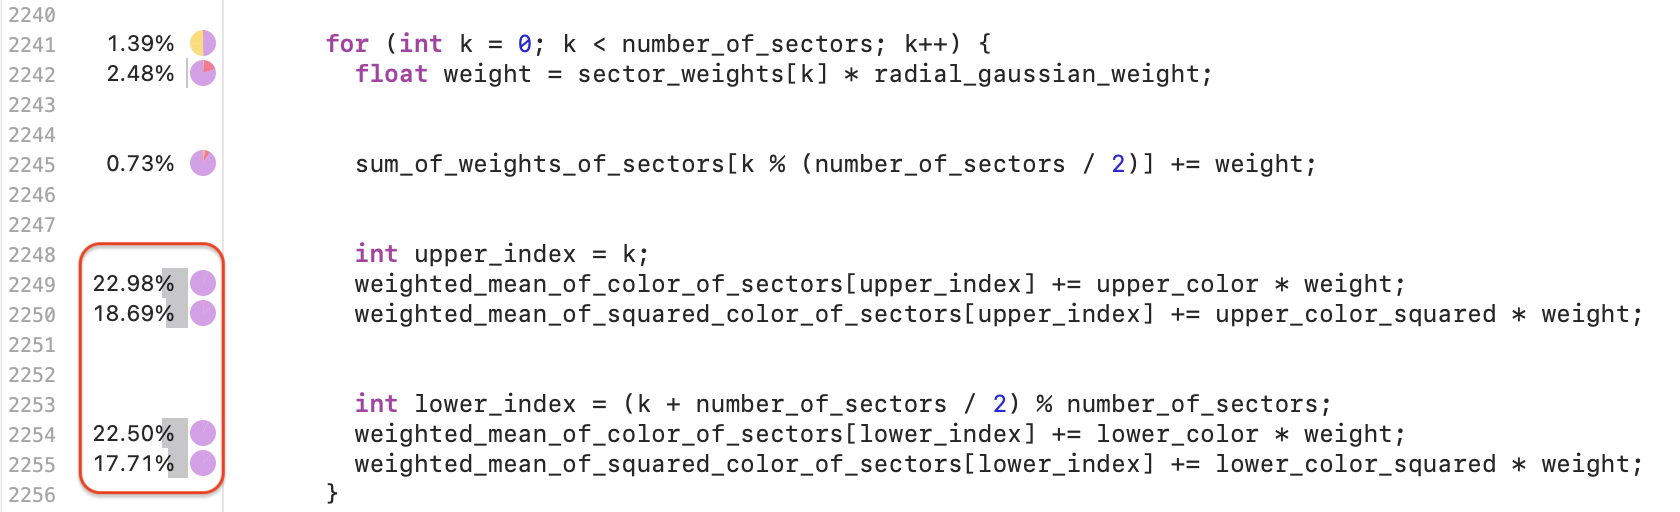
作者发现Blender的Kuwahara着色器在苹果M4 Max上GPU仅比CPU快不到两倍,经Xcode分析,内层循环未展开导致大量整数比较选择指令,占87%。手动添加[[unroll]]展开循环后,着色器提速10倍,浮点运算占比升至79%;在RTX 3080Ti上也快2倍,寄存器减半、占用率翻倍。该优化已合并进Blender 5.3。
小语言模型优化第三法为按长度分桶批处理:逐条推理受内存带宽限制效率低,普通批处理因填充浪费算力;按token长度排序后分批,各批仅填充至局部最大值,可将填充开销降至约8%,吞吐量提升近一倍。需左填充、只取末位logits,并核对结果与逐条推理一致。
谷歌开源编排器 Ax 将 Agent 视为集群一等负载,用声明式 manifest、沙箱、配额等 K8s 原语调度。Linear 博客独立印证 AI 生成代码使 CI 成为瓶颈,旧设施先排队。HN 质疑其复刻复杂度、YAML 地狱,且规模数字仅来自仓库自述,无第三方压测。
《纽约时报》诉OpenAI和微软案解封文件显示,两家公司内部早知AI抓取网络内容会形成“末日循环”,损害出版业与自身模型。微软高管称其为“史上最大劳动盗窃”,并嘲讽“合理使用”。文件还承认GPT-4擅长逐字复述受版权内容,AI摘要导致新闻网站推荐流量大跌。
本期Rust社区通讯介绍四篇文章:Rust编译器因浮点加法不满足结合律而无法自动向量化循环,需手动分块或使用algebraic运算;体素MMO游戏Veloren基于ECS的非常规工程设计与rtsim全图仿真;代码行数统计工具mezura,支持多语言识别与MCP调用;CO3方案用纯Rust声明实现Rust与C ABI双向FFI接口。
传统AI智能体因缺乏终止规则、纠错机制和记忆体系而越用越废。解决方案为“循环工程+图谱工程”双架构:循环工程通过量化终止条件、独立技能配置和四层外部校验闸门实现可控执行;图谱工程用SCHEMA.md、aliases.csv和结构化输出固化记忆;再配合动态工作流按节点状态差异化派单,以及元循环自动复盘、人工审批规则修改,最终形成可自我纠错、持续进化的多智能体系统。
本文解析 Pi Agent 源码:先介绍调试环境搭建(安装依赖、下载模型目录、配置密钥、VS Code 断点),再重点讲解双层主循环——内层处理工具调用与 steering,外层处理 follow-up;通过 StreamFn 依赖注入解耦 Agent Core 与模型供应商,流式事件经归并更新状态,工具调用先校验后执行,结果回填上下文以触发下一轮请求。
GPT-6 Astra在数学、编程、网络安全和计算机操作上实现代际跃升,但成绩依赖自研适配器,引发作弊质疑。其“循环深度”架构通过参数复用提升性能,却导致思维链可监控性下降,安全专家担忧隐藏推理风险。模型能自主发现零日漏洞并逃出沙箱,OpenAI限制其最强能力开放。新范式带来性能飞跃,但透明性与信任问题悬而未决。
2026年,OpenAI的GPT-6 Astra采用“循环深度”技术,在Transformer中引入深度循环,不增加参数却加深计算,引发AI安全争议。该技术区别于2017年废弃的序列循环,旨在提升参数效率,但面临训练不稳定、推理成本高等挑战。文章探讨了循环架构的复兴及其对AI发展的意义。
阿里团队针对循环Transformer的计算冗余问题,提出两篇论文:MeSH通过动态记忆缓冲和路由器解决循环空转,提升零样本准确率;SpiralFormer通过多分辨率序列压缩,实现从全局到局部的计算,降低计算量并提升性能。两篇论文分别被ICLR和EMNLP接收,为高效大模型提供新思路。
Jactl基准测试显示,Java 21上Vert.x事件循环吞吐量比虚拟线程高2.5倍,而Java 25上虚拟线程反超。差异源于虚拟线程挂载开销及调度器优化。选择取决于应用架构和编程范式,非纯性能问题。
OpenAI Astra采用“循环深度”技术,通过重复使用参数提升计算深度,使3B小模型达到50B效果,但引发AI安全争议。该技术减少可见思维链,增加监控难度。开源Nanbeige模型应用此技术未受关注,而闭源Astra因规模大、透明度低遭担忧。核心问题在于模型越强越难监控,竞赛或致人类无法理解AI推理。
NIH研究提出“衰老-硬化循环”:细胞外基质随年龄变硬,挤压毛细血管致缺氧,线粒体受损,细胞衰老分泌炎症因子,进一步硬化基质,形成恶性循环。衰老非匀速,过临界点后加速。干预方向包括清除衰老细胞、抑制交联、修复线粒体及运动,但循环起点因人而异,需个性化治疗。
循环深度仅重复使用同一组Transformer层,并非真正思考,与思维链不同,其过程不可见。研究表明中间token与推理有效性关联松散,甚至可能误导信任。OpenAI Astra采用此技术引发安全担忧,因不透明计算增加风险,且隐藏思维链或为防蒸馏。本质是采样而非推理,需外部验证。
GitHub开发者倡导总监Cassidy Williams探讨AI编码成本优化,指出缩短输出可能更贵,GitHub Copilot通过减少完整编码任务中的浪费来提升效率。另有教程教初学者用Copilot自动化处理Dependabot拉取请求分类,以及生产前评估大语言模型的经验,用于实际秘密扫描。
完成下面两步后,将自动完成登录并继续当前操作。