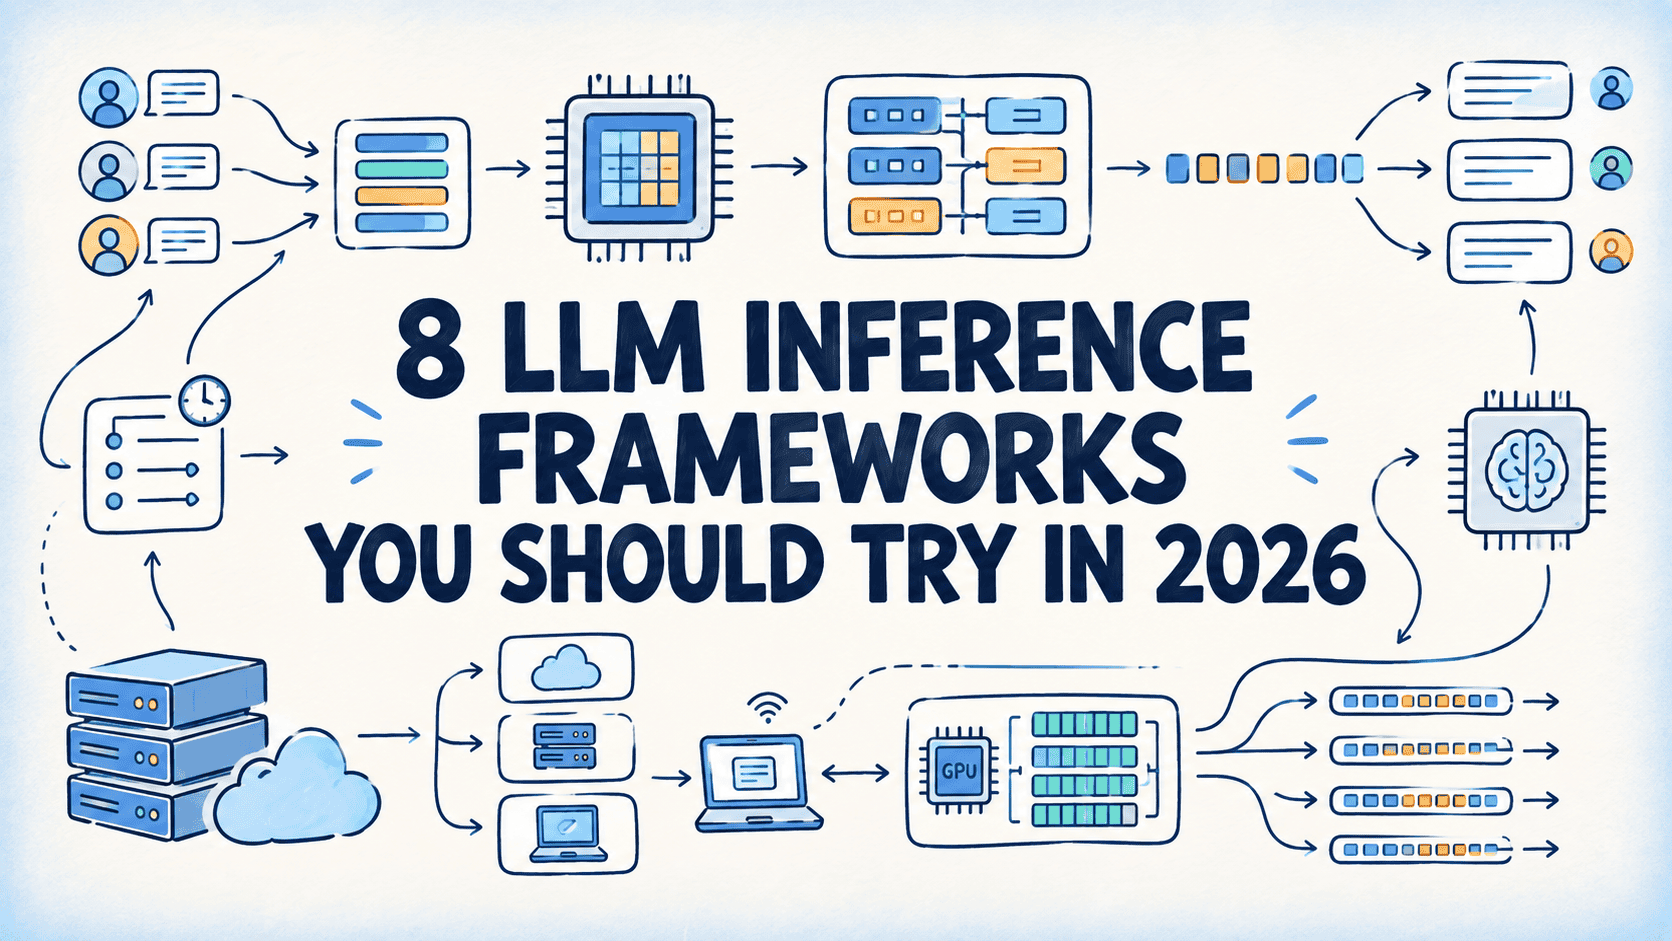
本文介绍8个LLM推理框架:vLLM通过PagedAttention与连续批处理实现高吞吐;SGLang擅长结构化与多步提示;MAX支持CPU/GPU及内核级调优;TensorRT-LLM在NVIDIA硬件上速度最快;LMDeploy专注量化与并发;llama.cpp轻量可移植;Ollama适合本地实验;MLC-LLM支持多平台边缘部署。选型应结合流量、硬件与部署目标,并在自有模型上实测延迟与成本。
文章基于1000万行数据实测PostgreSQL 18各类索引:B-tree为默认首选,等值查询约0.11毫秒;哈希索引无优势且体积大3倍;BRIN仅72 KiB,适合时间有序大表,但慢约3倍;部分索引只含0.85%的行,体积小160倍且速度相当;覆盖索引快1.4倍但大4.4倍,且UPDATE后失效;GIN适合数组、jsonb和全文检索,匹配稀少时快129倍;GiST/SP-GiST用于几何与范围查询。每增加一个索引都会拖慢写入,应据查询选型并清理未用索引。
OpenRouter匿名上线union-alpha模型,宣称一周免费无限使用,但实测吞吐仅每秒15-19个token,速度远逊主流模型。其跑分图用截断坐标轴夸大编程能力,实际指令遵循差、任务常无有效产出。所谓无限受每日50次配额限制。该模型身份成谜,疑似中国实验室盲测,实战表现不佳,免费背后用户数据或被用于训练。
完成下面两步后,将自动完成登录并继续当前操作。