作者在PostgreSQL 18.6上实测四条常见建议:IN、ANY与VALUES连接性能相当,ANY更利于预处理语句;text、smallint、enum存状态列大小几乎相同;NULL列几乎不占空间;count(DISTINCT)反而比GROUP BY子查询更快。结论是这些建议需用EXPLAIN在自有数据上验证,不能盲从。
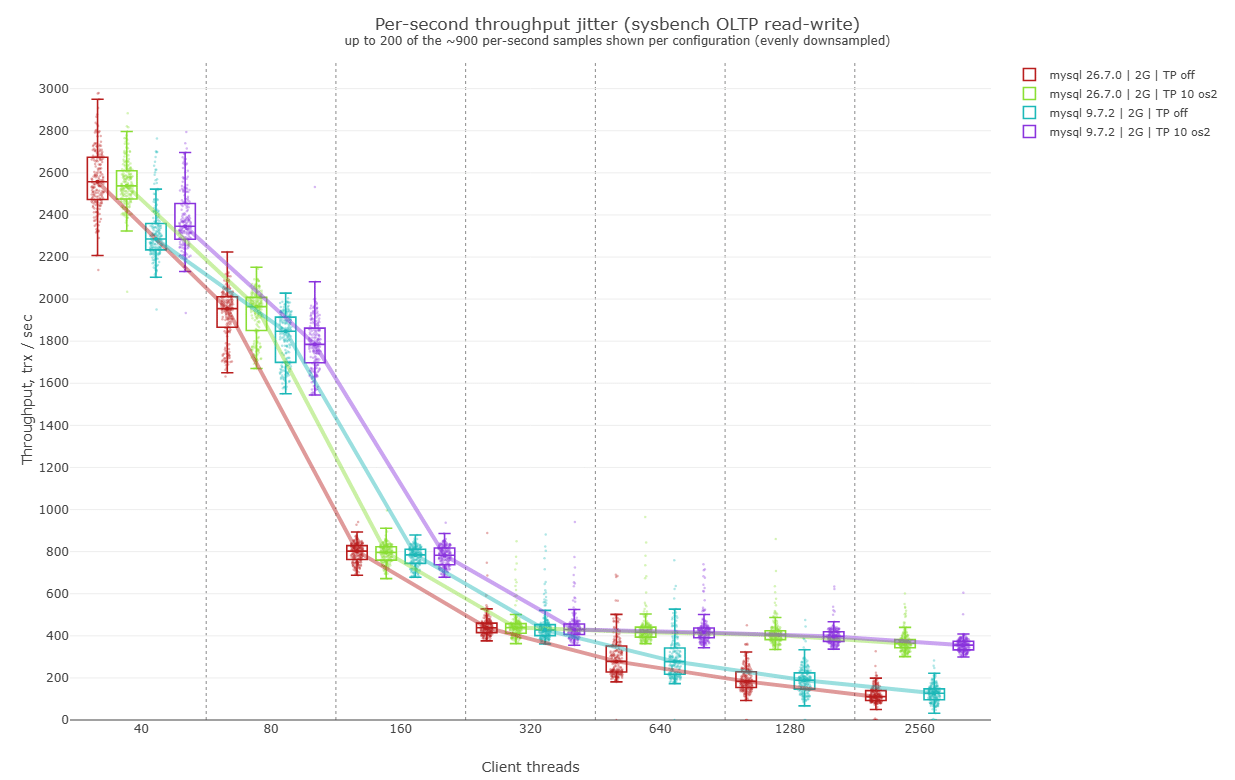
本文对比了Percona Server与MySQL的线程池性能。测试表明,MySQL 26.7.0与9.7.2性能差异极小。数据未完全缓存时,Percona线程池在高连接数下TPS更高;数据完全缓存时,MySQL线程池更优,TPS高22%,p95延迟低约25%。Percona对线程池参数更敏感,MySQL仅在1280以上连接数才显优势。
作者自费在云上对PostgreSQL 18与19 Beta进行约800小时OLTP测试,涵盖pgbench和类TPCC负载。结果显示19版整体性能稳定并略有提升,执行时间约改善3%,其中INSERT快25-30%,SELECT略快,UPDATE基本持平。结论是无需担心19版OLTP能力,但云环境测试波动较大,建议用户自行验证。
极客湾发布M6芯片评测,Mac mini M6性能提升符合预期,核心更多、速度更快,但存储涨价使其价格不再像当年2000多元的Mac mini M4那样具有性价比。
苹果发布新款Mac Studio,搭载M5 Ultra芯片,配备36核CPU、80核GPU和256GB内存,售价12299美元,面向AI开发者和高端3D特效。基准测试显示,其CPU性能比上代M3 Ultra快约30%,GPU渲染最高提升63%,4K视频导出仅需40秒。作者称这是其测试过最快的电脑,后续将深入测试AI性能。
6GB显存可运行Qwen3.6-35B-A3B-NVFP4,但需32GB以上内存,依赖CPU和PCIe。配置建议:Triton attention、memory-ratio 0.92、Prefill 2048、512专家槽。性能低于8GB的39.3 tok/s,适合短上下文和编码实验。需Ampere架构,逐步调优专家缓存和KV,实测不同后端。
匿名AI模型Ox Alpha在OpenRouter上线后调用量激增,周调用量达11.6万亿Token,登顶榜首,终结DeepSeek纪录。其性能在代码测试中优于多款模型,但开发主体未明,技术特征指向智谱GLM系列,也有猜测为Gemini新版。网友认为匿名测试更客观,厂商或借此观察真实反馈。
本文介绍RoCE、Soft RoCE与InfiniBand三种RDMA网络的配置与测试方法。RoCE需无损以太网并开启PFC,通过GID选择通信地址;Soft RoCE用软件模拟,适合开发但性能低;InfiniBand依赖子网管理器,性能最高。文中详述了安装工具、查看设备及使用ib_write_bw/lat进行带宽和延迟测试的步骤。
通信云集成后的技术验收至关重要,需在真实网络环境下进行,涵盖功能、质量、性能和稳定性四个方面,确保解决潜在问题。关键指标如CPU占用、内存使用和首帧时间需符合标准,长时间测试有助于发现问题,提升用户体验。
本文介绍了在RTX4060上本地部署Gemma4-26B-A4B模型的过程与效果。通过Q8缓存量化和MTP加速,模型输出速度可达40 tokens/s。尽管在翻译和数学问题上表现一般,但在SQL测试中与其他模型相当。文章还讨论了模型的参数设置及其对性能的影响。
ARM Neoverse V3(代号Poseidon)微架构相比V2有显著改进,解码宽度增加至10-wide,去掉了MOP Cache,并提升了物理寄存器堆和L1 DTLB容量。性能测试显示IPC在不同条件下表现稳定,整体为一次稳健的迭代升级。
该项目是用Rust编写的极简撮合引擎核心,名为Lighting Match Engine Core,专注于订单簿和交易阶段,支持连续竞价和集合竞价,提供dense和sparse两种订单簿实现。项目旨在与Rust社区交流低延迟撮合系统的设计,欢迎反馈和建议。目前已实现基本功能并进行性能测试,未来计划增加更多功能和完善文档。
本文分析了SPEC CPU 2026中INT Rate的负载特性,使用Intel i9-14900K CPU进行测试,重点测试了706.stockfish_r和707.ntest_r等基准。研究了不同编译选项(如-O3、-march=native)对性能的影响,发现内存分配和分支预测是主要瓶颈,MPKI普遍较高。GCC 15和LLVM 22在优化方面表现优异,特别是在64位乘法和内存管理上。整体而言,编译器和处理器设计者可通过优化提升性能。
Kimi-K2.6是Moonshot AI于4月20日发布的开源大语言模型,具备长上下文推理和多模态理解能力。文章介绍了模型的下载、部署及性能基准测试,强调其在多项评测中的优异表现。Kimi-K2.6支持工具调用和视觉-语言输入,适合多种应用场景。
本文介绍了Amazon Aurora PostgreSQL的大版本升级指南,包括升级前的准备、兼容性测试、性能测试及多种升级方案(如蓝绿部署)。强调提前规划升级窗口以避免业务中断,并提供详细步骤和注意事项,以确保顺利完成升级。
某些版本的ChatGPT允许用户创建定制GPT,以满足特定任务或工作流程的需求。定制GPT提供一致的输出,减少重复工作。用户可以上传文件和启用工具,以构建合适的工作流。在构建过程中,需要明确目标、测试性能并调整指令,以确保有效性。
在ASP.NET Core中,使用System.Text.Json框架简化了序列化和反序列化的实现。开发者可以自定义配置,如忽略null字段和时间格式。文章介绍了如何使用自定义转换器处理枚举和数值类型,确保JSON与模型类之间的正确转换,并提供了性能测试示例,比较Utf8JsonReader与JsonNode的效率。
本文介绍了使用wrk工具对localfs进行性能测试,测试了1KB、4KB和512KB小文件的写入、读取及列目录性能。结果显示,1KB和4KB文件的请求速率较高,延迟较低,而512KB文件性能较弱。整体而言,localfs性能表现良好。
本文介绍了如何在生产环境中使用 vLLM 部署 GLM-5 模型,包括模型下载、镜像构建和 Docker 部署。GLM-5 是智谱 AI 最新的大语言模型,具备强大的推理能力。文章详细说明了安装 HuggingFace CLI、下载模型、构建自定义镜像及服务验证等步骤,并提供了性能基准测试结果,显示 INT4 版本在特定环境下的高吞吐量。
Nvidia在GTC大会上宣布成立Nemotron联盟,旨在共享AI实验室的专业知识和数据,构建基础模型。该联盟的首个项目是Nemotron 4系列基础模型,成员包括Black Forest Labs和LangChain等。Nvidia提供计算资源,参与者可根据需求调整模型。此外,Nvidia还推出了Nemotron 3 Ultra和Nemotron 3 Super模型,后者在性能基准测试中表现优异。
完成下面两步后,将自动完成登录并继续当前操作。