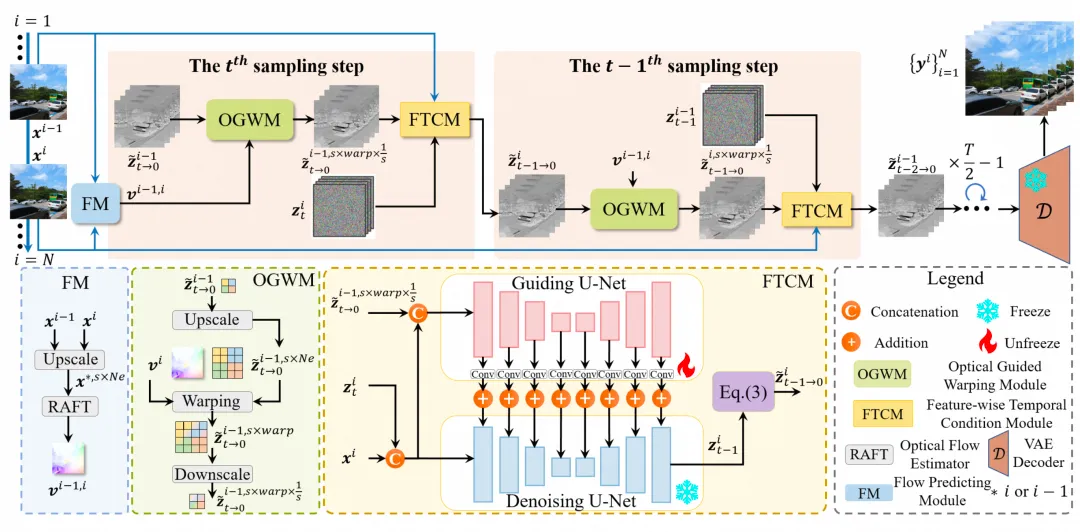
本文介绍了DGAF-VSR,一种基于扩散模型的视频超分辨率方法。该方法通过光流引导变形模块和特征级时序条件模块,显著提升了视频的感知质量、重建保真度和时序一致性。实验结果表明,DGAF-VSR在多个数据集上表现优异,为短视频和直播等应用提供了重要突破。
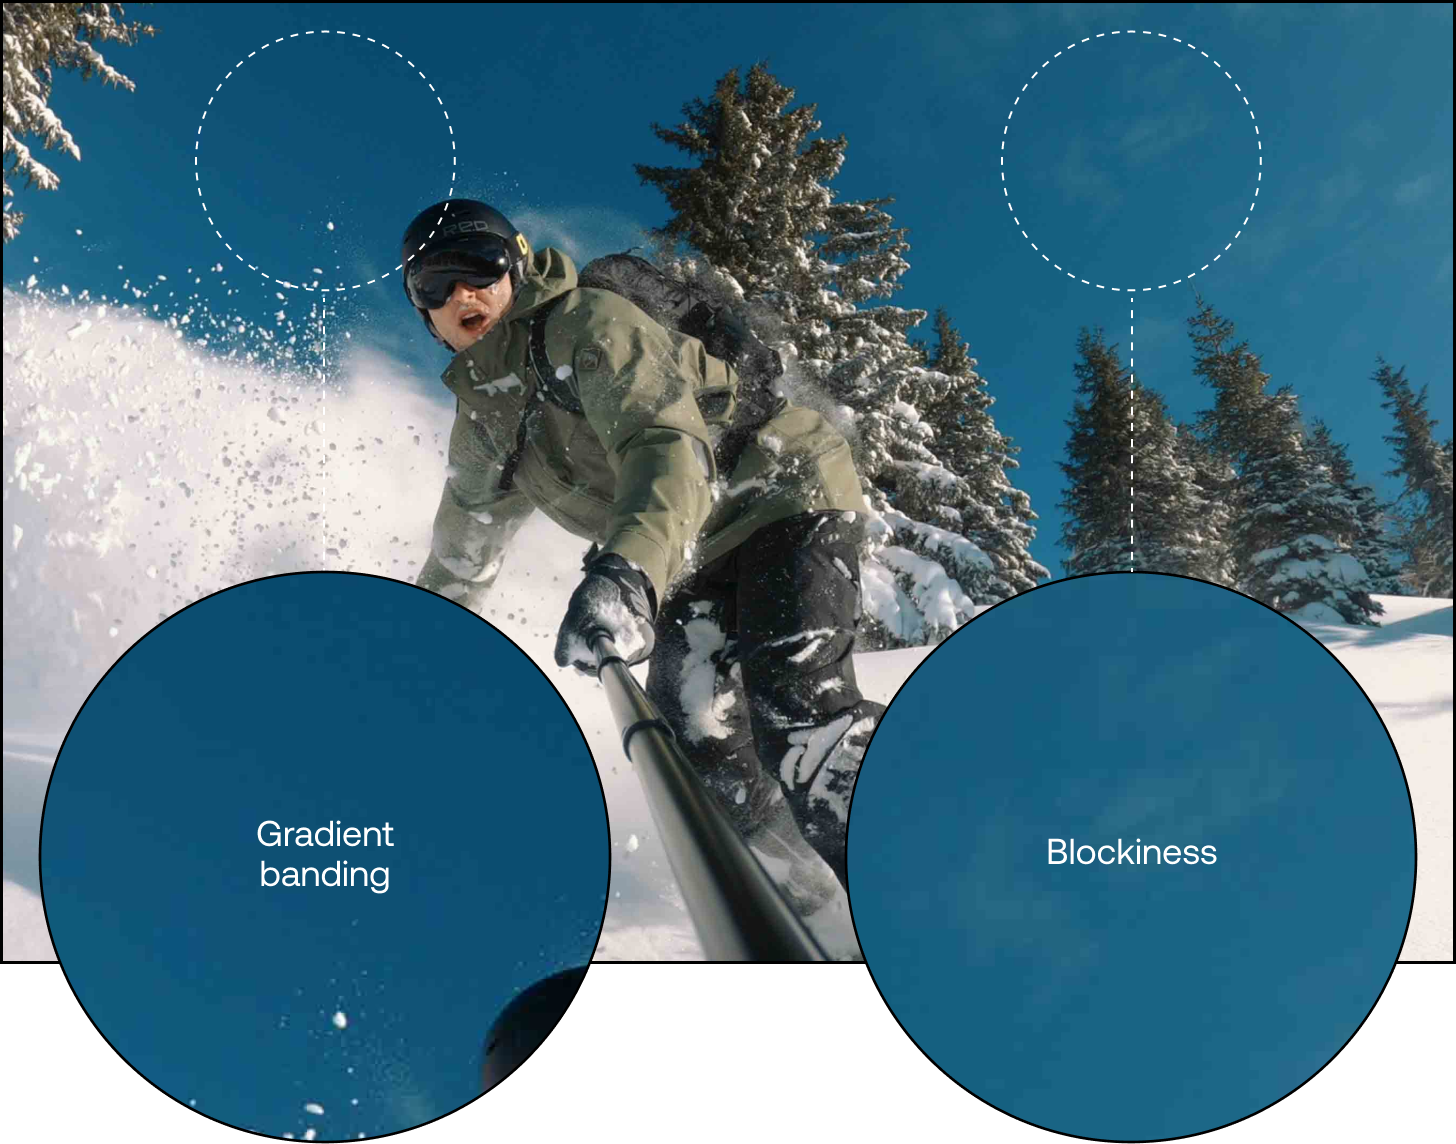
JPEG XL的设计忽视位深度,强调感知质量而非数字精度。与AVIF相比,JPEG XL通过浮点数处理和XYB色彩空间优化图像质量,适应不同显示条件,提升视觉效果。
本文介绍了一种基于卷积时间域音频神经网络(Conv-TasNet)的数据驱动空间音频解决方案,能够将一阶Ambisonics(FOA)输入转换为高阶Ambisonics(HOA)输出。该方法在空间准确性上优于传统渲染器,量化评估显示预测与实际第三阶HOA之间的平均位置均方误差为0.6dB,感知质量提高了80%。
近年来,图像到视频生成取得显著进展,但3D一致性和相机可控性问题仍未解决。为此,我们提出了Cavia框架,能够将输入图像转换为多个时空一致的视频,支持精确控制相机运动,同时保持物体运动。实验结果表明,Cavia在几何一致性和感知质量上优于现有方法。
本研究提出了一种新颖的两阶段JSCC框架SING,旨在提升极端条件下图像传输的感知质量。实验结果表明,SING在挑战性环境中优于传统方法。
本研究提出了一种新方法——后验均值修正流(PMRF),在图像恢复中优化后验均值预测,提升感知质量并减少均方误差。实验表明,PMRF在多种任务中优于传统方法。
本文探讨了图像修复算法中失真度与感知质量的对立关系,提出了一种新的评估方法,并通过生成对抗网络(GAN)优化超分辨率图像生成。研究表明,现有图像质量评估方法无法公平评估基于GAN的算法,提出的双分支减参考SR-IQA网络在评估真实世界超分辨率图像质量方面表现优异。
视频编码会导致质量损失,尤其是在进行有损压缩时。感知质量(PQ)用于衡量编码视频与原始视频的相似度,常用的PQ测量方法包括PSNR、SSIM和VMAF。VMAF在行业中广泛应用,94分被视为流媒体的良好质量标准。选择合适的PQ目标对用户体验至关重要。
该论文探讨了图像超分辨率的质量评估,提出了超分辨率图像保真度指数(SRIF)及多种新模型,显著提升了超分辨率图像的感知质量和评估方法,实验结果在多个基准测试中表现优异。
本文综述深度学习图像压缩研究,提出非二元鉴别器并结合VQ-VAE量化局部表示,在CLIC2020等数据集上优于HiFiC,同等FID下节省30-40%比特。研究还涵盖端到端编解码、感知与对抗损失、扩散模型解码及JointIQ-Net等,兼顾失真与感知质量。
本文综述学习图像压缩进展:L3C采用分层自适应熵模型,性能超越PNG和WebP;后续研究致力于提升感知质量、节省比特率,并拓展至语义分割、JPEG重压缩等方向。
该文综述学习型有损图像压缩研究,涵盖内容加权编码器-解码器与重要性掩模实现自适应比特率分配、基于Transformer与提示生成支持ROI及可变速率编码、兼顾感知质量与效率的改进模型(节省超25%比特率)、用于视频压缩的对抗学习、结合GAN的宽比特率高质量重建、面向视觉分析的率失真模型(节省最高28.17%比特率)、集成ROI掩模的Swin Transformer提升检测分割性能、以对抗训练提升感知品质的PO-ELIC,以及极低比特率下有效的双自适应掩膜。
本文介绍了一种新型的GAN反演架构,名为特征-风格编码器,能够更准确地反演实际图像,获得更好的感知质量和更低的重建误差。该编码器在视频反演和编辑方面也表现出特别适用性。通过广泛的实验,该方法在基于风格的GAN反演方面显著优于竞争方法,达到了最新成果。
完成下面两步后,将自动完成登录并继续当前操作。