DeepSeek搜索与抓取工具已通过AI Gateway开放,无需单独DeepSeek账户,一个API密钥即可配合任意支持工具调用的模型使用。搜索返回标题、URL和摘要,抓取将页面转为Markdown供模型阅读,需AI SDK 6.0.321或7.0.160以上版本。搜索失败时可切换Exa、Parallel等备用工具。每千次计费请求收费0.75美元,失败、超时和空结果不收费,模型token另行计费。
OpenAI、谷歌、微软和Anthropic宣布采用新标准,允许出版商通过robots.txt中的共享“政策令牌”一次性向多家AI公司声明内容不得用于训练,无需逐一设置。Anthropic已采用,谷歌和微软计划明年支持,OpenAI称将在未来数月实施。此举回应出版商对AI爬虫抓取内容的担忧。
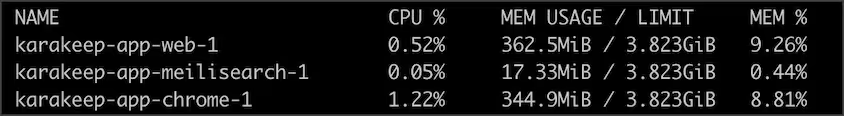
Karakeep 0.34.0 发布,GitHub 星标近 3 万。本次更新包括:网页抓取改用 Patchright 和完整 Chrome,提升反爬与 Cloudflare 验证处理能力;移动端支持自动离线下载和完整列表离线保存;新增手动保存视频功能;修复内存泄漏,常驻内存降低约 40MB;优化数据库与搜索。注意:认证已迁移至 Better Auth,网页用户需重新登录。
DeepSeek把搜索和抓取做成了独立收费接口,每千次五块钱! 十月十七号这天,DeepSeek放出了V4.1-Flash-1017版本,顺手把自研搜索引擎的底牌掀开了一角。官方网页、手机应用和API全都换上了新模型,旧名字deepseek-flash照样能用,调用方式一个字没改。但真正让写代码那帮人半夜爬起来看文档的,是另一个东西:Search和Fetch两个独立接口开始公开卖钱了,一千次
BrowserAct 是一款无代码 AI 网页抓取平台,可将复杂网站抓取任务转化为可复用 Bot,避免重复推理,降低 token 与时间成本。它提供 400 多个预建模板,支持用自然语言构建自定义抓取器,并管理浏览器、代理和验证码。结果可导出为 CSV、JSON 或通过 API 接入自动化流程,适用于电商监控、数据研究等周期性采集场景。
Browserbase 的搜索与抓取工具已接入 AI Gateway,开发者可用一个 API 密钥跨模型调用,为支持工具调用的模型添加网页搜索和页面抓取能力。需 AI SDK 7.0.116 及以上版本,通过 gateway.tools 传入 browserbaseSearch 和 browserbaseFetch 即可使用。
本文介绍GeekAgent第12天开发:新增search和fetch两个工具。search在权限目录内按内容搜索代码,返回文件:行号:内容,跳过node_modules和二进制文件;fetch读取网页并转纯文本,访问前需确认URL。两者均注册到工具系统,search用safePath限制目录,fetch用authorize确认。实现采用Node内置glob和正则剥标签,不依赖额外库,适合小型仓库。
本文介绍如何用Python构建AI网页抓取器:先抓取网页,用BeautifulSoup清理HTML,再用markdownify转为Markdown,最后调用OpenAI模型回答用户问题。通过减少噪音和token消耗,输出简洁的Markdown答案。文章还讨论了成本考量,建议根据需求选择自建或使用现成工具。
蚂蚁灵波推出的LingBot-Vision和LingBot-Depth 2.0显著提升了机器人对透明和复杂物体的视觉识别能力,增强了物体边界和空间关系的识别,从而提高了抓取和导航的稳定性。这一进展对家庭服务和工业巡检等场景具有重要意义,标志着具身智能在视觉感知领域的突破。
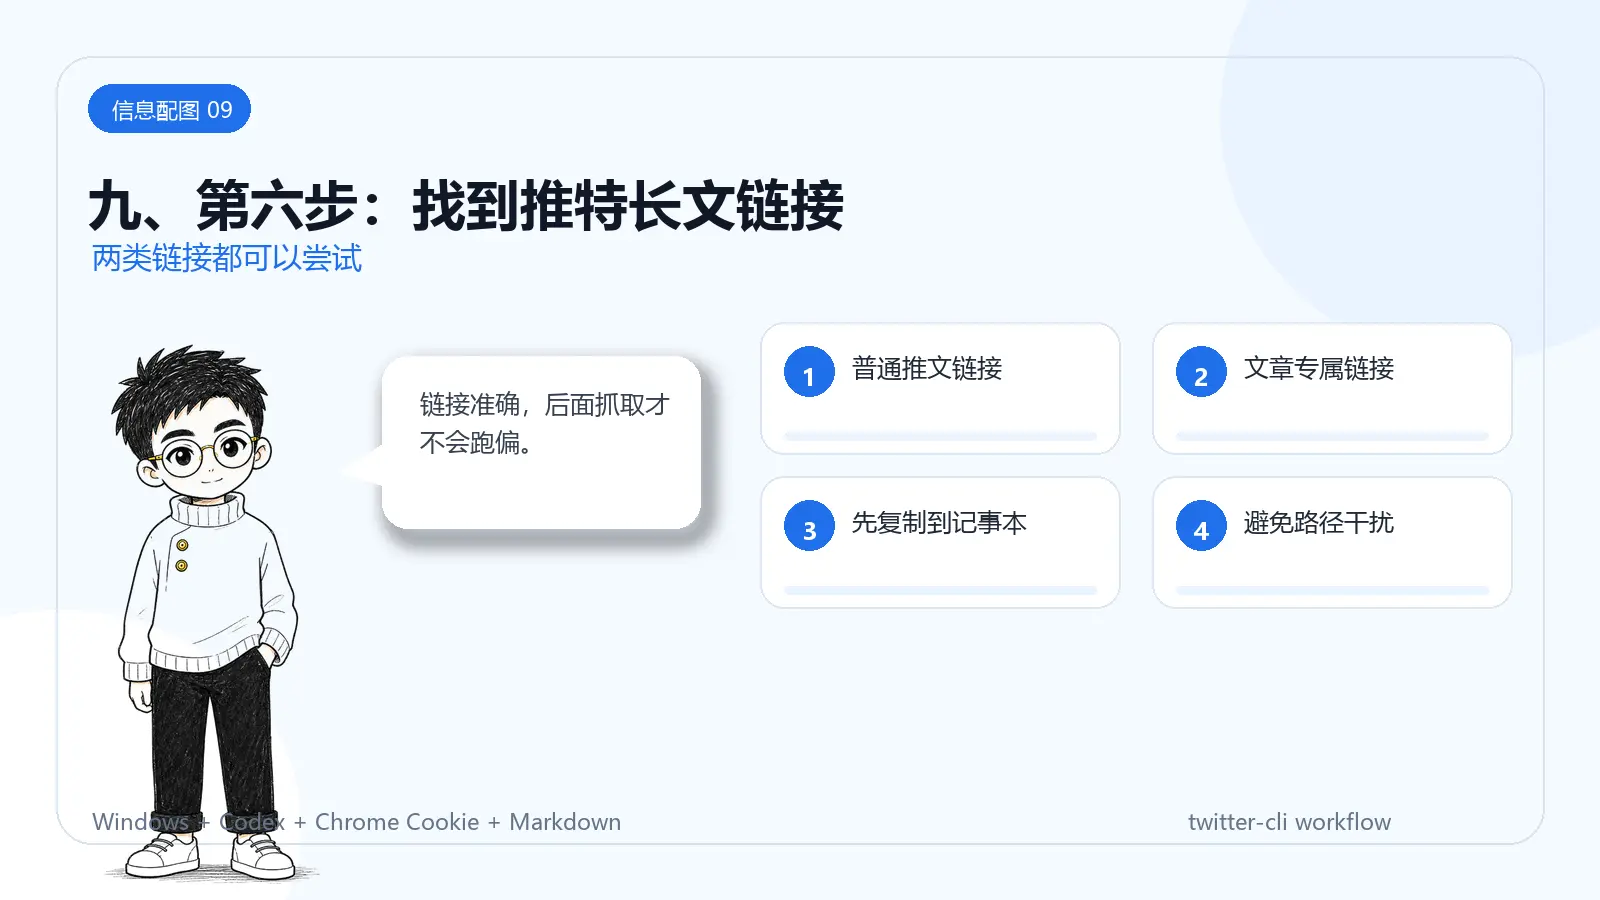
本教程指导新手如何抓取 X/Twitter 长文并保存为 Markdown 文件。步骤包括安装 Python、创建工作目录、安装抓取工具、导出登录 Cookie、使用命令行抓取长文以及将 HTML 转换为 Markdown。建议先测试一篇文章,确保流程顺利后再进行批量操作。
Strava因应AI抓取工具的影响,开始限制API访问,开发者需支付每月11.99美元的订阅费,以应对抓取行为对平台性能的影响。同时,Strava推出新工具,允许用户将健身数据链接到Claude,但API限制不影响可穿戴设备的整合或用户免费下载数据的能力。
这篇文章介绍了一个全栈网页抓取课程,旨在帮助用户绕过现代网站的反自动化检测。课程由Gavin Lon开发,内容涵盖使用Playwright和Cheerio工具、配置住宅代理和浏览器指纹,以及构建可视化实时数据的MERN应用。课程在freeCodeCamp.org的YouTube频道上提供,时长6小时。
网络数据生成量巨大,开发者面临可靠抓取的问题。传统抓取依赖选择器提取数据,但结构变化会导致失败。AI抓取通过理解内容而非结构提取数据,适应性更强。两者各有优劣,结合使用更为有效。
SerpApi正在与谷歌进行版权诉讼,谷歌指控其以欺骗手段抓取搜索结果。SerpApi辩称,谷歌并不拥有搜索结果的版权,其抓取行为与谷歌相似但规模较小,并认为谷歌的反抓取工具仅保护其商业利益,而非版权内容。
Spotify确认其平台被抓取300TB音乐文件,涉及99.6%的歌曲。相关账号已被封禁,并加强了安全措施。
谷歌今日对爬虫公司SerpApi提起诉讼,指控其非法抓取受版权保护的内容并绕过安全措施,旨在保护网站和版权方的权益。谷歌遵循行业标准的爬虫协议,而SerpApi则通过隐蔽手段侵犯这些协议,影响内容提供者的选择权。
谷歌今天起诉爬虫公司SerpApi,指控其非法抓取版权内容并绕过安全措施,旨在保护网站和版权持有者的权益。谷歌遵循行业标准的爬虫协议,而SerpApi则通过不当手段获取内容。
Bright Data的Web Scraper API为2026年AI模型提供动态网站支持、反机器人自动化和全球覆盖,特别适合数据驱动团队。与Oxylabs、ScraperAPI和Apify相比,Bright Data在灵活性、可靠性和规模上表现更佳,是网络抓取的首选。
文章比较了四大代理服务提供商:Bright Data、Oxylabs、Infatica和NetNut,指出Bright Data在全球覆盖、合规性和反机器人技术方面的优势,适合高需求的企业级数据抓取。
本文探讨了如何实现dotmemory软件的自动化快照抓取,介绍了测试代码和自托管的方法,通过代码控制快照时机,提升了效率,并展示了在不同平台上使用Console版进行内存分析的方式。
完成下面两步后,将自动完成登录并继续当前操作。