文章以AI代理误删生产数据库为例,指出平台安全的关键不在代理本身,而在能否吸收格式规范却完全错误的变更。作者主张用GitOps分层防护:测试、配置抽象(kro、Score)、Kubernetes内置保护(RBAC、Kyverno、finalizer)、云厂商删除保护及人工审查。核心是“按权限而非信任设计”,将破坏性操作收敛为显式设置protected: false,使人和代理都无法意外造成破坏。
Steve Yegge 提出“Counting House”模式:企业高吞吐业务不应让 AI 自由行动,而应将其变为无长期记忆、无独立凭证、每次只处理一个任务的数字职员。AI 只提议操作,由确定性编排器验证资格、保证幂等并执行事务。企业须先建立人工基线、黄金样本和错误成本评估,再按影子、辅助、自主响应、自主交易逐级授予权限。核心资产是自有数据和评估体系,模型可替换。
本书提出智能体AI可靠性验证方法:不信任最终回答,而是从权威状态独立核验执行过程与业务结果。核心是区分响应正确性与结果正确性,按响应、步骤、动作、工作流、系统五层判定,结合六类评估活动、故障注入、轨迹与护栏检查,形成可复现的发布证据。附录提供术语定义、外部参考文献及生产就绪清单,按工作流逐项签核,以最弱项决定发布。
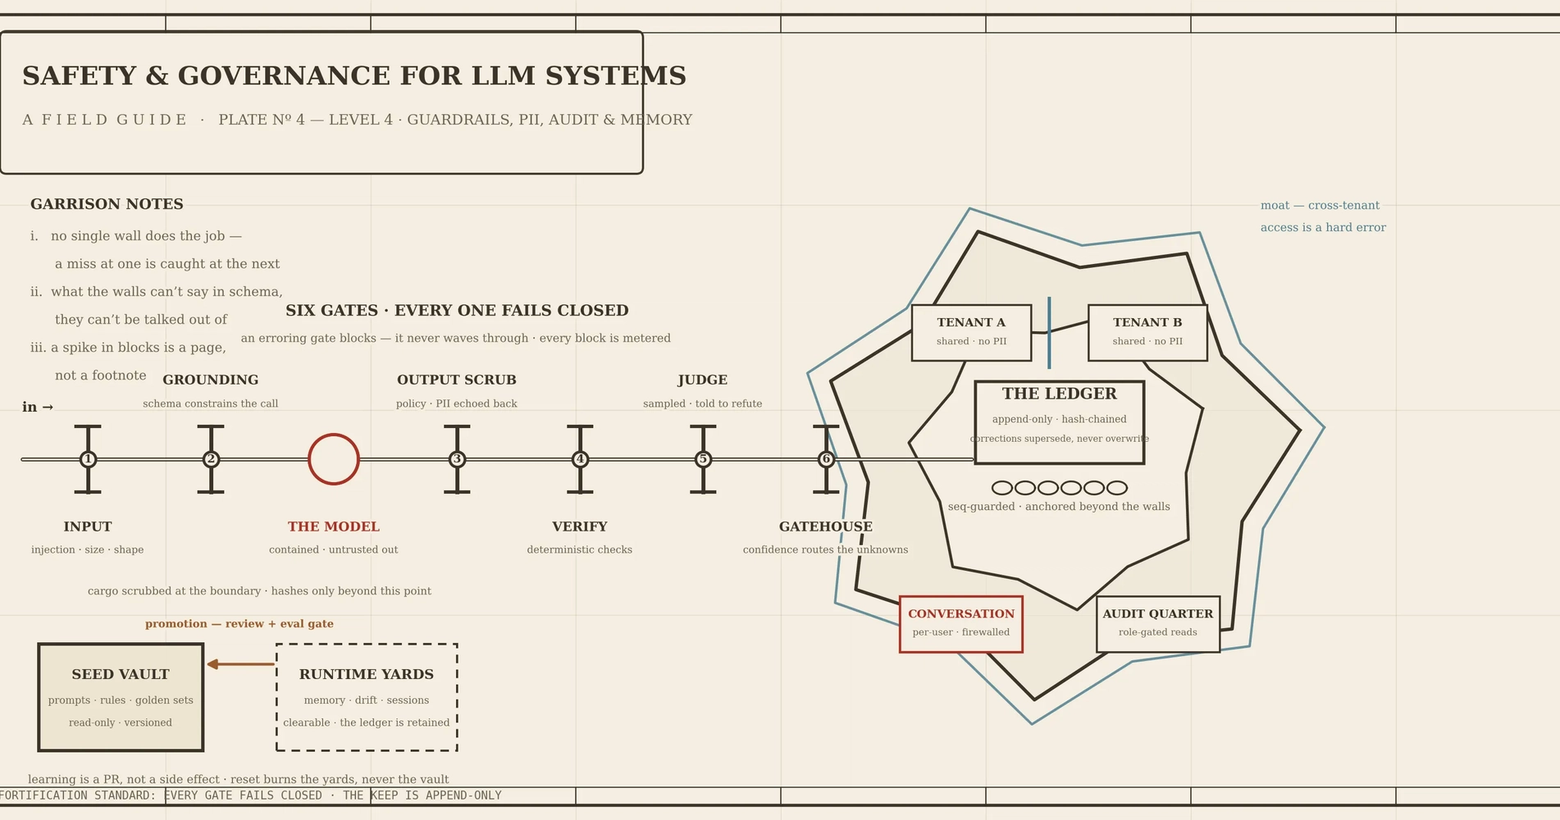
LLM生产系统成熟度模型第四级聚焦安全与治理,核心为四层防护:护栏分层且失败即阻断;输入输出边界处脱敏PII,并用HMAC哈希替代原始存储;审计账本仅追加、哈希链防篡改;记忆按租户和用户分类隔离。同时区分随版本发布的种子配置与运行时积累状态,重置仅清运行时,学习须经评审合并。
文章主张平台策略应从默认拦截的“关卡”转向随行纠偏的“护栏”。策略引擎具备验证、变更、生成、校验四项职能,但多数团队90%的精力用于验证。应更多使用变更与生成,自动补全配置、搭建命名空间,让开发者几乎无感。策略应由平台团队主导、安全团队参与,并像产品一样渐进发布。
AI编码代理的护栏与模型同样关键。基准测试显示,护栏的启动开销和缓存命中率显著影响成本,差距可达数倍,而任务成功率仅差几个百分点。企业应关注每次验证结果的成本,而非单纯比较令牌数。护栏选择对成本影响巨大,值得与模型同等重视。
OpenConnector是一个开源连接器网关,使AI Agent能够安全调用GitHub、Gmail等SaaS服务。其核心价值在于统一认证、权限控制和审计,但需关注动作级权限和可观测性。建议从低风险场景试用,确保权限边界清晰、调用记录完整,才能从Demo工具变为可靠基础设施。
2026年上半年公开的Agent专利聚焦记忆、防幻觉和自愈三大问题,解法均从模型外拆出组件,如知识图谱存储、反推问句检测和失败重放。门槛低,个人可用开源工具一周内实现MVP,月成本数百元。机会在于护栏SDK和Agent质检交付,大厂忽视薄利层,适合小团队切入。
OpenClaw开源框架通过三层定制(路由闸门、任务清单、记忆体)和五道护栏(任务体检、工具白名单、完成追踪、报警通道、信任等级)改造,两个月内形成自动化运营团队。尽管遇到AI沉默出错、擅自改主意等问题,但通过护栏和人工监督实现稳定运行,证明开放框架加定制护栏可产出可靠AI打工人。
Kimi K3以250美元成本、10小时修复15个致命漏洞,性能超越因安全限制而拒绝操作的OpenAI和Anthropic模型。美国AI过度监管导致生产力下降,开发者转向中国模型,凸显性价比优势并引发地缘政治竞争,市场选择能解决问题的AI。
Fable 5成功发现并清除电脑病毒,但因执行安全操作被降级,反映出AI安全系统的矛盾。用户希望AI能有效处理安全问题,但系统因关键词触发限制,导致AI能力受限。未来的安全策略需理解上下文,以避免误判。
中国科学技术大学提出了一种新型AI安全验证方法ePCA,利用一阶逻辑和SMT求解器实现可证明的安全性。与传统经验语义护栏相比,ePCA有效防止绕过,实验结果显示攻击成功率和误报率均为零,核心验证延迟仅为0.44毫秒。该方法适用于金融操作和敏感数据访问等高安全性场景。
AgentDoG 1.5 是一个轻量级的安全对齐框架,利用轨迹级诊断引擎和推理增强方法,实现静态安全分类到动态实时防护的转变。该框架识别跨步骤的累积风险,提升安全判断准确性,并支持免训练在线护栏设计,降低部署复杂度。研究显示,7B 参数模型在 R-judge 基准测试中达到了 GPT-5.4 级别的安全性能,为中小团队提供高效的安全解决方案。
Anthropic发布的网络安全模型Fable因过于严格的安全护栏引发争议,导致安全研究人员无法正常使用。模型会因关键词拒绝请求,甚至降低服务质量,损害用户信任。尽管Anthropic已道歉并调整政策,但信任已受损。
文章主张从“氛围编程”转向“工程护栏”,为AI编程建立可执行、可验证、可恢复的流程,核心是管理任务边界、上下文路由、验证循环和失败处理四件事。失败需分类为停止、重试、修补护栏或记录;外部搜索只解决具体工程问题,结论应沉淀为规范或测试。建议先落实三步:写清完成标准与范围、编辑前列出证据与改动面、失败后先补测试或规则。
SkipLabs创始人Julien Verlaguet质疑AI护栏建设,认为许多声称只是更好的提示。他开发了Skipper工具,专注于生成和维护后端服务,以提高AI输出的可读性和可维护性。Verlaguet强调,真正的护栏应从基础构建,而非简单声称。
本文介绍了一种生成AI开发平台,旨在提升编码代理的生产力并减少错误。该平台设有四个主要护栏:预提交检查清单、预提交Git钩子、GitHub Actions工作流和自动化拉取请求审核,以确保代码质量,防止低质量代码生成。未来将介绍更多平台功能。
本文介绍LLM智能体的构建方法:智能体由模型、工具和指令三部分组成,可自主完成多步骤工作流,适用于复杂决策、规则难维护及非结构化数据场景。建议先用最强模型建立基线,再逐步换用更小模型以优化成本与延迟。编排上应先最大化单智能体能力,必要时再采用管理器或多智能体交接模式。护栏涵盖相关性、安全、PII过滤及人工介入,应分层部署并持续迭代。
风险管理在交易中至关重要。止损可以保护本金,避免小错误导致大损失。设定止损时需明确风险上限、入场和止损价格,并计算仓位。遵循四步法,避免系统性风险,确保长期生存。
AI安全公司HiddenLayer的研究发现,主流大语言模型(如GPT-5.1、Claude和Gemini)存在EchoGram漏洞。攻击者可利用特定词语绕过防护,导致恶意请求被误判为安全,或无害请求被视为危险。这可能引发安全团队的“警报疲劳”,降低系统信任度。研究者警告开发者需在约3个月内修复此漏洞,以应对AI的广泛应用。
完成下面两步后,将自动完成登录并继续当前操作。