本文介绍了InstructMining和DiverseEvol等方法,用于选择高质量的指令数据以优化大型语言模型的微调。研究表明,这些方法能够在有限数据下保持或提升模型性能,并通过多样性和质量的筛选显著降低训练成本。此外,研究系统回顾了现有数据选择方法,提出了新的分类法和数据合成方法DELIA,以提升模型的适应性和性能。
本文综述大语言模型指令调优研究,涵盖Auto-Instruct自动生成并排序候选指令、MultiInstruct构建多模态指令基准、InstructionGPT-4用少量高质量数据微调多模态模型、Instruct-Imagen实现异质图像生成,以及Self-Instruct、CoachLM、InstructMining等方法提升指令数据质量与模型遵循能力。
该文汇总多项大语言模型数学推理研究:通过数学文档预训练、自动生成与修订指令数据,构建MetaMath、MAmmoTH、TheoremQA等数据集和模型,提升数学推理与指令跟随能力;并提出AutoMathText自主数据选择策略,以更少token显著提高下游性能。
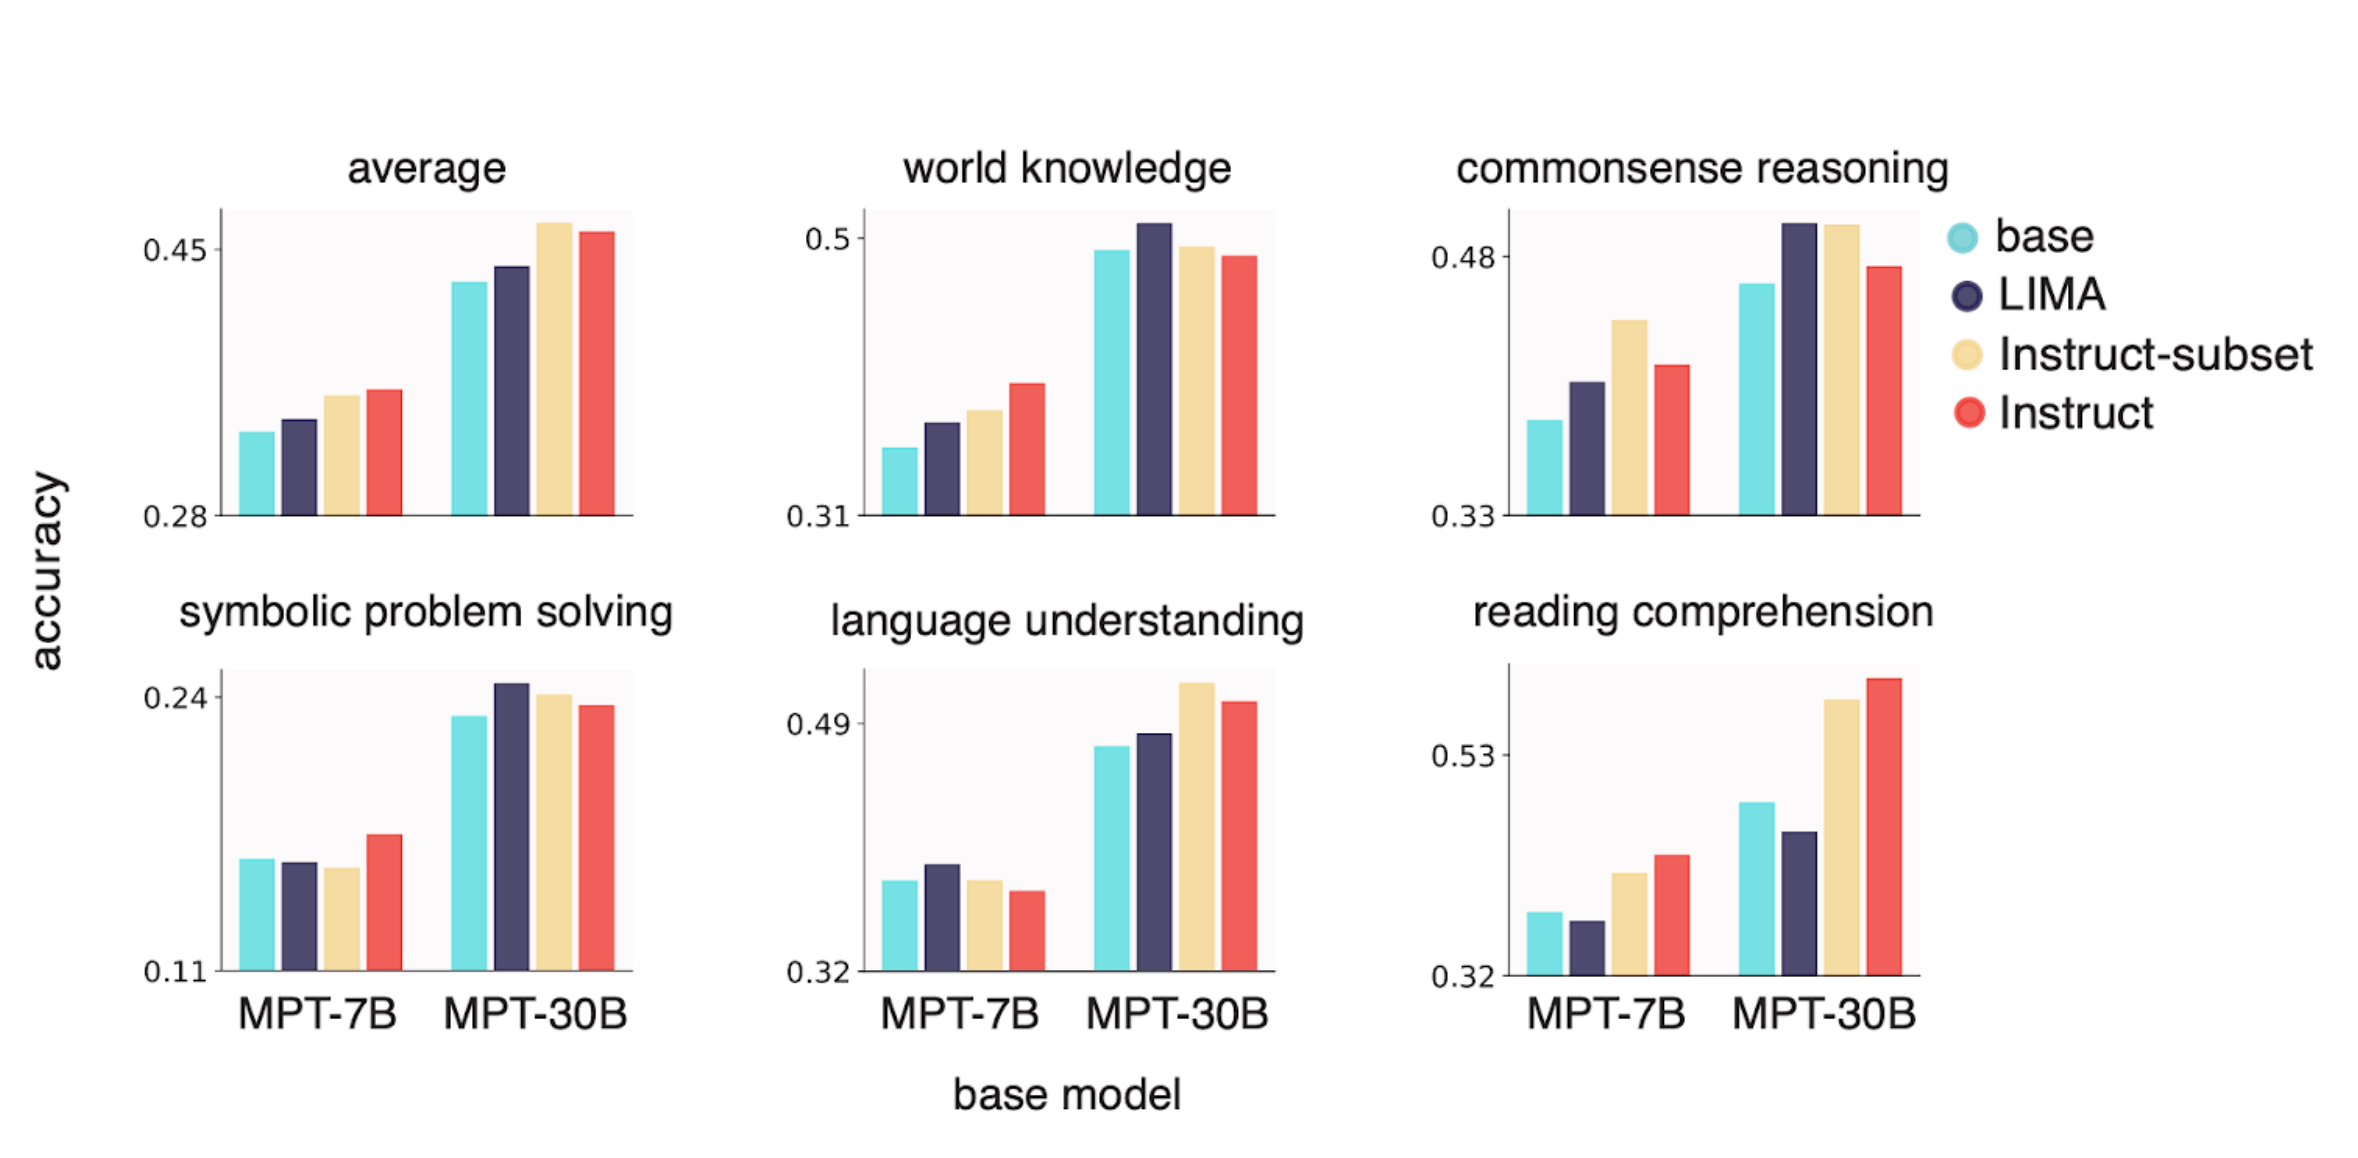
研究探讨大语言模型微调:少量高质量样本(如LIMA的1000条)可提升模型表现,但效果取决于数据与评估方式的匹配。实验发现,混合LIMA与指令数据微调能同时提升传统NLP基准和GPT-4评判的对话质量,兼顾两种评估范式。
本文介绍了一种使用大型语言模型(LLM)替代人类创建指令数据的方法,通过使用Evol-Instruct逐步重写初始指令集,生成更复杂的指令,并混合生成的指令数据以调整LLaMA模型,得到WizardLM模型。人类评估证明,Evol-Instruct生成的指令优于人工创建的指令,尤其在高复杂度方面,WizardLM模型的输出被认为比OpenAI ChatGPT更好。研究表明,用人工智能生成的指令进行微调是提升大型语言模型的有前途的方向。
本文介绍了使用大型语言模型(LLM)替代人类创建指令数据的方法,通过Evil-Instruct逐步重写指令集,混合生成的数据以调整LLaMA模型,获得WizardLM模型。人类评估证明,Evil-Instruct生成的指令优于人工创建的指令,尤其在高复杂度方面,WizardLM模型的输出比OpenAI ChatGPT更好。研究表明,用人工智能生成的指令进行微调是提升大型语言模型的有前途的方向。
完成下面两步后,将自动完成登录并继续当前操作。