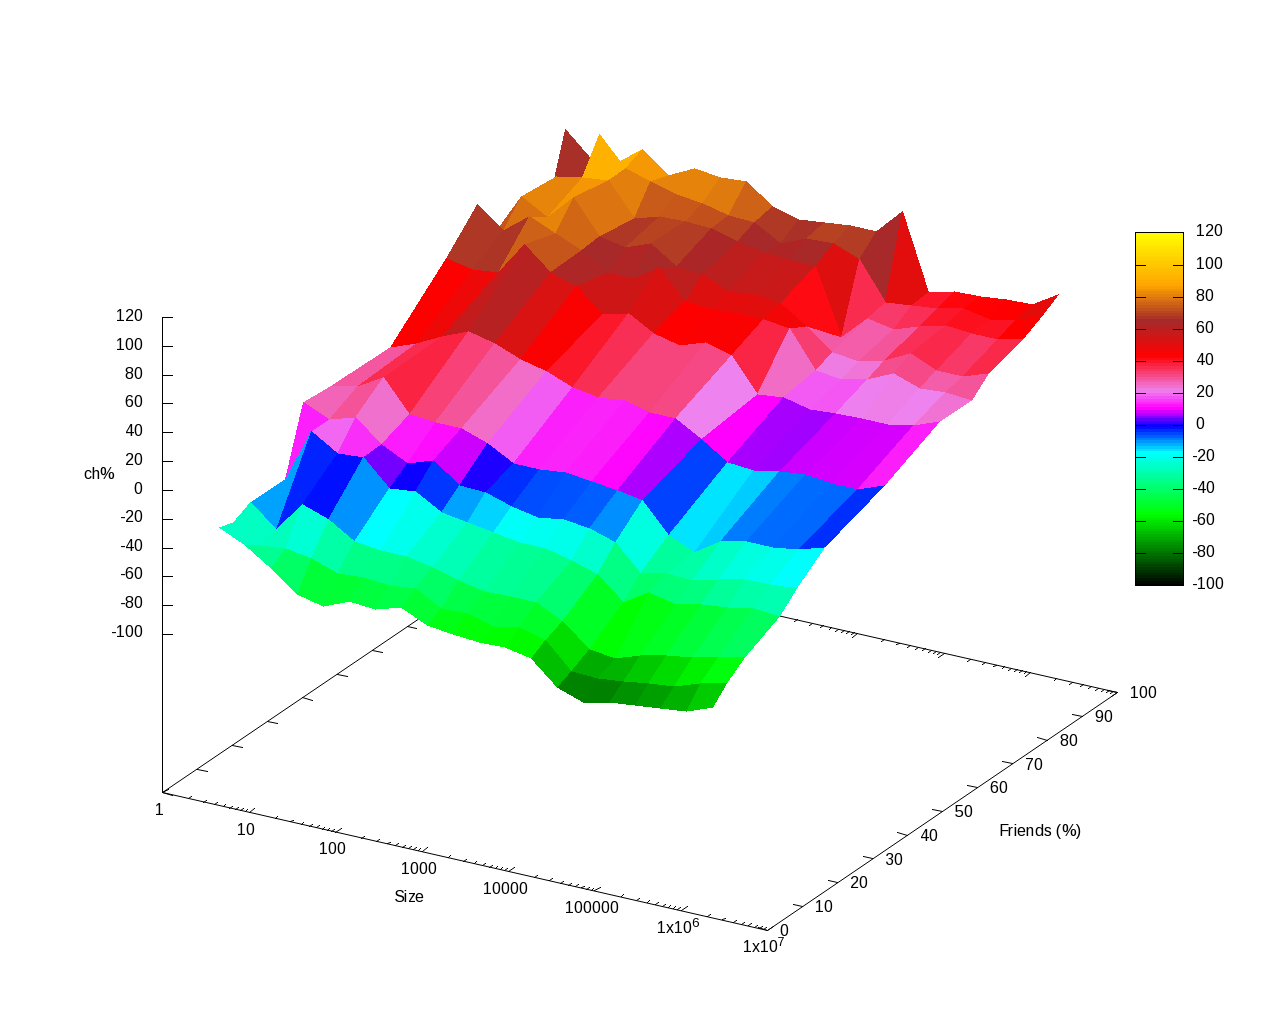
文章比较了在Perl中按@order顺序排列@friends的两种方法:一是用哈希记录位置后排序;二是用哈希标记好友,再遍历@order筛选。基准测试显示,好友比例小时第二种更快,好友接近全部时第一种更快。
欧盟7月因谷歌违反《数字市场法案》对其罚款8.9亿欧元,其中4.6亿欧元针对搜索偏袒自家服务,4.3亿欧元针对Play Store限制开发者引导站外购买。谷歌已调整搜索结果展示并部分修改Play Store费用,欧盟正评估整改是否合规,未达标可能面临每日罚款。
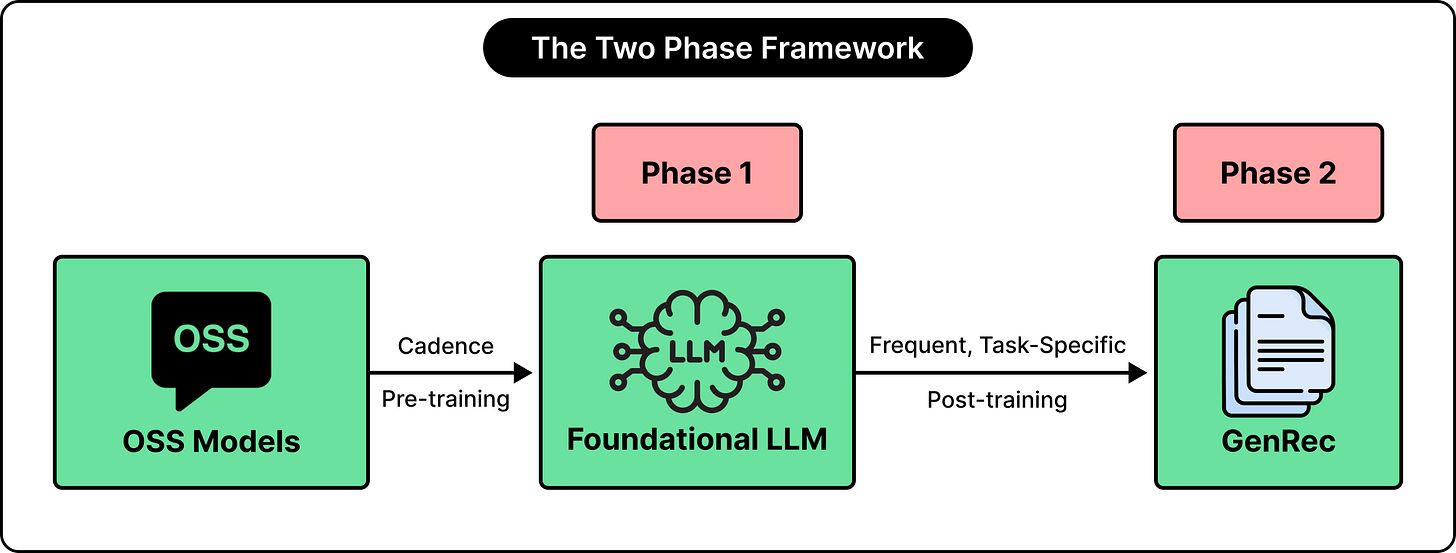
Netflix 构建了基于大语言模型的 GenRec 推荐系统,分两阶段训练:先让开源模型学习 Netflix 内容与用户行为,再针对排序任务微调。系统将用户观看历史等转为文本,经上下文工程压缩后输入模型,由排序头对目录内容打分,并采用仅预填充推理降低成本。离线与 A/B 测试显示首页互动指标有提升。
排序稳定性指排序后相等元素的相对位置保持不变。稳定排序算法包括冒泡、插入、归并和基数排序;不稳定算法包括快速、堆、希尔和选择排序。选择排序和快速排序因交换操作破坏稳定性,归并排序在合并时优先取左侧元素而保持稳定,并附有Java代码验证。
该文本仅为付费阅读页面的提示信息,无实质文章内容,无法进行内容摘要。
搜索效果差时,不应只升级重排序模型。大规模重排序成本高、延迟大,且候选池本身没有好结果时重排序也无能为力。更优方案是将检索设计为多阶段漏斗:先用低成本词法、向量或混合检索生成大量候选,再逐步收窄,最后才用机器学习重排序。该思路同样适用于RAG,需权衡召回率、相关性、延迟与成本。
jevgrep 是面向编程 Agent 的 CLI 检索工具,采用 Jev 评估模型进行递归代码发现,无需建索引,可避免索引漂移。在 SWE-bench 实测中,任务成本从 7.62 美元降至 4.52 美元,节省约四成。其流程分四步:层级遍历、内容预览、AST 解析、上下文打包,输出精确到行号的代码片段。使用时需安装 skill 让 Agent 学会调用,但长会话中 skill 易被压缩失效,且省钱同时解题率略降。
排序不等式是一个经典的不等式,本身不难理解,很多读者可能在中学阶段就已经了解过它,尤其是准备过数学竞赛的同学。但排序不等式也远不止表面上那么简单:它在矩阵世界中有一个深刻的对应物——冯·诺伊曼迹...
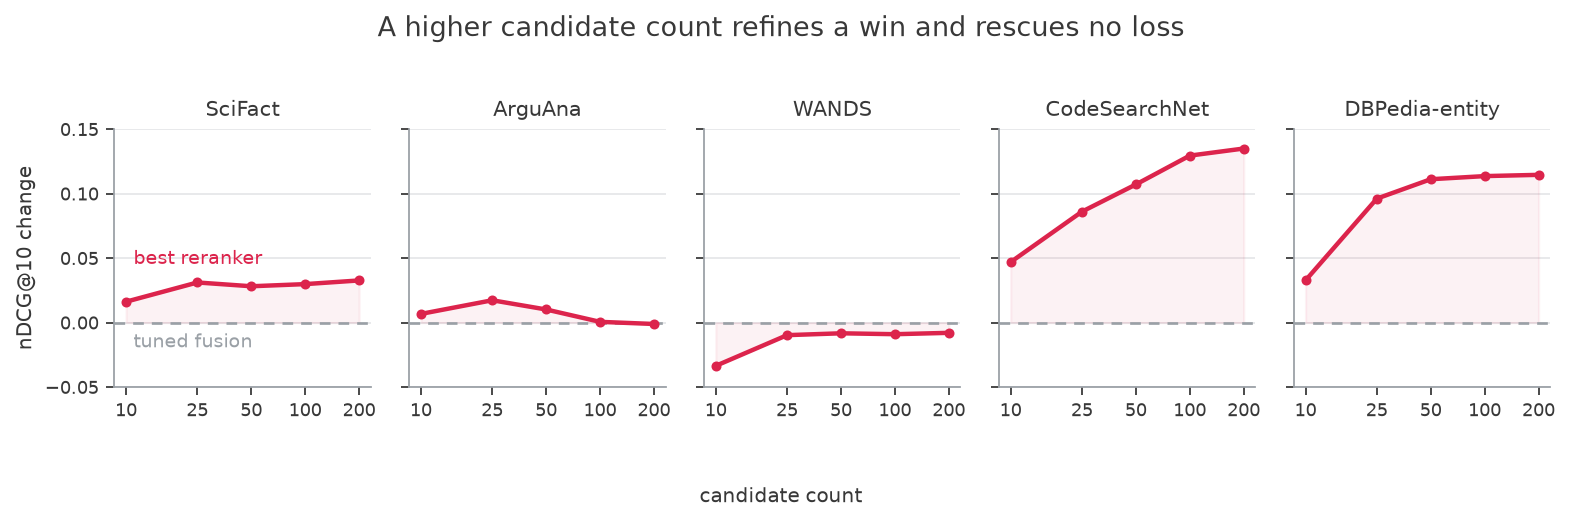
在调整重排序器前,需先验证索引状态并建立基线。通过nDCG@10评估候选列表与理想排序的差距,若差距大则值得优化。测试时先用10个候选,对比交叉编码器与调优融合的基线,仅在重排序器胜出时增加候选数。确认模型与语料匹配,并检查吞吐量。若失败,诊断模型窗口或训练域不匹配,或保留融合。生产环境需测量延迟,并考虑其他阶段如多样性或分组。
本文讨论何时值得使用重排序模型:先用nDCG@10衡量候选列表与理想排序的差距以判断提升空间;测试分三步,建立基线、用交叉编码器重排10个候选、与调优后的融合结果对比;仅通过留出验证的增益才值得上线,若模型窗口或训练领域不匹配则放弃;确认胜出后再增加候选数并测量吞吐量。
美团技术团队将LLM语义表征应用于搜索排序,提升语义匹配能力。工程落地需关注成本、延迟、缓存和回滚,建议按场景灰度并拆分监控。跨场景复用可降本,但需明确边界和降级策略。普通团队应先小范围验证,列清延迟、更新频率、降级和监控四张表,视其为长期维护的基础设施。
本文讨论了PostgreSQL中checkpoint_timeout设置对高可用性的影响,指出即使有HA副本,若主库重启耗时过长,副本也可能面临同样问题,因此建议保持默认值以确保稳健性。随后介绍了Postgres排序规则更新项目,包括使用Docker和GitHub Actions进行测试,并提及使用OpenAI Codex的Luna模型以低成本高效完成项目,展示了其性价比。
价值观是回答“什么值得”的排序,而非列举;清单免费,排序昂贵。它功能是省事,让选项不再计算。未探究会套用社会默认,嫉妒比成就感诚实,环境大于反思。只有付出代价时价值观才被测量,观察时间、金钱、注意力流向可反推真实价值观。
Meta广告推荐系统采用多阶段序列模型架构,将离线用户建模与在线排序解耦,结合密集分词和目标感知注意力,实现LLM式可预测扩展。该方案提升Instagram转化率6%、Facebook转化率3%和广告点击率3.5%,并作为GEM核心组件,支持模型规模高效扩展。
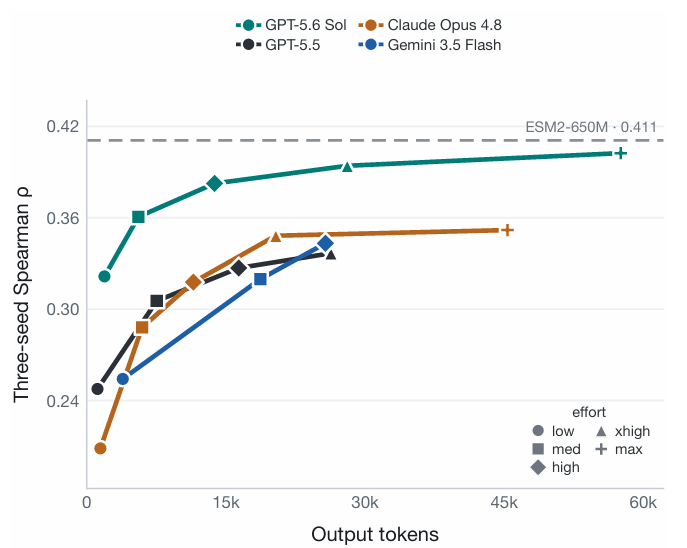
哈佛大学等团队提出PG-LLM基准测试,首次统一评估13款通用语言模型与95种专业蛋白质预测工具。结果显示,Claude Opus 5等通用模型在蛋白突变排序上超越半数专业工具,但落后于顶尖模型VenusREM。研究揭示通用模型随推理资源增加性能提升有限,且对候选集规模敏感,为蛋白质工程工具选择与融合提供新思路。
优先排序框架常流于形式,浪费时间且难以验证。最佳策略是放弃优先排序,转而加快构建速度,或取消跨目标优先排序,让团队专注固定领域。快速执行比聪明决策更重要,能提升效率并减少内耗,最终带来更好结果。
本文介绍RAG流水线中的重排序(reranking)层,旨在解决检索结果中相关文档排名靠后的问题。文章比较了交叉编码器、双编码器和LLM重排序器三种模型类型,强调选择需权衡延迟、成本和语言覆盖。生产实践中,建议采用混合检索提升召回率,并注意校准阈值、控制成本,Redis Iris可集成这些功能以优化性能。
该文章介绍OLAP数据库引擎的最终阶段,实现排序、并行执行、REPL和TCP服务器。排序操作符支持多键和NULL排序;并行执行采用morsel驱动,每个worker独立处理行组并合并局部聚合结果;REPL提供交互式SQL查询和元命令;TCP服务器支持远程连接。最终形成完整的列式数据库引擎,从SQL解析到查询结果全流程运行。
文章探讨个性化推荐的架构问题,指出许多团队面临的并非数据或算法质量不足,而是系统架构碎片化,导致检索、排序和业务逻辑分离,信号延迟且不完整。作者主张将个性化视为实时排序问题,通过统一管道整合文本、向量、用户行为及业务规则,并使用张量计算实现灵活评分,从而提升相关性和响应速度。
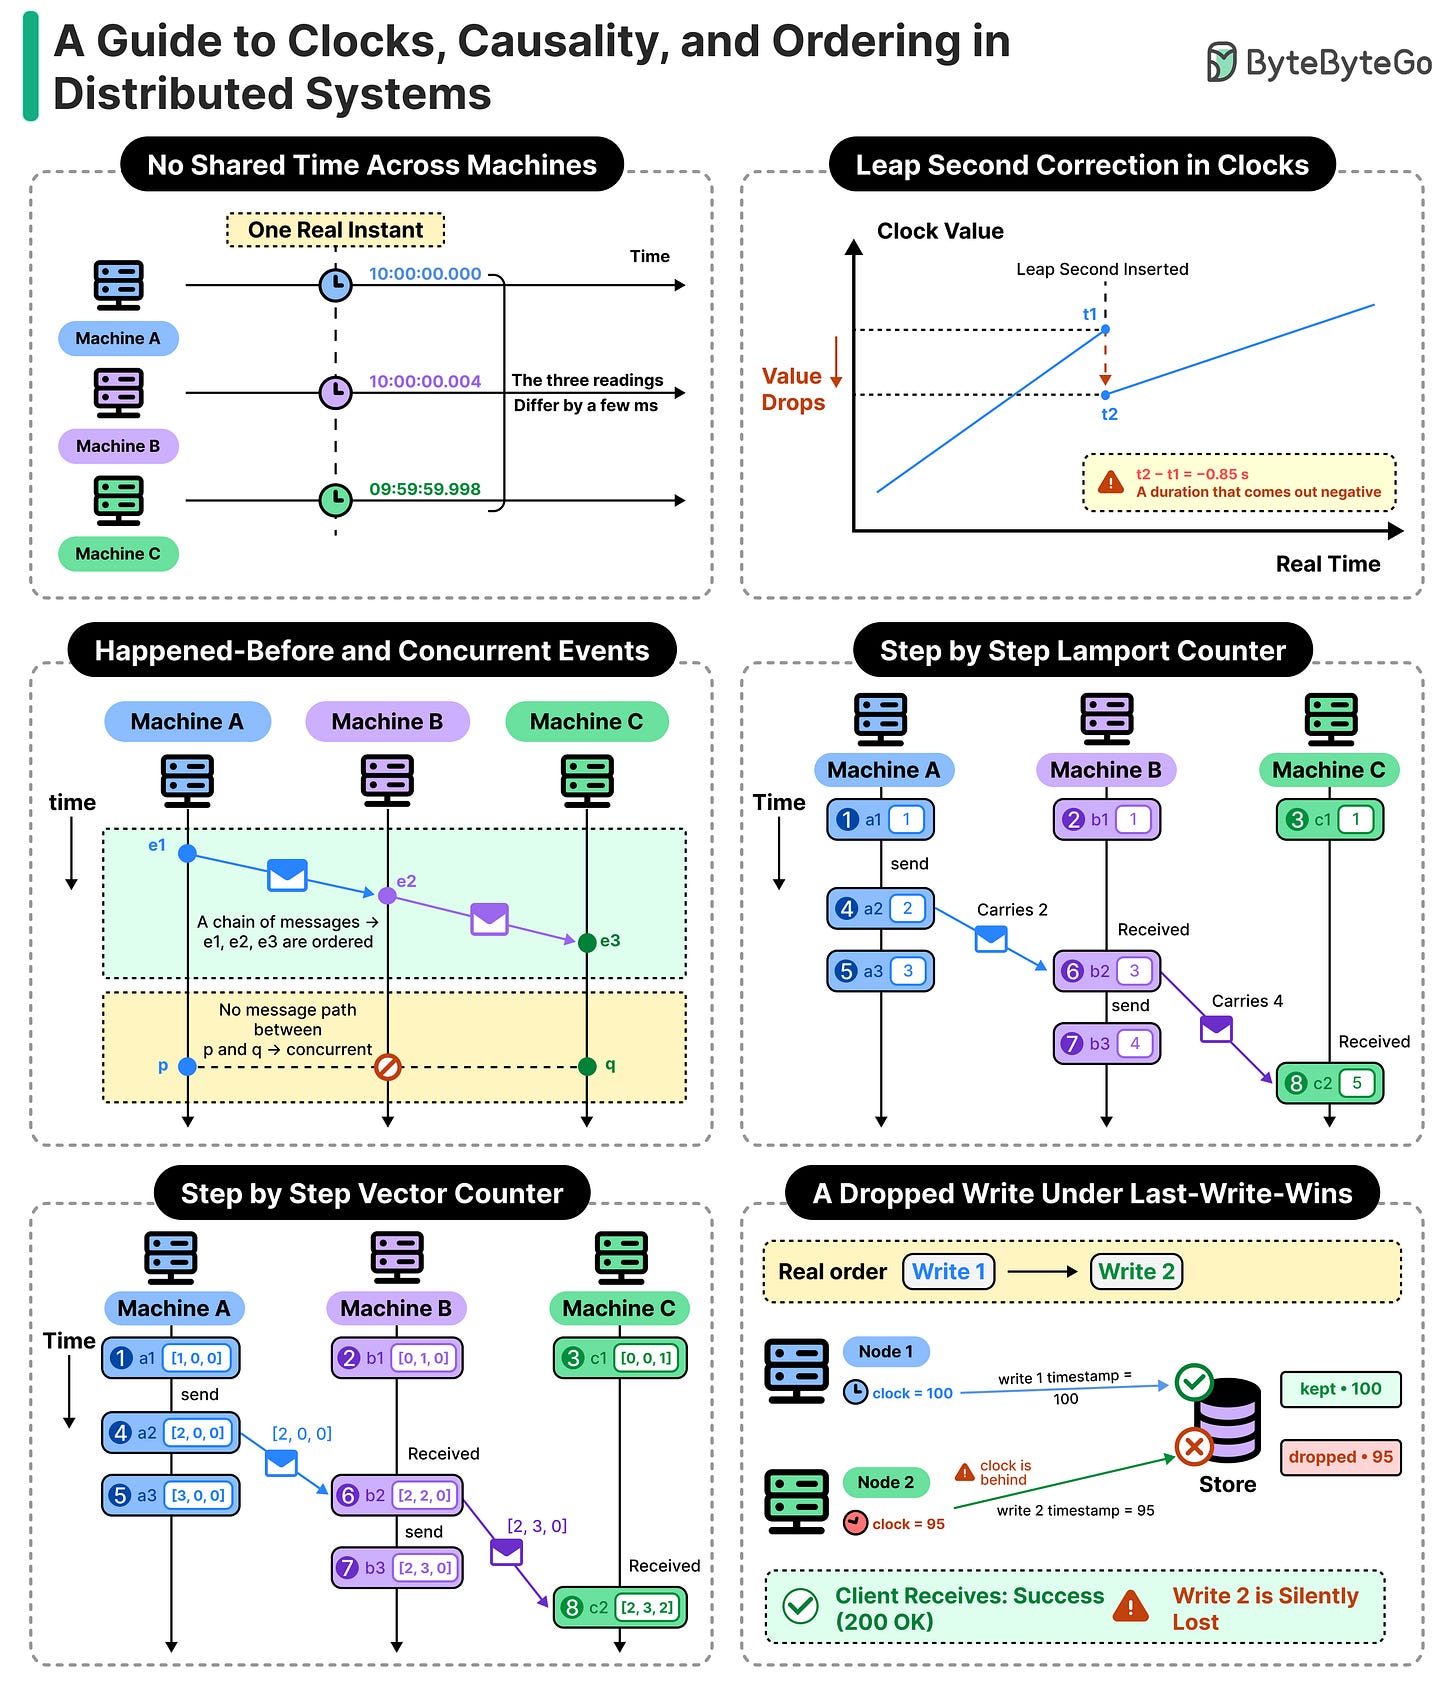
分布式系统中,机器时钟不同步导致事件排序困难,NTP无法完全解决时钟漂移问题,可能引发更新丢失、日志因果颠倒等错误。文章探讨了逻辑时钟、向量时钟及混合逻辑时钟的用途与局限,并介绍Google Spanner等数据库如何通过全局时钟实现大规模事件排序,强调正确排序对复制、审计和调试的重要性。
完成下面两步后,将自动完成登录并继续当前操作。