

小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
使用 Lakeflow Connect 统一您的营销数据

Lakeflow Connect 提供全托管原生连接器,可将 SaaS、数据库和文件数据直接增量摄取为 Unity Catalog 中的受治理表,无需自建管道。它覆盖营销、CRM 和广告平台,解决 Customer 360 数据碎片化问题。EcoVadis、iManage 等客户借此快速接入 HubSpot、Salesforce 等数据,节省工程时间。广告连接器还输出已聚合的报表表,并支持 Ad-Genie 加速器实现可视化与对话式分析。

使用 Lakeflow Connect 统一您的营销数据

Databricks Databricks · 2026-09-11T18:00:00Z
数据管道最佳实践:架构、现代管道与部署

数据管道是自动化系统,用于将原始数据从源系统转移、转换为可用格式并交付给目标系统。有效的数据管道架构包括数据摄取、处理、存储和监控。选择批处理或流处理模式是关键决策,现代架构应以业务需求为基础,确保数据质量和治理。采用增量加载、自动化CI/CD和全面可观察性是提高管道可靠性的最佳实践。

数据管道最佳实践:架构、现代管道与部署

Databricks Databricks · 2026-06-18T16:14:42Z
刘桥生:发布 pg_ducklake v1.0

pg_ducklake将于2026年6月发布v1.0版本,提供完整的DuckLake工作流,支持PostgreSQL SQL的多种功能,包括DML、时间旅行和ACID事务。该扩展独立于pg_duckdb,优化了数据写入速度,适合OLTP数据库,支持快速数据摄取和角色访问控制。未来将继续增强功能,欢迎用户反馈需求。

刘桥生:发布 pg_ducklake v1.0

Planet PostgreSQL Planet PostgreSQL · 2026-06-17T00:00:00Z
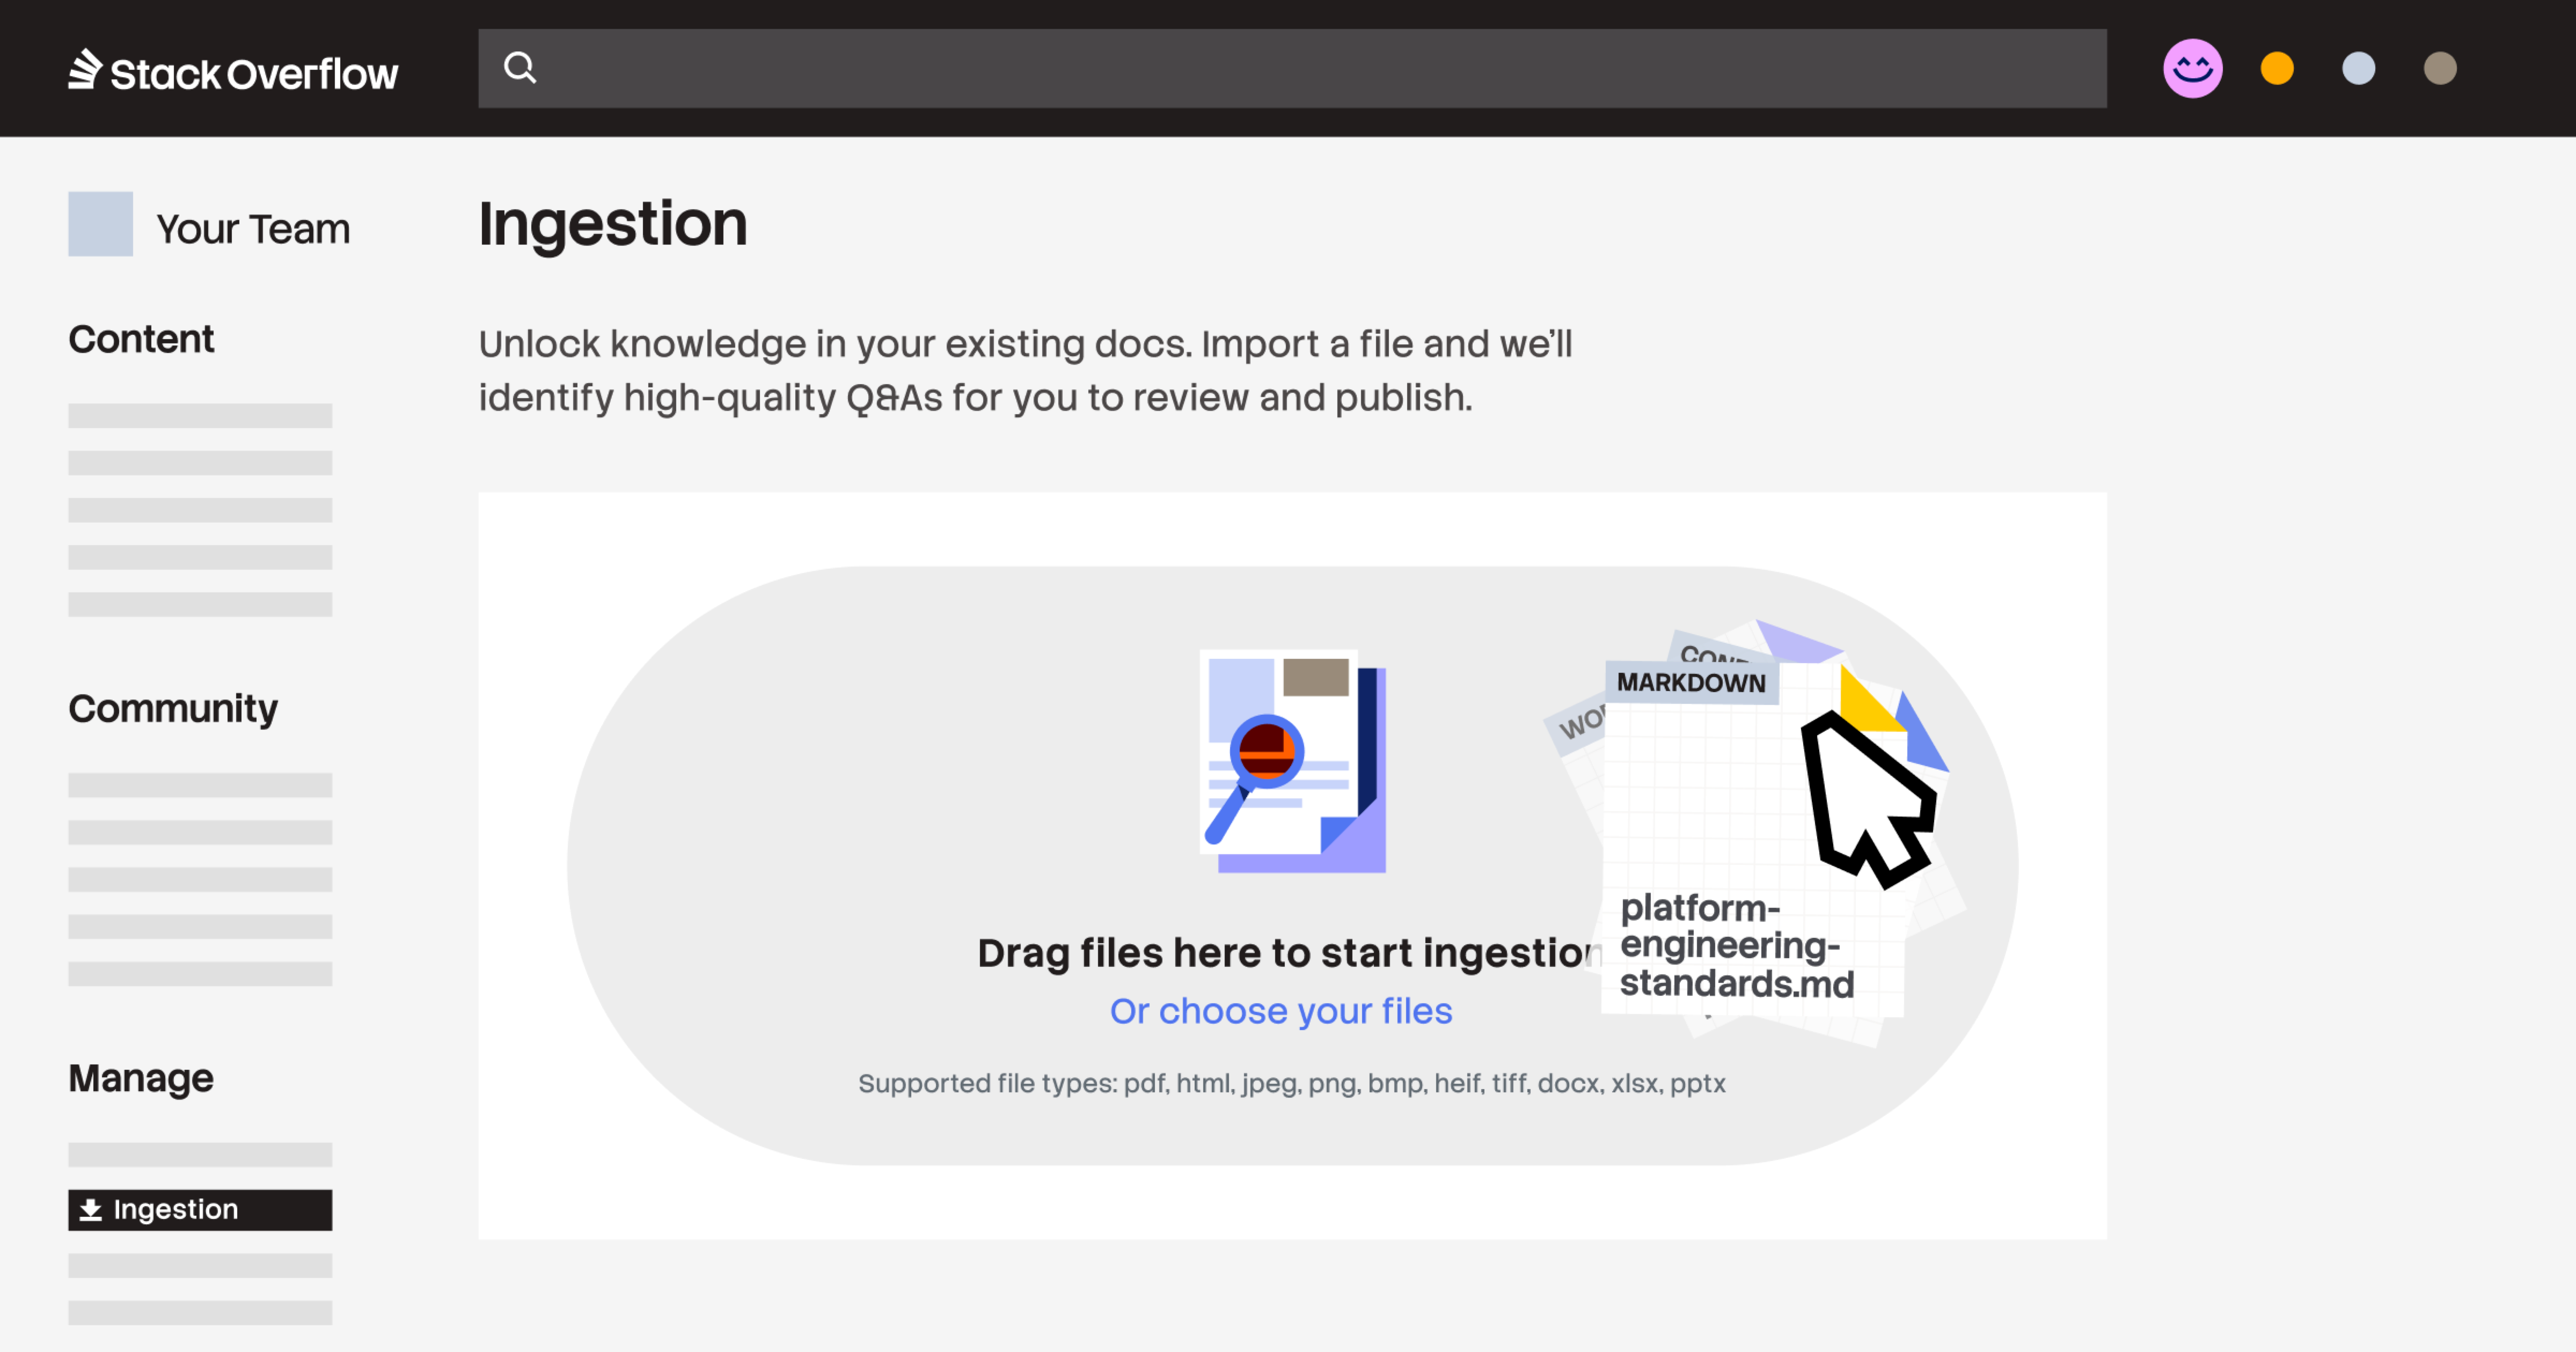
将分散的知识转化为可信的智能:Stack Internal 2026.3

Stack Internal 2026.3版本推出了数据摄取功能,允许用户将分散内容转化为结构化知识,提升团队和AI工具的可靠性。该功能支持多种文件格式上传,并自动生成问答对,简化知识管理流程。通过连接Confluence,用户可以将静态页面转化为易于发现和维护的内容,确保数据实时更新和有效利用。

将分散的知识转化为可信的智能:Stack Internal 2026.3

Stack Overflow Blog Stack Overflow Blog · 2026-04-28T13:00:00Z
如何构建开源数据湖以实现批量摄取

云数据分析平台如Databricks、Snowflake和BigQuery简化了数据平台的创建。本文介绍如何在开源数据湖堆栈上设置批量摄取层,确保用户拥有所有组件。重点在于建立可靠的数据摄取流程,使用Apache Airflow调度任务,并结合RustFS、Apache Iceberg和Project Nessie等技术,以实现高效的数据摄取和后续分析,确保数据的可靠性和可扩展性。

如何构建开源数据湖以实现批量摄取

freeCodeCamp.org freeCodeCamp.org · 2026-04-16T14:26:47Z
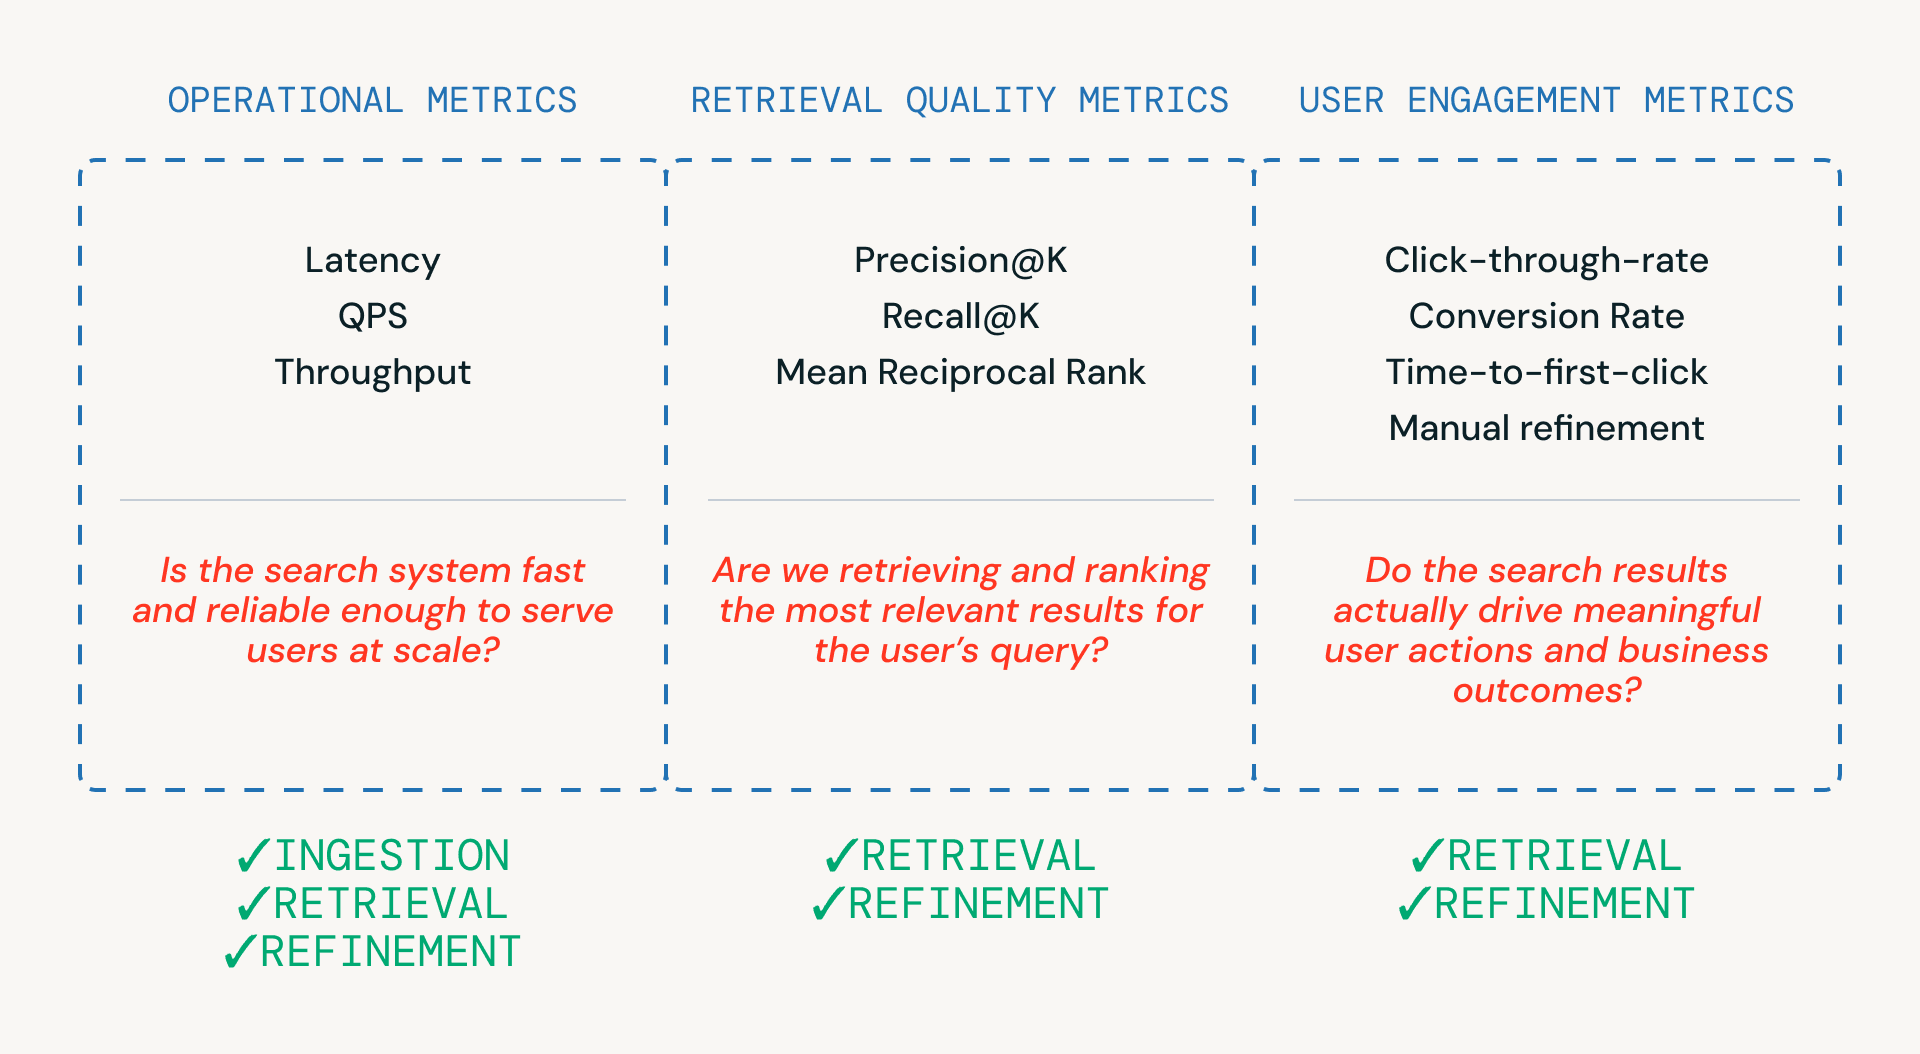
在Databricks上构建实时产品搜索

现代在线市场的汽车搜索系统需要快速和相关的结果。Databricks提供了一个端到端的平台,支持数据摄取、向量检索和实时操作数据。成功的搜索系统依赖于强大的基础设施和有效的指标,以实现快速、相关的结果,推动业务增长。

在Databricks上构建实时产品搜索

Databricks Databricks · 2026-04-14T10:17:11Z
提升工业物联网性能边界:硬件如何影响工业物联网工作负载

文章讨论了工业物联网(IIoT)数据库的性能瓶颈,重点在于存储、数据摄取速率和查询速度。增加硬件(如RAM和CPU)对数据摄取的影响有限,主要受I/O限制,但对查询速度有显著提升。建议使用专门的时间序列数据库,如TimescaleDB,以提高数据摄取性能。

提升工业物联网性能边界:硬件如何影响工业物联网工作负载

Timescale Blog Timescale Blog · 2026-04-06T12:16:09Z
【译】 数据摄取构建模块简介(预览版)(二)

本文介绍了数据摄取管道的处理过程,包括数据块的丰富、存储和检索。使用SummaryEnricher为数据块添加摘要,并通过SQLite存储处理后的数据。IngestionPipeline支持文件处理和部分成功的导入机制,并展示了如何配置分布式应用程序以实现数据摄取和可观测性。

【译】 数据摄取构建模块简介(预览版)(二)

dotNET跨平台 dotNET跨平台 · 2026-03-24T00:01:12Z
如何测量您的IIoT PostgreSQL表

文章讨论了如何测量IIoT PostgreSQL数据库表的大小和性能。通过特定的SQL查询,可以快速获取表的行数和存储大小。同时,介绍了评估数据摄取能力和查询速度的方法,强调了pg_stat_statements工具在监控数据库性能中的重要性。

如何测量您的IIoT PostgreSQL表

Timescale Blog Timescale Blog · 2026-03-12T18:50:42Z
构建Vertex AI搜索应用程序:全面指南

本文介绍了如何使用Vertex AI Search构建生产就绪的搜索应用程序,结合传统搜索与机器学习,提供语义理解和自然语言处理。开发者需掌握数据摄取、存储、搜索引擎配置及生成AI集成等关键组件,通过优化索引策略和查询构建提升搜索性能与相关性,同时关注安全性和监控。

构建Vertex AI搜索应用程序:全面指南

KDnuggets KDnuggets · 2026-02-13T15:00:18Z
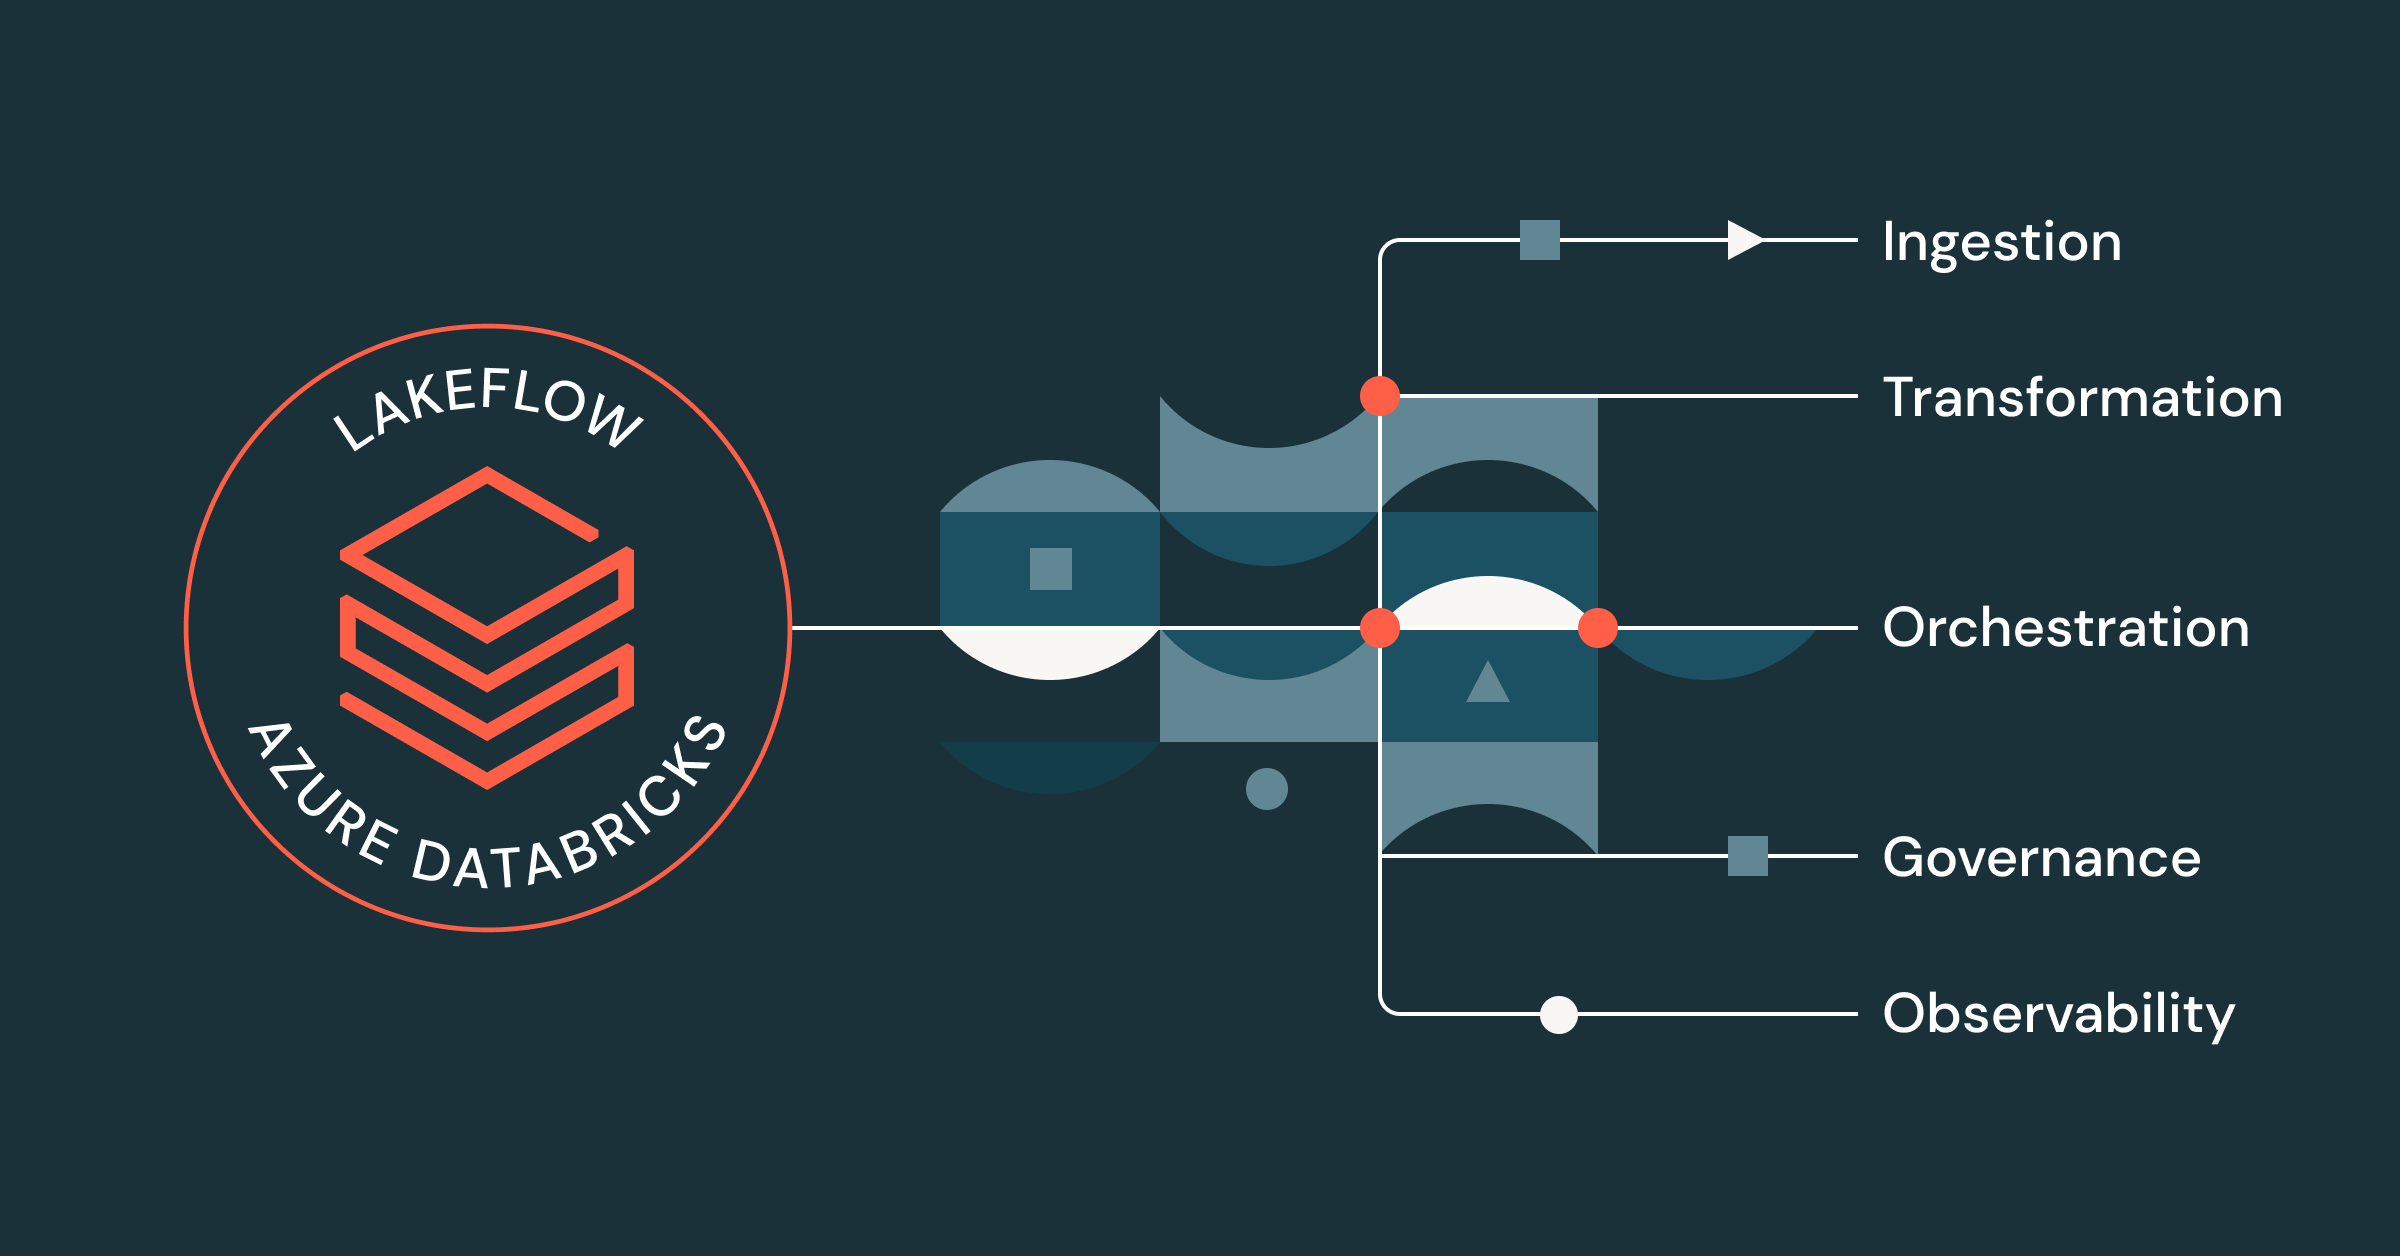
在Azure Databricks上使用Lakeflow现代化您的数据工程平台

数据工程师在构建生产就绪管道时面临挑战。Lakeflow在Azure Databricks上提供统一的数据工程解决方案,集成数据摄取、转换和编排,简化开发流程,提高数据质量和安全性,帮助团队更高效地工作。

在Azure Databricks上使用Lakeflow现代化您的数据工程平台

Databricks Databricks · 2026-02-10T19:54:19Z
Elastic Cloud Serverless 定价与包装

Elastic Cloud Serverless推出了灵活的定价和包装,专注于安全性、可观察性和Elasticsearch。定价依据数据摄取量和存储大小,支持按需消费,适合不同规模的客户,便于管理和预算。

Elastic Cloud Serverless 定价与包装

Elastic Blog - Elasticsearch, Kibana, and ELK Stack Elastic Blog - Elasticsearch, Kibana, and ELK Stack · 2025-11-01T00:00:00Z
宣布 Zerobus Ingest 的公开预览

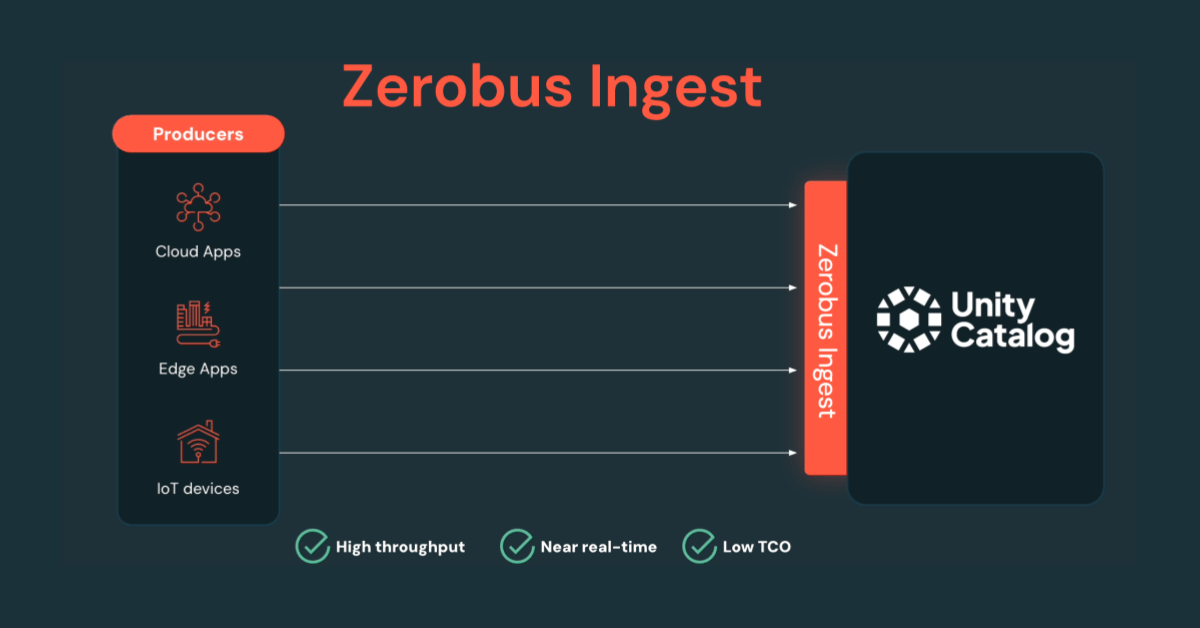
Zerobus Ingest 是一种新型数据摄取解决方案,能够将事件数据直接推送到湖仓,简化基础设施并降低运营成本。它支持实时分析和 AI 应用,延迟低至五秒,吞吐量可达每秒 100 MB,适用于多种行业,帮助企业实现高效的数据处理和实时决策。

宣布 Zerobus Ingest 的公开预览

Databricks Databricks · 2025-10-30T15:00:00Z
宣布Lakeflow Connect推出SQL Server连接器,现已正式上线

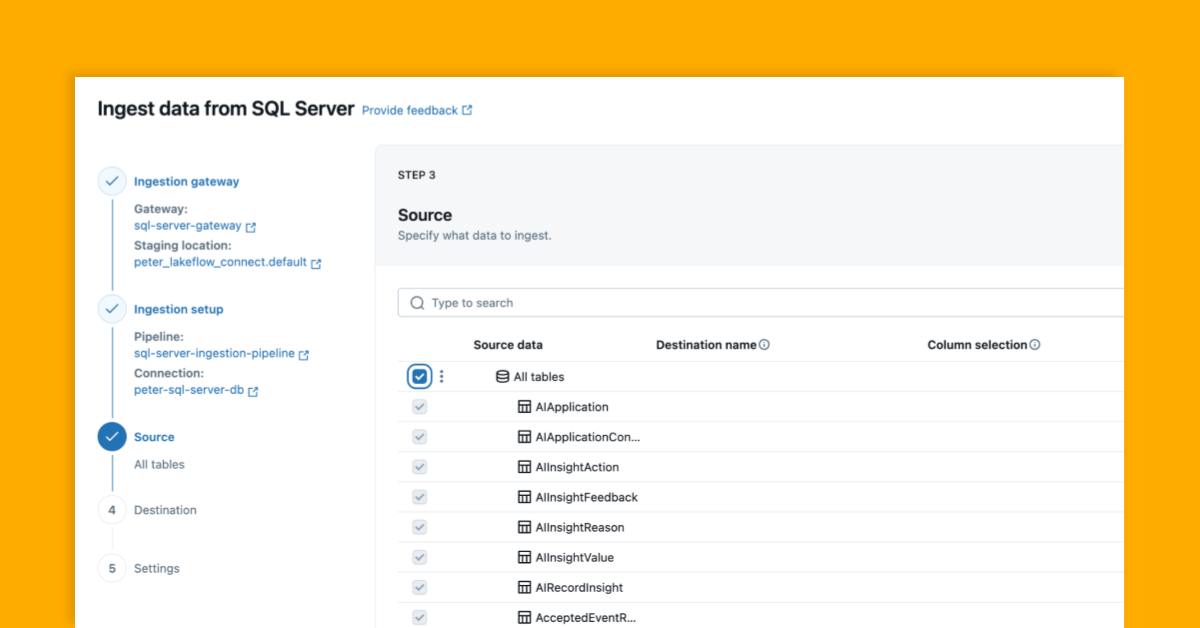
Lakeflow Connect推出SQL Server连接器,简化数据摄取,支持变更数据捕获(CDC)和变更跟踪(CT),提升数据新鲜度,降低运营成本,助力企业分析与决策。

宣布Lakeflow Connect推出SQL Server连接器,现已正式上线

Databricks Databricks · 2025-09-25T16:55:00Z
Karrot如何在AWS上构建特性平台,第二部分:特性摄取

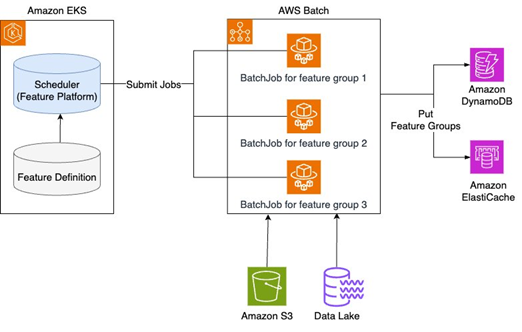
Karrot推出了一个新特性平台,支持流和批量数据摄取。流摄取实时收集数据并生成特征,批量摄取处理大量数据。通过AWS服务,Karrot提升了推荐系统的可靠性和可扩展性,显著提高了点击率和转化率。

Karrot如何在AWS上构建特性平台,第二部分:特性摄取

AWS Architecture Blog AWS Architecture Blog · 2025-08-14T15:16:27Z
构建Jetflow:Cloudflare灵活高效的数据管道框架

Cloudflare的商业智能团队开发了Jetflow框架,处理每天1410亿行数据,显著提升数据摄取效率,支持多种数据库和SaaS应用,满足高性能、可扩展和易用性需求。

构建Jetflow:Cloudflare灵活高效的数据管道框架

The Cloudflare Blog The Cloudflare Blog · 2025-07-23T14:00:00Z
如何通过自定义日志和数据摄取管道基准测试Elasticsearch性能

本文介绍了如何通过自定义日志跟踪基准测试Elasticsearch性能,特别是在数据摄取管道中。用户可以重建数据集、创建摄取管道和索引模板,以测试集群在不同负载下的表现。强调在非生产环境中进行测试的重要性,并提供具体命令和步骤以确保测试的有效性和准确性。

如何通过自定义日志和数据摄取管道基准测试Elasticsearch性能

Elastic Blog - Elasticsearch, Kibana, and ELK Stack Elastic Blog - Elasticsearch, Kibana, and ELK Stack · 2025-05-09T00:00:00Z
数据工程概念介绍 |2| 理解数据源与数据摄取

数据摄取是将外部数据引入内部系统的关键步骤,常见数据源包括关系数据库、API和平面文件。摄取策略分为批处理和流处理,前者适合不需实时更新的场景,后者适用于低延迟需求。数据可分为结构化、半结构化和非结构化,设计摄取管道时需考虑延迟、可扩展性、错误处理和模式演变等因素。

数据工程概念介绍 |2| 理解数据源与数据摄取

DEV Community DEV Community · 2025-05-02T16:42:06Z
Cloudflare AutoRAG 简化了检索增强生成

Cloudflare推出AutoRAG服务,简化了基于LLM的检索增强生成(RAG)系统的构建,自动处理数据摄取、向量化和查询,支持多种文件格式。尽管流程简化,但仍存在嵌入选项少和查询重写慢等限制。

Cloudflare AutoRAG 简化了检索增强生成

InfoQ InfoQ · 2025-04-30T18:00:00Z
使用Python和人工智能进行数据加载

现代数据管道是数据工程的基础,帮助组织高效处理信息。构建和维护这些管道面临API限制和数据模式变化等挑战。掌握数据摄取对构建可扩展系统至关重要。freeCodeCamp.org的课程将教授使用Python进行数据摄取,涵盖数据流、批处理和动态模式管理,适合数据工程师和开发者。

使用Python和人工智能进行数据加载

freeCodeCamp.org freeCodeCamp.org · 2025-04-17T20:56:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码