小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
使用 OpenTelemetry Collector 过滤并精简 AI 智能体遥测数据

文章介绍如何用 OpenTelemetry Collector 优化 Claude Code 的遥测数据。默认遥测包含大量提示词、文件内容和工具参数,存储成本高且难以分析。作者将数据分流为原始与优化两条管道进行对比:日志删除冗余字段并哈希 ID,指标删除高基数属性并合并会话,追踪删除成功工具事件、截断内容而不采样。结果日志和追踪体积约减半,指标基数从 300 降至 12,且关键问题仍可回答。

使用 OpenTelemetry Collector 过滤并精简 AI 智能体遥测数据

Cloud Native Computing Foundation Cloud Native Computing Foundation · 2026-10-22T11:00:00Z
设计能在上行链路中断时存活的工业物联网数据摄入系统

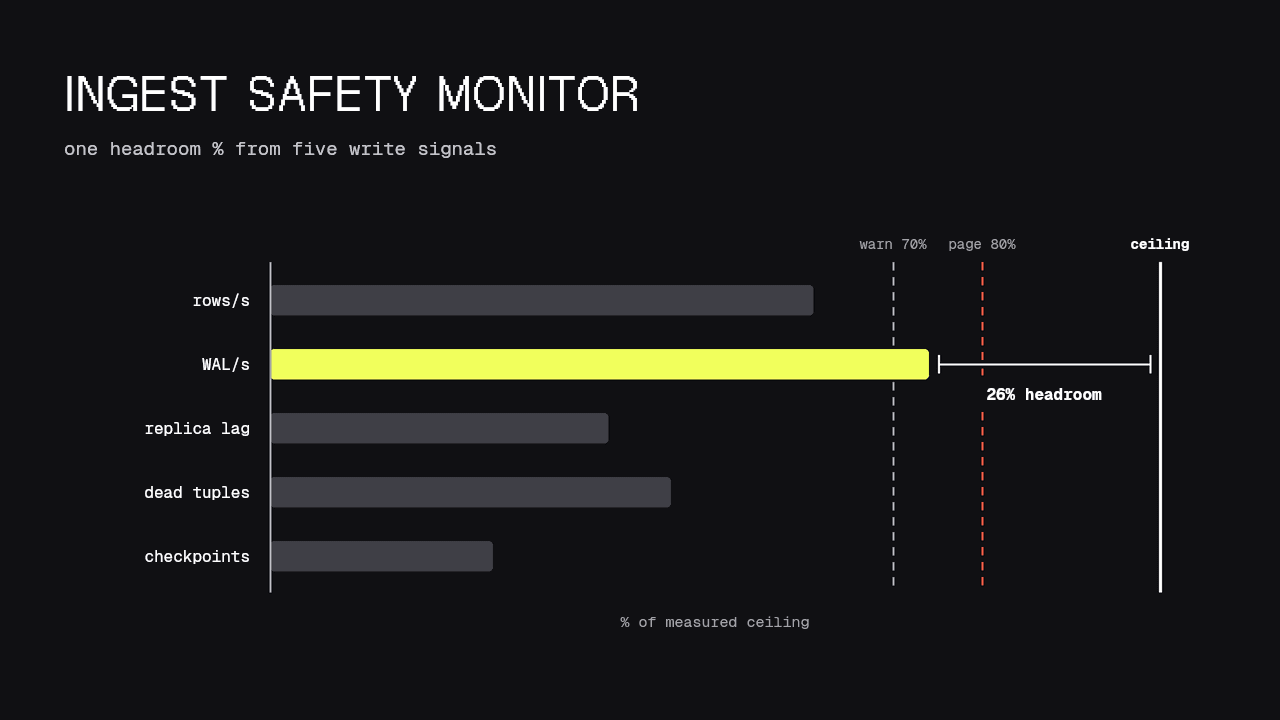
该文介绍为工业物联网数据管道构建“摄入安全监控器”:摄入故障是突发而非渐进的,建议每分钟采样WAL量、副本延迟和死元组,得出可告警的余量百分比。

设计能在上行链路中断时存活的工业物联网数据摄入系统

Timescale Blog Timescale Blog · 2026-10-21T12:08:45Z
薄编排器:如何通过减少路由器的职责让我们的AI代理更可靠

Meta的数据管道AI代理最初采用单一全能代理,但在生产环境中因上下文过载而频繁产生幻觉。团队随后改为“薄编排器”架构:由1300行确定性路由器负责意图分类、字段收集、可靠性检查与任务分派,不进行任何领域推理;14个上下文隔离的专业子代理各司其职。系统通过工作流模板复用子代理,并按需加载知识文件。改造后,新列配置时间从三四天缩短至一小时以内,约三分之二的变更无需人工大幅修改。

薄编排器:如何通过减少路由器的职责让我们的AI代理更可靠

Engineering at Meta Engineering at Meta · 2026-10-19T15:30:37Z
新功能:通过Stripe数据管道将实时Stripe数据同步至Postgres

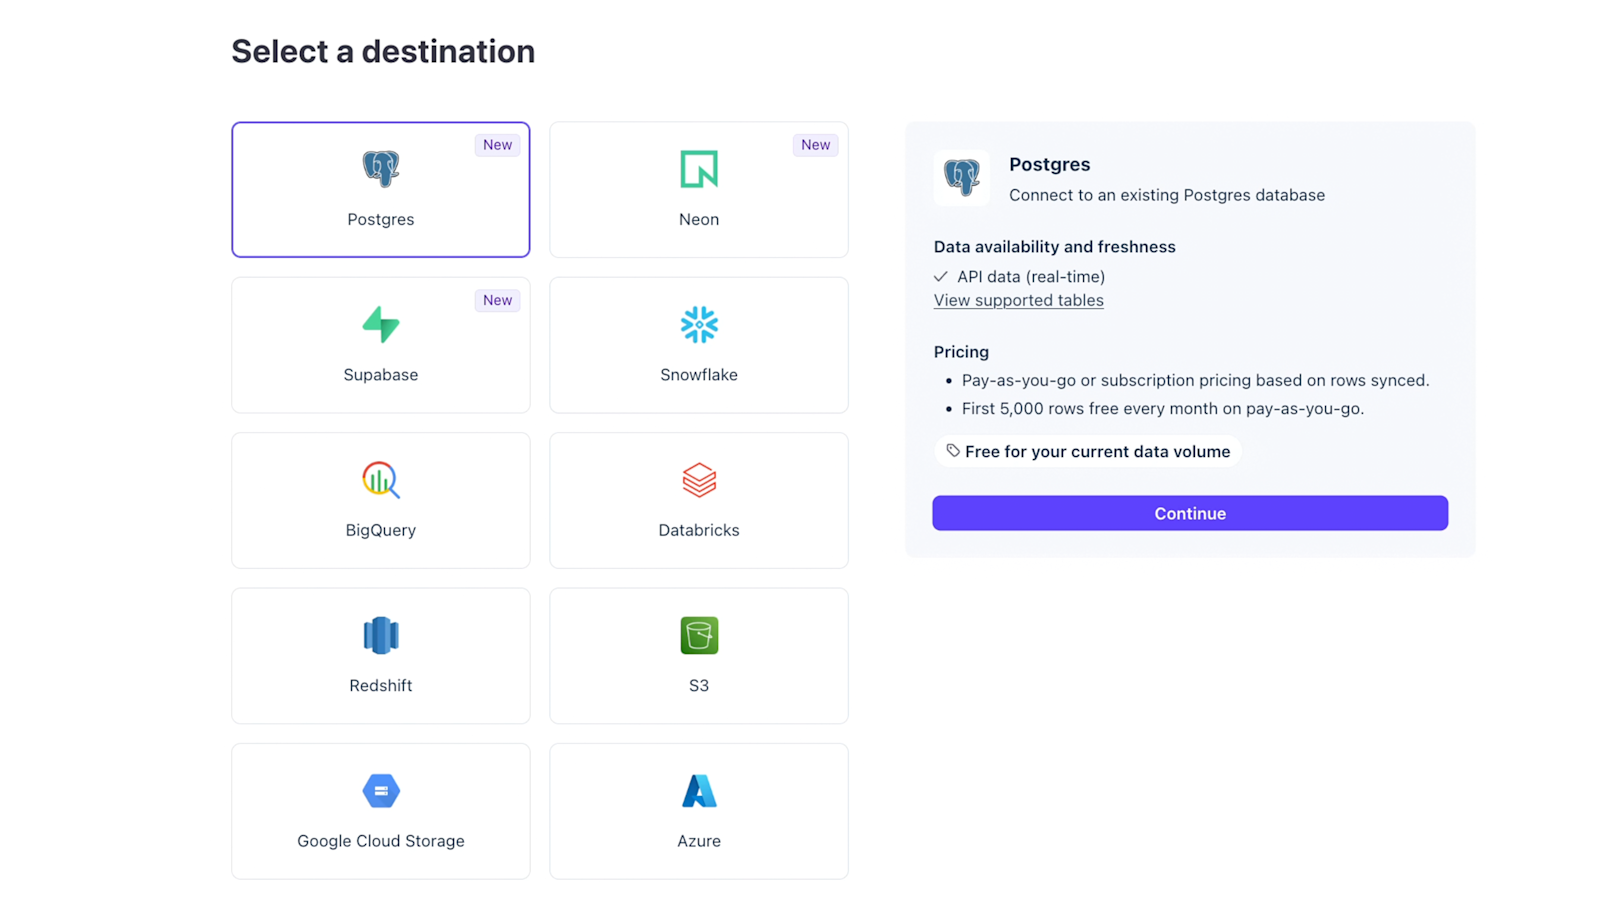
Stripe推出数据管道实时同步功能,可将支付、客户、订阅等数据直接同步至Postgres数据库,无需编写代码。系统自动回填并持续更新数据,定期校验一致性,省去开发者自建API和Webhook的维护工作。该功能已公开预览,免费使用,未来将支持更多数据平台。

新功能:通过Stripe数据管道将实时Stripe数据同步至Postgres

Stripe Blog Stripe Blog · 2026-10-15T00:00:00Z
AI Runtime上的快速、容错PyTorch训练

在大规模AI训练中,GPU利用率取决于“好吞吐”,即有效计算时间占比。数据加载和检查点机制是关键:频繁异步保存检查点(如每30分钟)可减少故障恢复成本,提升好吞吐至91%;数据管道需重叠预取和本地缓存,避免GPU空闲。同时,检查点需包含数据位置和随机数状态,确保恢复后训练正确。

AI Runtime上的快速、容错PyTorch训练

Databricks Databricks · 2026-08-28T01:15:00Z
为什么大规模实时AI如此困难

实时AI扩展面临延迟、准确率下降等问题,根源多在数据管道而非模型。尾延迟源于架构,如锁竞争;特征陈旧导致准确率下降;向量索引退化影响召回率。需分离读写路径、训练与服务,监控指标,并采用支持高并发写入和弹性扩展的数据库,避免“厄运循环”。

为什么大规模实时AI如此困难

The New Stack The New Stack · 2026-08-23T16:00:00Z
Prefect刚刚收购了Dagster,这又是一个大型的Airflow竞争对手——这并不是一个数据管道的故事

Prefect宣布收购Dagster,旨在整合两个主要的开源数据管道工具,以提升AI代理工作流的可靠性与规模。收购后,双方将继续保持各自品牌与产品路线,预计将推动数据生态系统的发展。

Prefect刚刚收购了Dagster,这又是一个大型的Airflow竞争对手——这并不是一个数据管道的故事

The New Stack The New Stack · 2026-07-13T22:08:55Z
“沉默幻觉”循环:我们的自主数据管道如何毒化了自己的向量存储

文章讨论了在构建可靠AI系统时,处理金融报告PDF所面临的问题。由于自动化数据提取错误,导致信息不准确。为了解决这一问题,团队重新设计了数据管道,采用确定性检查,以确保数据的准确性和完整性,从而提高系统的可靠性并降低成本。

“沉默幻觉”循环:我们的自主数据管道如何毒化了自己的向量存储

The New Stack The New Stack · 2026-07-09T13:00:00Z

该招聘信息要求候选人熟悉Rust和精通Python,具备编译原理和数据仓库的理解。职位涉及交易链路工具开发,包括数据管道、消息总线扩展、风险控制工具和执行算法。薪资范围为每月5000至10000美元,提供项目奖金,工作地点在香港或远程。

寻找执行系统开发工程师,专注于交易基础设施/执行系统

Rust.cc Rust.cc · 2026-07-04T08:18:14Z
大金应用美洲公司如何利用Genie Code构建一致性的数据管道

大金应用美洲公司通过结构化操作模型和AI辅助的Genie Code,加速了数据管道的开发。团队采用MECE技能框架,确保管道设计的一致性,减少开发时间,提高输出的可维护性。通过对齐业务概念与技术模型,团队在数据工程中实现了更高的效率和治理,确保AI在生产工作流中的可靠性。

大金应用美洲公司如何利用Genie Code构建一致性的数据管道

Databricks Databricks · 2026-06-24T18:00:00Z
现代数据工程的DataOps策略

DataOps将DevOps原则应用于数据管道,以加速交付和提高数据质量。通过自动化数据工作流和促进跨职能团队协作,DataOps持续改进数据质量,强调将数据视为产品,推动快速迭代和反馈,显著降低数据停机时间和运营成本。实施DataOps的组织报告数据停机事件减少高达99%。

现代数据工程的DataOps策略

Databricks Databricks · 2026-06-22T19:38:25Z
数据管道最佳实践:架构、现代管道与部署

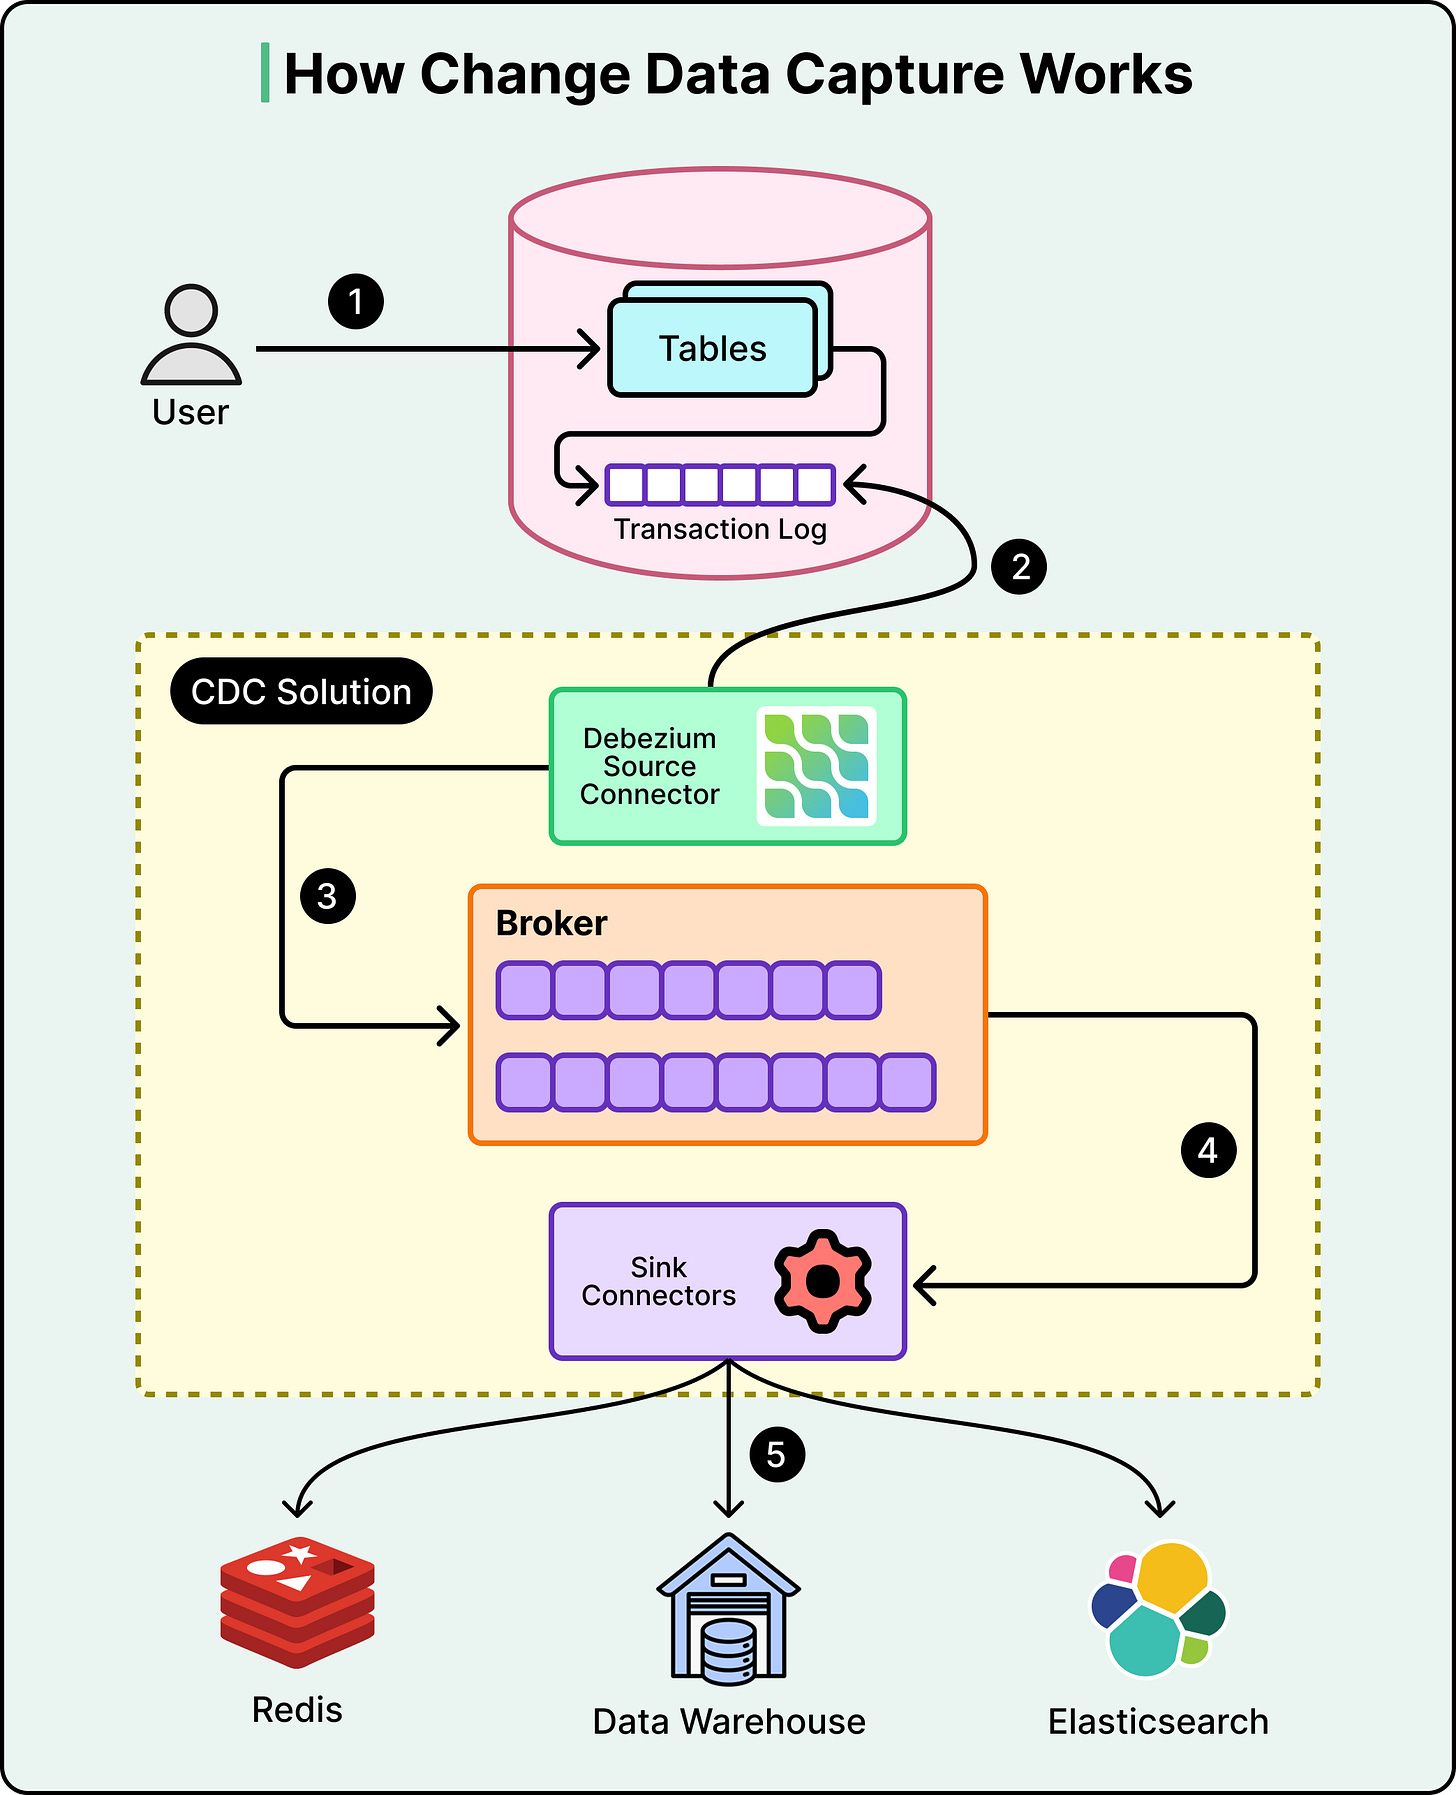
数据管道是自动化系统,用于将原始数据从源系统转移、转换为可用格式并交付给目标系统。有效的数据管道架构包括数据摄取、处理、存储和监控。选择批处理或流处理模式是关键决策,现代架构应以业务需求为基础,确保数据质量和治理。采用增量加载、自动化CI/CD和全面可观察性是提高管道可靠性的最佳实践。

数据管道最佳实践:架构、现代管道与部署

Databricks Databricks · 2026-06-18T16:14:42Z
什么是数据管道架构?

数据管道架构是设计数据从源系统到应用和模型的过程,包括数据的收集、处理、存储和交付。架构分为逻辑设计和物理设计,定义数据流动的步骤和工具。数据管道可分为批处理和流处理,适用于不同用例。现代平台如Databricks通过Lakeflow统一这两种处理方式,简化架构,提高数据的可靠性和可用性。

什么是数据管道架构?

Databricks Databricks · 2026-06-16T21:23:03Z
如何为机器学习预处理医疗影像——以胸部X光为例的指南

本文讨论了胸部X光影像数据集的预处理重要性,介绍了六个核心步骤:数据验证、缩放、归一化、关注区域引导、处理缺失数据和去噪。强调不当预处理可能导致模型性能下降,并提供了完整的预处理管道示例,以帮助读者有效准备医疗影像数据进行机器学习。

如何为机器学习预处理医疗影像——以胸部X光为例的指南

freeCodeCamp.org freeCodeCamp.org · 2026-06-04T17:13:59Z
Slack AI:通往多云的道路

文章讨论了Slack在数据管道现代化方面的安全驱动转型,包括从SSH到REST的迁移,以及在网络探测和HTTP/3准备方面的可扩展性提升。

Slack AI:通往多云的道路

Slack Engineering Slack Engineering · 2026-05-28T14:15:20Z
基于 Amazon IoT Core 与 Kiro 构建可迁移的工业 IoT 数据管道

本文介绍了如何将工业 IoT 数据管道从一个亚马逊云账户迁移到另一个账户,使用幂等的 boto3 脚本和 Kiro AI Agent 进行自动化部署。迁移过程中面临证书复用、IP 白名单和 S3 Bucket 名称唯一性等挑战。通过将手动步骤转化为 AI 可调用的工作流,提高了迁移效率和可观测性,最终实现了安全、可回滚的迁移方案,为未来的多账户治理提供了参考。

基于 Amazon IoT Core 与 Kiro 构建可迁移的工业 IoT 数据管道

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-05-26T06:21:25Z
为MHHS扩展:Octopus Energy如何在边际数据工程中实现50倍的成本降低

Octopus Energy通过重新架构数据管道,成功应对数据量增加48倍的挑战,降低了50倍的成本。新系统优化了数据处理流程,符合市场半小时结算(MHHS)要求,提升了结算和定价效率,同时增强了能源使用的智能化和可持续性。

为MHHS扩展:Octopus Energy如何在边际数据工程中实现50倍的成本降低

Databricks Databricks · 2026-05-23T00:40:09Z

文章讨论了数据管道中Schema变更的四种形状及其对应的存储格式,包括CSV、Parquet、Delta Lake和Iceberg。不同格式在处理Schema变更时的能力差异显著,Iceberg支持自动处理列的增删和重命名,而CSV则完全依赖手动处理。选择合适的格式取决于Schema变更的频率和自动化需求。

读:数据管道中Schema变更的四种形状

暗无天日 暗无天日 · 2026-05-16T00:00:00Z
Figma如何将数据管道从多天延迟升级为实时

Figma通过改进数据管道,实现了数据同步从多天延迟到实时,采用增量同步技术,仅传输变化的数据,显著提高了数据新鲜度和处理效率。新系统节省了数百万美元,支持更大数据量,并实现了自动化验证,确保数据准确性。

Figma如何将数据管道从多天延迟升级为实时

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-05-12T15:31:03Z
重新思考现代数据平台的SQL ETL

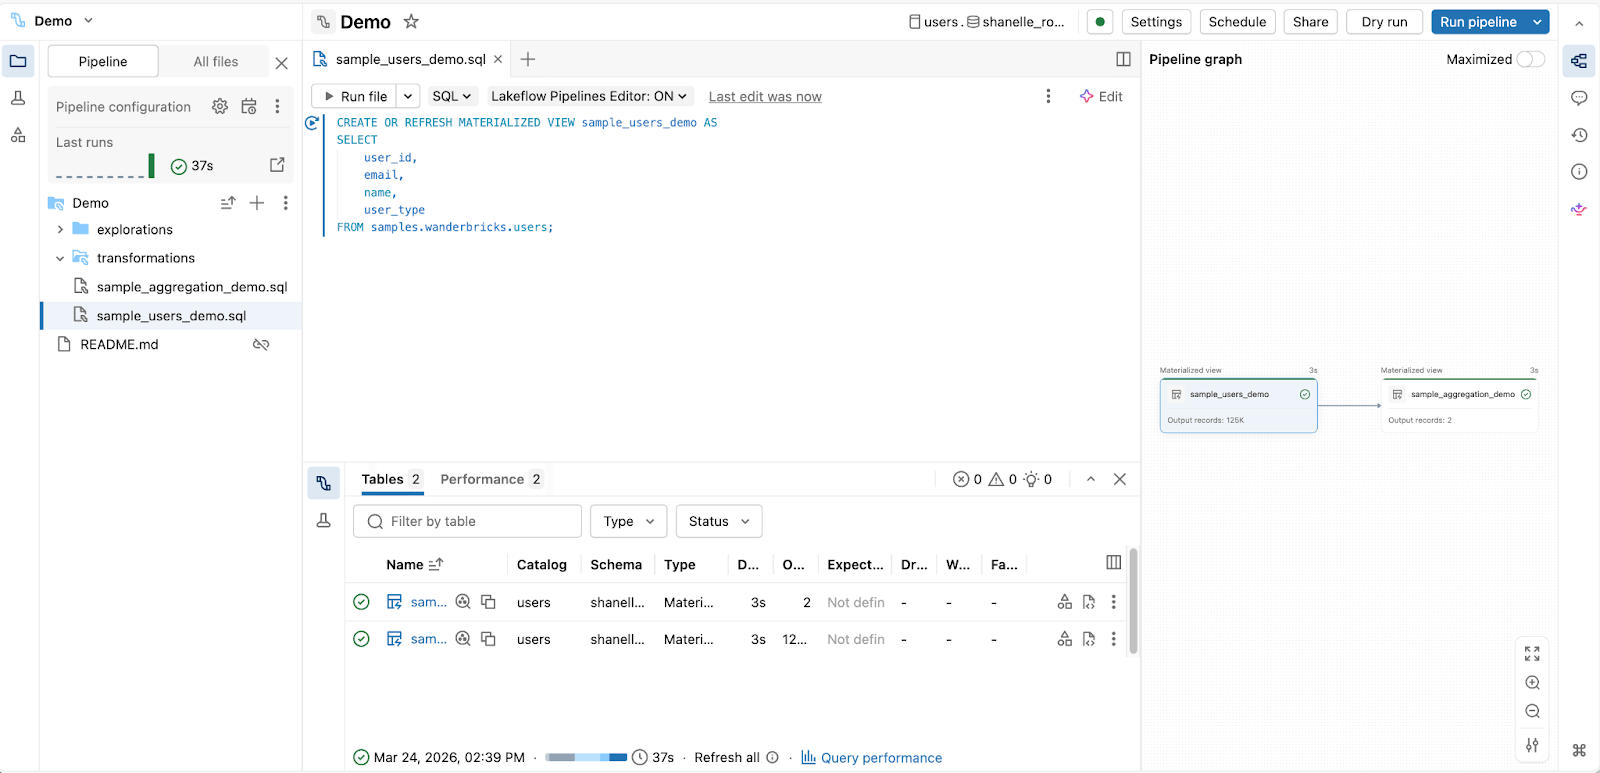
SQL ETL实施面临碎片化挑战,导致操作复杂且难以扩展。Databricks通过统一平台整合执行、调度和监控,简化数据管道管理,提升性能和可靠性,支持多种工作流,确保团队高效协作,适应未来需求。

重新思考现代数据平台的SQL ETL

Databricks Databricks · 2026-04-29T16:45:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码