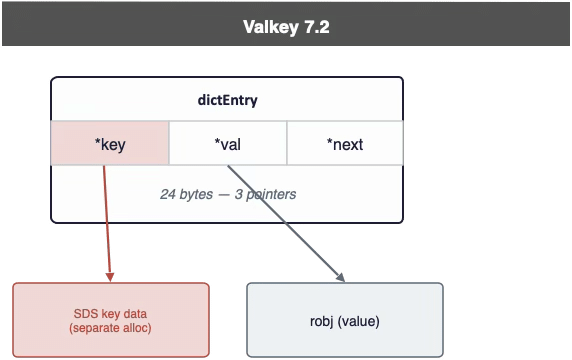
Valkey 7.2至9.1通过三项底层数据结构重构,将字符串密集型场景的每键内存从102.48字节降至64.02字节,减少37.5%。8.0将键内联进dictEntry节省8字节;8.1改用64字节缓存行对齐哈希表,嵌入键值并消除dictEntry,节省20-30字节;9.1将短字符串内联存储,节省最多20%。此外,用Hash存储同一数据比多个String键节省54%内存,但需权衡TTL与集群灵活性。
Redis 8.10 开源版发布,重点提升内存效率、扩展数据结构能力并简化运维。新增紧凑哈希模板,内存降低达 50%,HIMPORT 批量导入吞吐提升 2 倍;扩展 JSONPath 语法;Streams 支持 MAXCOUNT/MAXSIZE 限制;新增 Set 并集差集基数命令、批量 List 原子移动、按时间戳对齐的 TS.NRANGE 查询及阻塞式 TS.READ;引入增量备份与恢复,降低大规模集群备份资源开销。
布隆过滤器是一种概率数据结构,通过位数组和多个哈希函数快速判断元素是否可能存在于集合中。它能确定元素不存在,但可能误报存在。Instagram等系统利用它减少数据库查询,以少量误报率换取高效和内存节省。
Cloudflare优化DNS缓存,通过五项措施使每个条目内存占用减少56%,节省约100TB内存。这些措施包括替换数据结构、合并存储列表、省略冗余字段、使用Box减少枚举浪费及原始字节存储,从而提升性能并降低内存使用。
本文是Go语言基础教程,涵盖指针与引用、结构体与方法、切片与映射三大主题。指针允许函数修改原变量,结构体通过接收器实现方法,切片和映射是常用数据结构。文章通过代码示例讲解值传递与指针传递的区别、接收器类型选择、切片容量管理及映射的逗号-ok模式,帮助读者掌握Go的核心编程概念。
freeCodeCamp发布新课程,由Sumit Saha主讲,通过日常类比教授数据结构与算法基础,涵盖数组、链表、栈、队列、哈希表、树、图等结构,以及搜索排序算法和递归、动态规划等范式,帮助学习者建立直观理解,便于用任何语言实现。
freeCodeCamp发布了一门由Sumit Saha主讲的新课程,通过日常类比教授数据结构与算法基础,涵盖数组、链表、栈、队列、哈希表、树、图等结构,以及搜索、排序、递归和动态规划等算法范式,帮助学习者直观理解并实现。
FreeBSD通过libc符号版本、系统调用兼容层及ioctl结构体处理维持ABI稳定。旧程序依赖旧接口,内核保留freebsd11_*等兼容代码转换数据结构;新用户态对旧内核则逐接口回退,如getentropy()。兼容代码随时间累积,但终会因使命完成而删除,体现ABI稳定的工程代价。
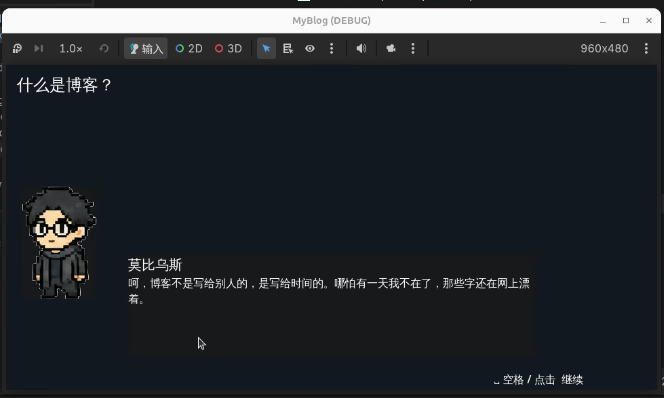
文章探讨了游戏对话系统的设计与实现,从功能需求出发,规划了包含人物、对白、分支和跳转的数据结构,并借助AI辅助编码搭建场景。作者强调对白内容设计难度大,因此从博客圈取材,并使用AI生成角色形象,以提高开发效率。目前原型已完成,正进入打磨阶段。
本文比较了Memcached与Redis,指出Memcached适合纯缓存场景,而Redis提供丰富的数据结构和持久化选项。Memcached采用多线程和slab分配,适合高吞吐量需求;Redis通过单线程和多态编码实现灵活性。文章强调在不同应用场景下选择合适的缓存工具,尤其在大规模Web服务中,Memcached更轻便。
CRDT(无冲突复制数据类型)是一种特殊的数据结构,允许各节点独立写入并最终合并,以确保一致性。其核心思想是通过满足交换律、结合律和幂等律来保证合并结果的一致性。CRDT包括G-Counter(只增计数器)、PN-Counter(可增减计数器)和LWW-Register(最后写入者胜出寄存器)。尽管CRDT在协同编辑和分布式系统中应用广泛,但其元数据开销和最终一致性限制需谨慎考虑。
本文介绍了七个提高 Python 字典代码清晰度的技巧:使用 .get() 方法避免 KeyError,利用 defaultdict 简化数据分组,使用 | 操作符合并字典,使用 ** 解包字典作为函数参数,运用海象运算符简化赋值,TypedDict 明确数据结构,以及使用 .items()、.keys() 和 .values() 进行迭代。这些技巧能使代码更 Pythonic,减少重复。
本文探讨了MySQL InnoDB的崩溃恢复机制,分析了核心数据结构、关键算法及其与日志系统的关系。崩溃恢复对DML延迟和并发语义有影响,理解相关数据结构和状态机至关重要。建议通过源码和实验进行深入理解,特别是与PostgreSQL的对比学习。
BPF程序在内核中执行时无法访问全局变量和调用内核函数,唯一的持久化机制是BPF map。本文分析了BPF map的内核实现,包括hash表和数组的结构、并发模型及适用场景。hash map使用分桶链表和预分配策略,而array map则采用连续内存布局,支持零拷贝。per-CPU变体允许每个CPU独立操作,避免缓存行竞争。理解这些并发模型对优化BPF程序性能至关重要。
在《V5的诞生》第16集,开发者探讨了数据结构的简化与优化,发现“卡片”是数据切片,而切片是闭包。通过两个Claude的协作,逐步修正设计,使系统更小更高效。最终,解决问题的关键在于停止制造复杂性,保持会话的持续性,避免不必要的状态转移。
文章讨论了v5的诞生过程,描述了旧服务器的迁移与更新。团队通过483次提交逐步改进系统,保持了连续性。对比旧版与新版,揭示了数据结构的变化和命名的困惑,强调在演变中保持忠诚的重要性。最终,团队意识到虽然仍称其为v4,但实际上已经是v5,反映了持续的成长与变化。
Redis 8.8版本引入了新特性和性能改进,包括通用数据结构数组、窗口计数器速率限制器、消息NACK支持和哈希字段的子键通知。数组提供快速索引访问,适合动态和稀疏数据,简化了多聚合器操作,提升数据处理效率。用户可控制浮点数组的存储格式,以优化内存和精度。
文章讨论了主动复制中的冲突问题及其解决方案,介绍了冲突自由复制数据类型(CRDTs)的优势。CRDTs允许在不同节点独立更新数据,并在没有协调的情况下自动合并,避免数据丢失和复杂的冲突解决。数据结构定义了合并规则,简化了开发者的工作,适用于实时应用,提升了写入延迟和可用性。
企业在引入AI工具提升安全运营中心(SOC)时,面临数据孤岛和复杂环境的问题。有效的AI依赖于统一的数据结构,Elastic公司强调数据整合的重要性,以确保AI能够准确分析和监控安全状况。通过建立坚实基础和明确流程,企业可以更好地利用AI,提升网络安全防护能力。
Merkle树是一种重要的数据结构,广泛应用于分布式系统,如Git、区块链和HTTPS。它通过将数据块的哈希值组织成树形结构,仅需对根节点签名即可验证所有数据块的完整性。Merkle树的验证过程高效,仅需O(log n)的哈希值,且任何数据块的修改都会改变根哈希。本文探讨了Merkle树的构造、验证及其在以太坊的Merkle Patricia Trie和未来Verkle树中的应用。
完成下面两步后,将自动完成登录并继续当前操作。