企业看好合成数据在隐私保护和加速开发方面的价值,但采用率低,主要原因是数据质量不足:仅38%认为其足够真实,34%认为能保持引用完整性。开发测试团队更关注数据可用性。高质量合成数据需保留真实关系与业务语境,才能支持AI时代的软件交付。
谷歌Demand Gen广告系列效果依赖数据质量。使用Google Tag Gateway的广告主转化率平均提升超20%。谷歌广告将推出数据强度提升指标,Data Manager扩展至DV360和GA,增强型转化也将登陆这两个平台。保险平台The Zebra借此实现转化量增16%、转化价值增19%。
宽带论坛报告指出,宽带网络实现AI自主运行仍面临设备兼容性差、数据不一致等障碍。94%服务商计划采用SDN,92%认为AI/ML集成关键,但83%称数据质量差是主要障碍。主要用例为预测性维护、异常检测和客户体验优化。78%认为供应商互操作性差,90%称与现有系统集成是挑战。
临床AI的成败关键在于数据而非模型。医院数据多源、异构、时序不规则且术语持续更新,标准ETL流程难以应对。数据质量比架构更重要,需采用FHIR等标准、合规去标识化,并确保训练数据代表目标人群。工程师应尽早与临床医生协作,避免时间泄漏,重视缺失数据的含义。多模态数据需分别预处理。系统应持续监控漂移、保留数据溯源并设计人工监督,将数据视为核心工程问题。
机器人训练失败常源于数据质量而非模型规模。以LeRobot与LanceDB集成为例,数据版本化可让训练、搜索、质检指向同一份可复现数据。核心检查包括动作时延、异常抖动、切分泄漏等,并强调按地点、人员或批次分组切分,建立数据契约与人工复核门禁,避免标签错误和时序错位。
企业投资AI时,隐私控制常导致生产级数据难获取、关系断裂、质量下降。报告显示,26%组织难获高质量数据,25%难保持实体关系,51%面临数据质量挑战。隐私保护不能牺牲数据可用性,需在合规、质量与速度间平衡,通过企业级脱敏、数据虚拟化和合成数据等手段,确保受保护数据仍具真实性和参考完整性,支撑AI训练、测试与分析。可信数据是AI时代的终极竞争优势。
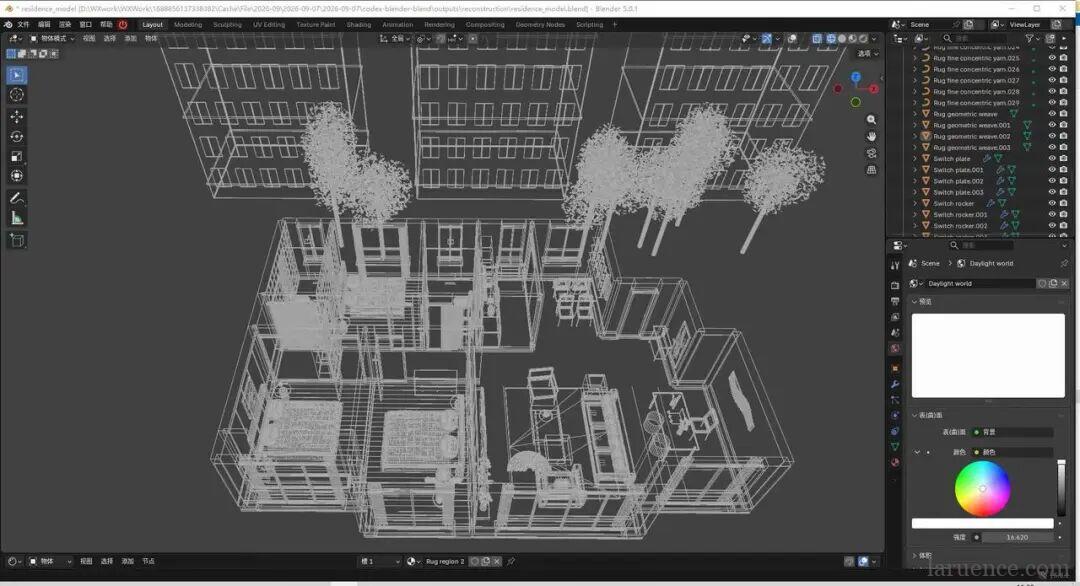
作者使用如视伽罗华P4扫描住宅,将全景图、点云、深度图等数据输入GPT-6 Astra进行三维重建。仅提供照片时,重建结果依赖猜测,结构混乱;补充点云和深度等确定性数据后,布局、材质、朝向基本还原,物体可拆分。结论:AI建模的瓶颈在于数据本身,高质量真实采集数据决定重建精度。
蚂蚁灵波CEO朱兴指出,具身智能落地面临机器人大脑冷启动、能力与成本双重限制,连小卖部场景都难落地。灵波专注通用基模,适配不同构型,通过后训练降低门槛。他强调数据质量与分布比数量更重要,需分阶段配比数据,异常数据是飞轮关键。人形非必需,构型应服务场景。商业化需克制,期待明年机器人数量和训练成本出现指数级变化。
2026外滩大会上,四位具身智能从业者围绕数据、智能与商业化展开讨论。数据方面,仿真与真机应分层组合,数据质量比规模更重要。智能方面,大模型难以直接降维打击具身模型,物理接触任务仍是短板。商业化方面,客户持续付费比Demo更重要,需综合模型、硬件、系统与成本。
数据转换是将原始数据清洗、过滤、聚合、连接和标准化为可用数据集的过程,对提升数据质量、支持决策和ETL流程至关重要。它涉及去重、精炼、集成等技术,可通过批处理或流式处理执行,工具选择包括云端、开源或低代码等。Databricks提供Spark声明式管道和Lakeflow Jobs等工具,简化ETL开发,确保数据质量,并支持实时或批量处理,助力企业高效利用数据。
数据治理工具用于编目、保护、监控和审计数据资产,确保数据准确、可发现且合规。核心功能包括数据目录、血缘追踪、访问控制、质量监控和合规报告。工具分为独立目录、点解决方案、企业套件、平台原生和开源五类。评估需考虑可扩展性、集成、易用性、策略粒度、AI治理就绪度、总拥有成本和供应商支持。选择应基于实际需求,通过审计、定义需求、概念验证等步骤,避免忽视AI治理和真实数据测试。
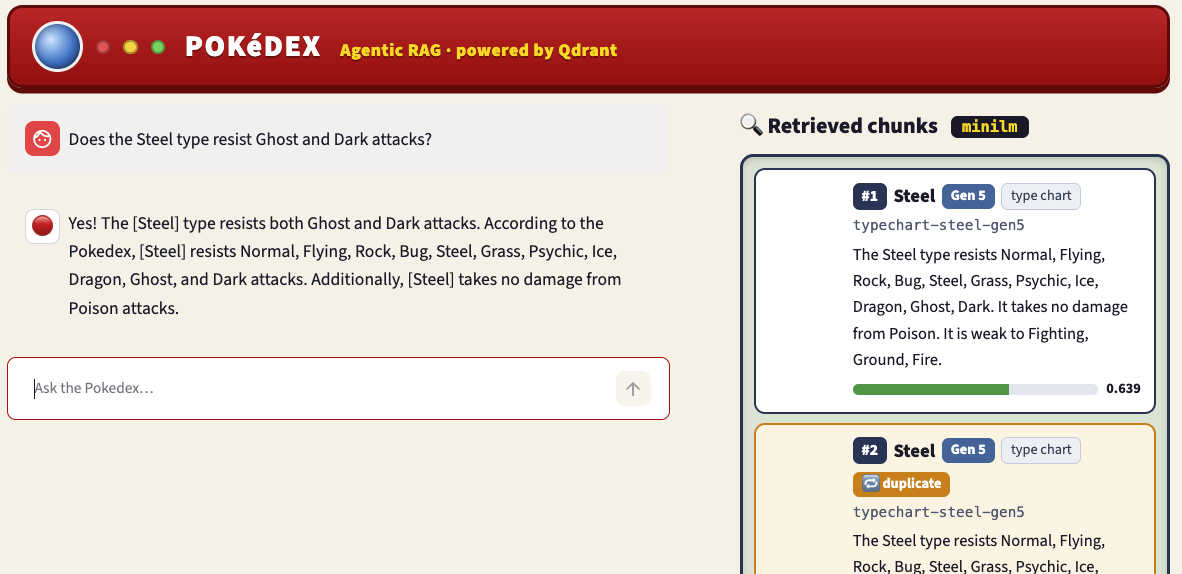
Qdrant向量集合增长会暴露重复、过期数据等问题,导致检索结果质量下降。通过去重、混合搜索优化和添加时效性过滤,可提升答案正确率。评估需结合多个指标,并检查数据源完整性,避免单一指标掩盖问题。
本文系统介绍纯文本LLM监督微调(SFT)训练数据预处理全流程,涵盖数据收集、格式统一、清洗过滤、去重、分布评估、混合策略及打包管理。强调数据质量优于数量,提供多任务采样、语种比例、难度分布等实操建议,并结合客户案例说明,旨在提升模型微调效果。
本文强调,非数据科学家也能从数据科学和AI中受益,关键在于以决策为起点,而非技术。应先理解数据质量,选择简单有效的模型,严格验证,并将分析转化为行动。大型语言模型应视为助手,需保持人类判断。最终,AI应被审慎用于真正改善决策之处,而非盲目跟风。
在RSS 2026机器人顶会上,讨论聚焦于VLA与世界模型的关系,认为两者不冲突,可结合。数据质量比数量更重要,硬件出海领先,但整体领域尚未成熟。全身智能成为新方向,强调系统分层与模块化。中国硬件优势明显,但需避免简单对标美国。
AI在医疗领域通过医学影像分析、临床文档、药物研发等提升诊疗效率,但需人类监督。AI可预测患者结果,准确率约70-72%,受数据质量影响。欧盟AI法案将多数临床AI列为高风险,要求严格治理和人工审查。AI不替代医生,需遵守HIPAA等隐私法规,并持续监控性能以减少偏见。
西门子中国董事长肖松强调,工业AI落地需以具体场景为核心,解决数据质量与模型训练衔接难题。应优先选择高价值场景,如质量检测和铜冶炼,通过软硬融合系统实现全链路闭环,并坚持开放式创新与生态协同。工业AI需长期投入,从单点实效走向生产力跃迁。
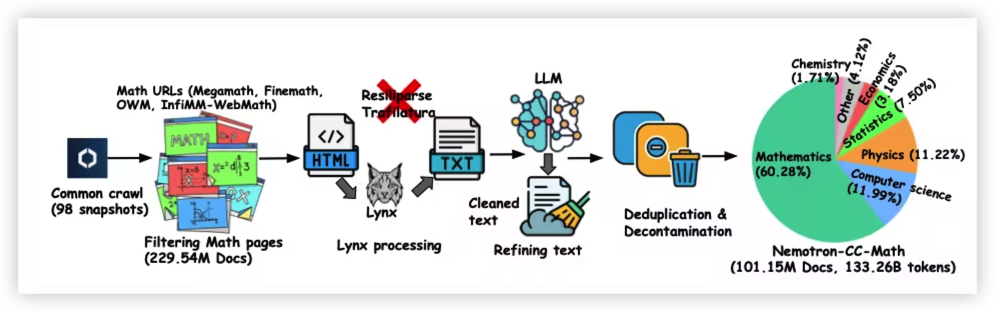
训练数据在大模型竞争中至关重要,NVIDIA推出的Nemotron系列数据集强调数据质量和任务适配性,涵盖通用文本预训练、监督微调和代码生成等核心能力,推动模型训练从数量向精准转变。这些数据集为大模型研究提供系统性支持,提升模型能力。
ScaleCUA是清华大学和Z.AI团队提出的框架,旨在解决Computer Use Agent(CUA)训练数据稀缺问题。通过可验证任务合成、动态学习前沿采样和视觉上下文分割,ScaleCUA显著提升了数据质量和训练效率,使开源CUA在OSWorld上达到了68.7%的新高,超越了参数量大四倍的竞品。这一方法强调了数据质量的重要性,证明了在CUA领域,数据效率优于模型参数规模。
本文探讨了如何利用大型语言模型(LLM)和规则系统解决配置管理数据库(CMDB)中的数据重复问题。通过四个阶段的流水线,LLM提取非结构化文本中的结构化属性,规则层负责判定重复。这种方法有效应对命名不一致和数据质量等挑战,确保数据的准确性和可审计性,最终提升CMDB的数据治理效率,适用于多种场景。
完成下面两步后,将自动完成登录并继续当前操作。