OpenAI将在欧盟为ChatGPT和Codex添加隐形文本水印textGrain,以符合AI法案要求。该技术通过调整用词概率形成统计信号,不插入特殊字符,但改写会降低识别率。检测器暂不公开,仅向合格机构开放申请,未来计划开源。
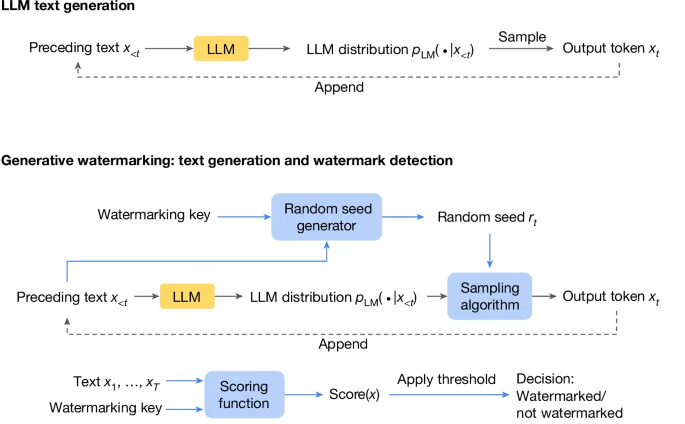
OpenAI推出文本水印系统textGrain,通过影响模型选词嵌入统计信号。API客户可自愿启用,欧盟ChatGPT和Codex将默认加水印以符合AI法案。检测率约80%(200词)至95%(400词),但编辑会削弱信号,代码因选择少更难水印。检测工具初期仅限研究机构。
OpenAI在欧盟为ChatGPT和Codex推出textGrain文本水印,暂不设为全球默认。API客户可自愿启用,研究机构可申请检测工具。OpenAI称水印性能不逊于SynthID,但不保证可靠检测,也不能证明作者身份或准确性。
Anthropic发布Claude Fable 5.1,内置文本水印以识别AI生成内容,但代码等需精确场景不适用。同时限制API新账户保留思考块以防模型蒸馏,现有账户暂不受影响,未来将全面推行。
A社解释Claude AI文本水印机制,非添加Unicode字符,而是通过统计学特征控制词语选择。模型在预测下个词时,对同义词随机选择,水印机制则控制偏好,长内容中检测特定词即可识别,轻度润色也能检测。水印不影响长度、速度,复制粘贴仍可检测,但代码或固定格式文本检测较弱。
本研究提出自信息重写攻击(SIRA),揭示现有文本水印算法的脆弱性。该方法对七种水印的攻击成功率接近100%,显示旧算法的安全风险,强调增强水印鲁棒性的必要性。
文章讨论了一种基于嵌入模型的文本水印技术,旨在保护原创内容。该技术通过在文本中嵌入不可察觉的水印,确保内容在翻译或改写后仍可识别,增强了内容的安全性。
谷歌的SynthID-Text文本水印技术旨在识别AI生成的内容,采用新型Tournament采样算法,保持文本质量,目前仅适用于短文本,但仍是识别AI内容的重要工具。
Google 开源了 SynthID,用于在 AI 生成文本中嵌入水印,提升内容透明度和可追溯性。该工具利用深度学习模型,确保超过 95% 的检测准确率,同时不影响文本质量,对打击虚假信息和维护信息完整性至关重要。
本文评估了文本水印对大语言模型(LLMs)在分类、摘要生成和翻译等任务中的影响,发现水印对多项选择题和短句生成影响不大,但摘要和翻译性能下降15-20%。研究提出了可学习的水印方法,以保护知识产权并提高模型安全性,强调水印技术在检测和防止模型提取攻击中的重要性。
本文综述了文本水印技术,强调其在追踪和验证文本来源中的重要性。研究提出了评估框架,关注水印的质量、大小和防篡改性。自适应水印策略在保持文本质量的同时增强安全性,并对大语言模型的性能影响较小。研究还强调保护知识产权的重要性,并提出新方法嵌入可学习水印以防止模型攻击。
文章更新了文本水印和元数据在文本来源方法中的研究进展。文本水印在局部篡改中有效,但对全球篡改抵抗力不足,可能对某些群体产生负面影响。元数据具有加密签名的优点,能减少误报。此外,提到在图像检测工具中加入C2PA元数据,以确保编辑图像时来源信息的透明性。
本文综述大语言模型文本水印技术,涵盖语义不变水印、自适应水印策略、私有模型保护框架及评估基准。研究关注质量、检测所需标记数和防篡改性,发现水印对选择题和短句生成影响小,但使摘要和翻译性能下降15-20%,并探讨白盒与黑盒检测方法。
本文综述大语言模型文本水印技术,该技术通过在生成文本中嵌入不可见但可检测的信号来追踪和验证文本来源,防止滥用。研究提出基于交叉注意力、随机密钥映射等方法,并评估水印的质量、鲁棒性和防篡改性。实验表明,水印对释义和编辑攻击具有较强鲁棒性,但低熵文本检测较难,且水印鲁棒性与文本质量之间存在权衡。
本文综述音频与文本水印技术:音频水印可在1秒音频中嵌入32位信息,抗十种攻击,误比特率0.48%;音频扩散模型水印用于版权保护;合成语音协同训练提升检测能力;语言模型水印采用私钥嵌入、公钥检测,具鲁棒性,可检测篡改文本,保障模型安全。
本文综述大语言模型文本水印技术,涵盖白盒与黑盒水印框架、语义不变水印、私有水印算法及重要性评分方法。水印对选择题和短句生成影响小,但使摘要和翻译性能下降15-20%,且在文本被破坏40-50%后仍可检测,为追踪文本来源、防止模型滥用提供可靠方案。
本文综述大语言模型文本水印技术:在生成文本中嵌入不可见、可检测的模式,以追踪来源并防止滥用。研究提出涵盖文本质量、检测所需标记数和防篡改性的评估框架,并发布WaterBench基准。结果表明,现有水印已具备部署条件,适度修改文本分布优于追求不可辨认;水印证据随样本增多而累积,对释义等攻击具有一定鲁棒性。
完成下面两步后,将自动完成登录并继续当前操作。