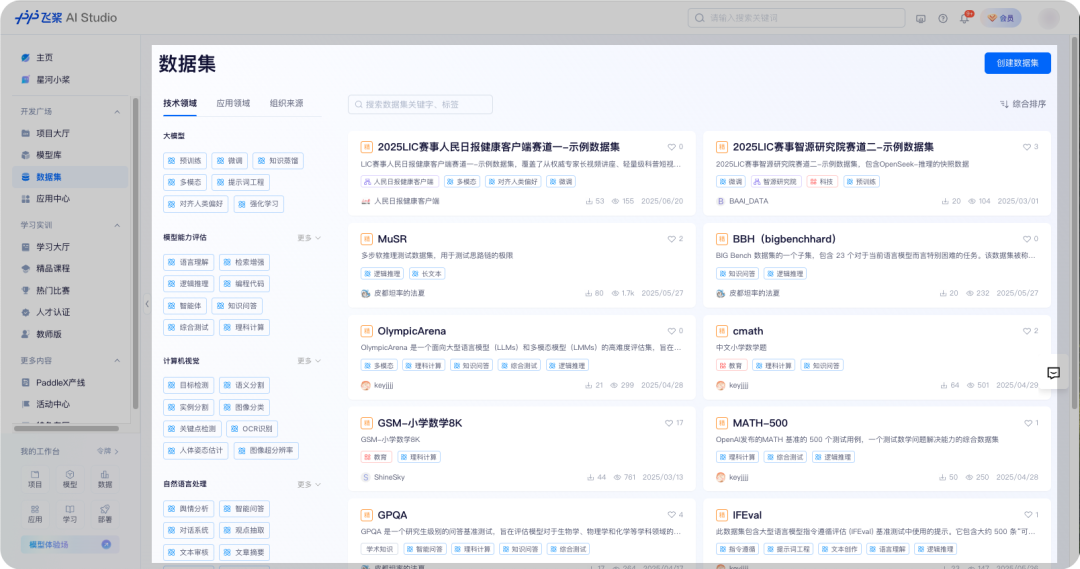
本月动态包括PaddleOCR的异步能力上线,博客新增视频支持,提升用户互动。新增109个数据集,涵盖多模态生成与文档分析。社区活动包括企业级Agentic AI研讨会,探讨智能体在复杂场景中的应用与挑战。
NotebookLM 是 Google 推出的 AI 笔记工具,能够快速分析文档并生成总结,支持多媒体输出。用户只需上传链接即可获取关键信息,适合研究者和学生。该工具重视隐私和安全,帮助用户高效应对信息过载。
OpenAI GPT-5.2已在Databricks上线,提升了准确性和令牌效率,支持企业级工作流。新版本优化了响应API,简化了智能代理开发,增强了文档分析和多步骤执行的可靠性。
Abacus AI推出了首个专业企业AI超级助手,月费仅10美元,提供文档分析、图像和视频生成、团队协作等功能,适合开发者和中小团队。DeepAgent可自动执行复杂任务,企业版提供全面的AI基础设施,适合需要高级AI的企业,性价比高,值得尝试。
Spring AI支持Anthropic Claude的提示缓存,允许重用已处理的提示内容,从而降低API调用成本。通过自动管理缓存断点,Spring AI简化了实现过程,显著减少延迟和费用,适用于文档分析和多轮对话等多种场景。
2025年最新OCR模型具备快速、准确和多功能的特点,适用于扫描文档和复杂布局。推荐模型包括MiniCPM-o、InternVL和Mistral OCR,支持多语言和高分辨率图像处理,满足多种文档分析需求。
在快速发展的技术环境中,运营就绪审查(ORR)确保应用程序的高可用性和安全性。传统的ORR流程耗时且人力资源需求高。本文介绍了结合生成式AI和AWS Well-Architected框架的“ORR on Dify”解决方案,简化了文档分析和评估,提高了效率和一致性,帮助团队快速识别风险和改进机会。
DeepSeek-V3是中国领先的AI机构推出的最新大语言模型,具备128K超长上下文和优化的多语言及中文处理能力,适用于复杂文档分析和智能应用开发,提升开发者效率。
腾讯智能工作台ima.copilot推出DeepSeek-R1,提升知识库管理和信息搜索效率。用户可轻松导入微信资源,利用AI进行文档分析和创作,提升工作效率。
这是一款支持AI研究的桌面应用,具备隐私保护功能,用户可通过简单的点击和上传进行文档和视频分析,支持本地和云端AI,无需编码。
逆向工程(RE)是从现有解决方案中提取信息并以所需格式呈现的过程,属于文档分析技术。RE通常在特定任务背景下进行,需明确任务范围和目标。信息来源包括技术专家访谈、数据分析和现有文档。关键考虑因素有避免过于详尽的文档、确保信息准确性及明确研究范围。
逆向工程(RE)是从现有解决方案中提取信息并以所需格式呈现的过程,属于文档分析技术。RE通常在特定任务背景下进行,需明确任务范围和目标。信息来源包括技术专家访谈、数据分析和现有文档。关键考虑因素有避免过于详尽的文档、验证信息准确性及明确用户沟通特点。
亚马逊在AWS re:Invent大会上推出了Amazon Nova系列基础模型,旨在提升开发者使用生成性人工智能的效率。Nova系列包括理解模型和创意内容生成模型,支持文本、图像和视频处理,适用于文档分析和内容生成等任务,增强企业在AI领域的竞争力,简化应用开发流程。
法律行业正在经历变革,AI法律文档分析提高了效率,减少了错误,简化了工作流程。AI能够自动提取和分析法律文档数据,帮助律师快速完成合同审查和法律研究,从而节省时间和成本。AI的应用使法律服务更加精准高效,推动行业向数据驱动和创新发展。
Google Gemini 1.5 Pro是一种先进的AI模型,用于文档分析。它集成了文本、图像、表格和图表,实现了全面的分析。它提高了数据提取和解释能力,自动化了耗时的任务,增强了合规性,实现了实时分析,并可根据特定行业进行定制。它在法律、医疗、金融、零售和电子商务等领域都有应用。挑战包括将其整合到现有工作流程中以及对数据安全的担忧。预计将持续更新和改进。Google Gemini 1.5 Pro革新了文档分析,改变了企业处理数据的方式。
本文介绍了一种多模态神经网络,通过结合OCR提取的文本和图像信息进行文献图像分类,准确率提高了3%。研究提出了多种深度学习模型,包括基于DocParser的OCR-free信息提取模型和SDL-Net结构化文档分析模型,这些模型在不同数据集上均取得了先进成果,显著提升了文档图像的处理和理解能力。
本文介绍了多个大型数据集和模型在科学文本生成和文档布局分析中的应用,包括 Multi-XScience、DocBank 和 SciXGen。研究表明,基于 Transformer 的模型在文献综述生成和文档理解方面表现优异,但仍面临信息缺失和推理能力不足的挑战。
MemGPT系统在文档分析和对话代理领域有广泛应用。在文档分析方面,MemGPT通过将相关上下文分页进出内存,处理长篇文本。在对话代理方面,MemGPT能够维持长期记忆、一致性和可发展性。未来研究方向包括将MemGPT应用于其他具有庞大或无界上下文的领域,集成不同的内存层技术,并改进控制流程和内存管理策略。
MemGPT系统在文档分析和对话代理领域的应用。在文档分析方面,MemGPT通过将相关上下文分页进出内存,能够处理超出当前LLM上下文限制的长篇文本。在对话代理方面,MemGPT能够维持长期记忆、一致性和可发展性,以应对扩展对话。未来的研究方向包括将MemGPT应用于其他具有庞大或无界上下文的领域,并进一步改进控制流程和内存管理策略。
本文介绍了多种表格结构识别方法,如分割、嵌入和合并(SEM)、TSRFormer、RobusTabNet等。这些基于深度学习的技术提高了表格检测和结构识别的准确性与效率,并在多个基准数据集上取得了最先进的表现,推动了文档分析的发展。
完成下面两步后,将自动完成登录并继续当前操作。