开源项目 Strata 支持在普通电脑本地运行千亿参数大模型 Qwen3.8-Flash-Next,通过将部分模型放入内存和固态硬盘,8GB 显存即可运行,但内存需 32GB 起步、推荐 64GB。生成速度约 20 至 70 tok/s,40 以上可用,无需 API 费用,AMD 用户可用 gufo。
GitHub热门开源项目Colibrì是一个纯C实现的分层推理框架,通过将MoE模型不常用的专家权重存放在SSD、常用部分缓存在RAM/VRAM,使低配设备也能运行超大模型。它支持GLM-5.2、Kimi K3等9个模型,最低16GB内存即可运行744B模型,无需GPU,并采用LRU缓存与专家预测提升速度。
英伟达发布Linux驱动595.104.02维护版,修复Wayland下HDR元数据未校验导致的崩溃,以及GPU页表超2GiB时显存分页分配失败的问题,无新功能。需新功能可安装615.71.09功能分支版。
文章澄清上下文窗口与KV Cache的区别:前者是单次请求的容量上限,后者是自回归解码中缓存历史Key/Value、以空间换时间的计算账本。DeepSeek V4.1 Flash将全局KV Cache降至每Token约890字节,但整机显存还需计入权重、并发等。长上下文不等于召回准,也不等于长期记忆,部署需实测峰值显存与延迟。
6GB显存可运行Qwen3.6-35B-A3B-NVFP4,但需32GB以上内存,依赖CPU和PCIe。配置建议:Triton attention、memory-ratio 0.92、Prefill 2048、512专家槽。性能低于8GB的39.3 tok/s,适合短上下文和编码实验。需Ampere架构,逐步调优专家缓存和KV,实测不同后端。
英特尔在广州举办AIGC创作研讨会,推出基于锐炫Pro B70专业显卡的本地化AI视频制作方案。该显卡具备32GB显存和367 TOPS算力,支持“云端+本地”混合模式,降低算力门槛,实现从剧本到成片的全流程生成,助力中小团队高效创作。
文章实测Qwen 3.8 27B模型通过YaRN技术扩展上下文长度,发现实际可从265K扩展至768K,而非宣传的1M,原因是1M时KV Cache需84GB显存,超出128GB机器可用内存约3GB。作者计划进一步测试768K上下文在实际编程中的表现。
FreeToken通过专家缓存与CPU-GPU协同,在8GB显存上运行35B MoE模型。它将完整专家池存于内存,显存作为LRU缓存,按q*策略动态分配未命中专家至GPU或CPU,Prefill用双缓冲隐藏传输,并优化Agent状态缓存。相比llama.cpp静态卸载,FreeToken更高效,但仅适用于MoE模型。
传闻英伟达正开发新技术,利用高速SSD作为额外显存,结合RTX IO和微软DirectStorage,让GPU直接处理SSD数据,缓解显存不足时的卡顿。此举或为应对内存价格高企,但消息尚未证实。
2026年本地部署大模型趋势显示,万亿参数模型如Kimi K3可通过流式加载在8GB内存CPU上运行,但速度极慢。部署关键取决于显存容量和内存带宽,8GB适合小模型,80GB以上可运行120B模型。DeepSeek V4 Flash经量化可在128GB内存设备运行。工具选择上,LM Studio适合新手,Ollama适合开发者,llama.cpp提供精细控制。本地部署需权衡成本、速度与隐私。
英伟达通知显卡厂商上调GDDR显存价格,8月生效,导致AIC厂商封仓停售,显卡供应缩减、价格上涨。8GB显存涨76美元,12GB涨114美元,16GB涨152美元,影响RTX50系及部分中低端显卡,RTX 50 SUPER系列或暂缓发售。
AMD MI455X与NVIDIA Rubin在AI芯片性能上存在显著差异。虽然AMD的显存容量为432GB,NVIDIA为288GB,但生成速度主要取决于内存带宽而非容量。AMD通过增加堆栈数量提升容量,而NVIDIA则提高每个堆栈的速度以增强带宽。最终,带宽对大模型推理速度的影响更为关键,AMD适合处理更大模型,而NVIDIA优化了数据搬运速度。
本文讨论了PyTorch中GPU性能优化的关键概念,特别是内核与显存读写的关系。内核是GPU执行的程序,性能主要受数据在显存中读写次数的影响。通过操作融合可以减少显存流量,提高运行速度。此外,使用torch.compile工具可以自动优化代码,减少内核数量,提升性能。
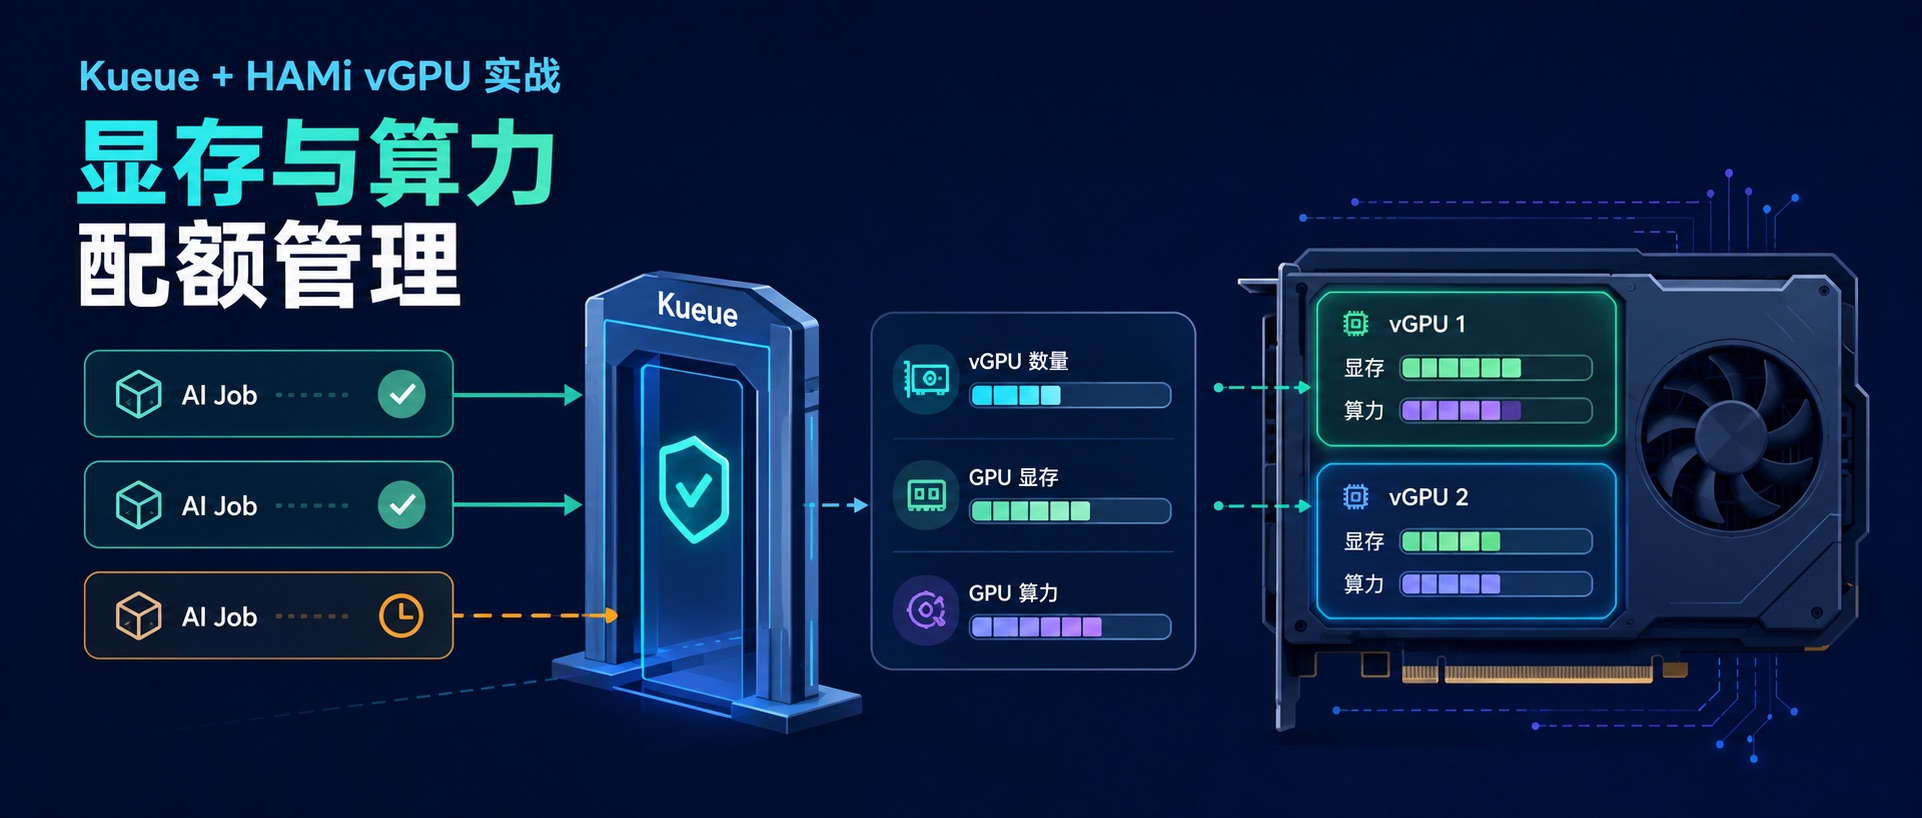
本文讨论了Kueue与HAMi vGPU的结合,重点在于GPU显存和算力配额的管理。通过环境准备、资源模型和演示,展示了在Kubernetes中有效切分和管理GPU资源的方法,确保多个任务合理使用GPU,避免资源冲突,实现GPU集群的多租户管理能力。
FlashAttention通过分块在线softmax优化Transformer的注意力机制,显著降低显存和计算速度瓶颈。它采用流式计算,避免物化整个分数矩阵,减少内存访问,提高效率。实测表明,FlashAttention在长序列处理上具有显著优势,并在反向传播时通过重算降低显存需求。
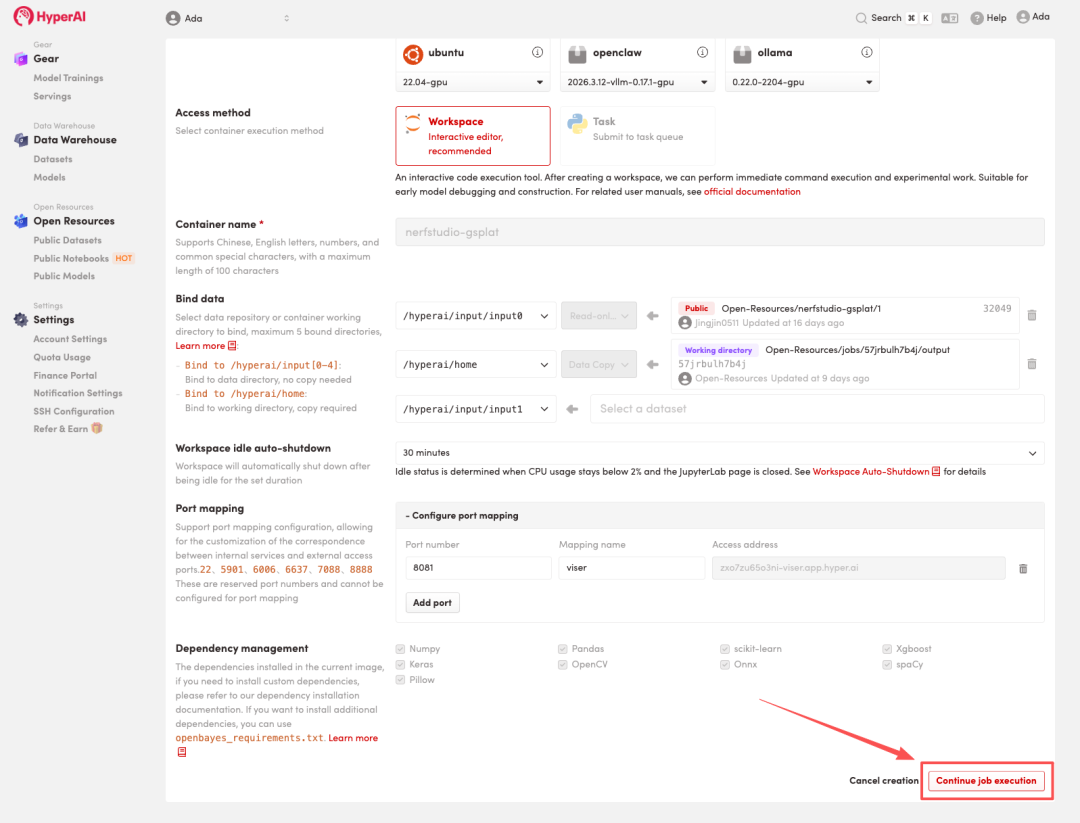
自2023年《3D Gaussian Splatting for Real-Time Rendering of Radiance Fields》发布以来,3DGS技术在三维重建领域迅速崛起。与传统NeRF相比,3DGS在渲染速度和视觉质量上有显著提升,但对显存和计算资源的要求较高。加州大学伯克利分校等机构开发的开源项目gsplat优化了训练框架,显著降低了资源需求,支持多种数据来源,并提供实时Web查看功能,便于快速验证模型。
AMD计划在2026年第三季度对RX9000系列显卡涨价10%~15%,原因是显存价格上涨。尽管涨价在计划中,可能会影响销量。显卡价格普遍上涨,尤其是高性能显卡。英伟达暂时不打算涨价,但高价显卡仍让消费者困扰。制造商面临滞销风险,零售商可能需降价以回收成本。
GLM-5.2是一个7530亿参数的开源大模型,具有百万token的上下文窗口和创新架构。其完整权重为1.51TB,普通硬件无法支持。最佳本地运行选择为256GB内存的Mac Studio,生成速度为每秒3-9个token。大多数用户应选择云GPU租用或API调用,以降低成本和技术门槛。
谷歌发布了Gemma 4 12B多模态模型,支持文本、图片、视频和音频输入,能够在仅16GB内存的消费级设备上运行。该模型采用无编码器架构,降低延迟并简化输入处理,智能化程度接近Gemma 26B版。开发者可在多个平台体验和下载该模型。
文章讨论了在本地运行小型开源模型的可行性,特别是使用llama.cpp项目。作者分享了在Windows上使用3060显卡运行Qwen3.6 9B模型的设置,包括CUDA版本和参数配置。尽管显存有限,这些模型在简单任务中仍能有效使用。
完成下面两步后,将自动完成登录并继续当前操作。