Strata 0.2.7.1 发布,新增支持 NVIDIA DGX Spark,并让 Apple 芯片 Mac 可运行 DeepSeek V4.1-Flash。0.2.7 版重点优化 12GB 及以下显存的 NVIDIA 显卡,RTX 3060 生成代码速度提升 37%,普通文本提升约 15%;原理是优先选用已驻留显存的专家模型,代价是 Agent 任务通过率略降。此外还优化了 DeepSeek 提示词处理,新增超长上下文选项和网页聊天功能。
MiniMax H3 视频生成优化:将 BF16 Qwen3-VL 32B 编码器量化,显存占用从 64GB 降至 16GB,使其可与视频生成模型共存。编码器充当文本翻译器,把用户提示词转为模型可理解数据,再调用 H3 API 直接生成视频,无需安装 ComfyUI。
本文介绍数据并行与ZeRO优化技术。ZeRO通过三级分片(优化器状态、梯度、权重)减少显存占用,前两级不增通信量,第三级需额外all-gather。ZeRO-1每参数4+12/N字节,ZeRO-2为2+14/N,ZeRO-3降至16/N。分片可放CPU,用双缓冲减少GPU占用,但需PCIe带宽支持。
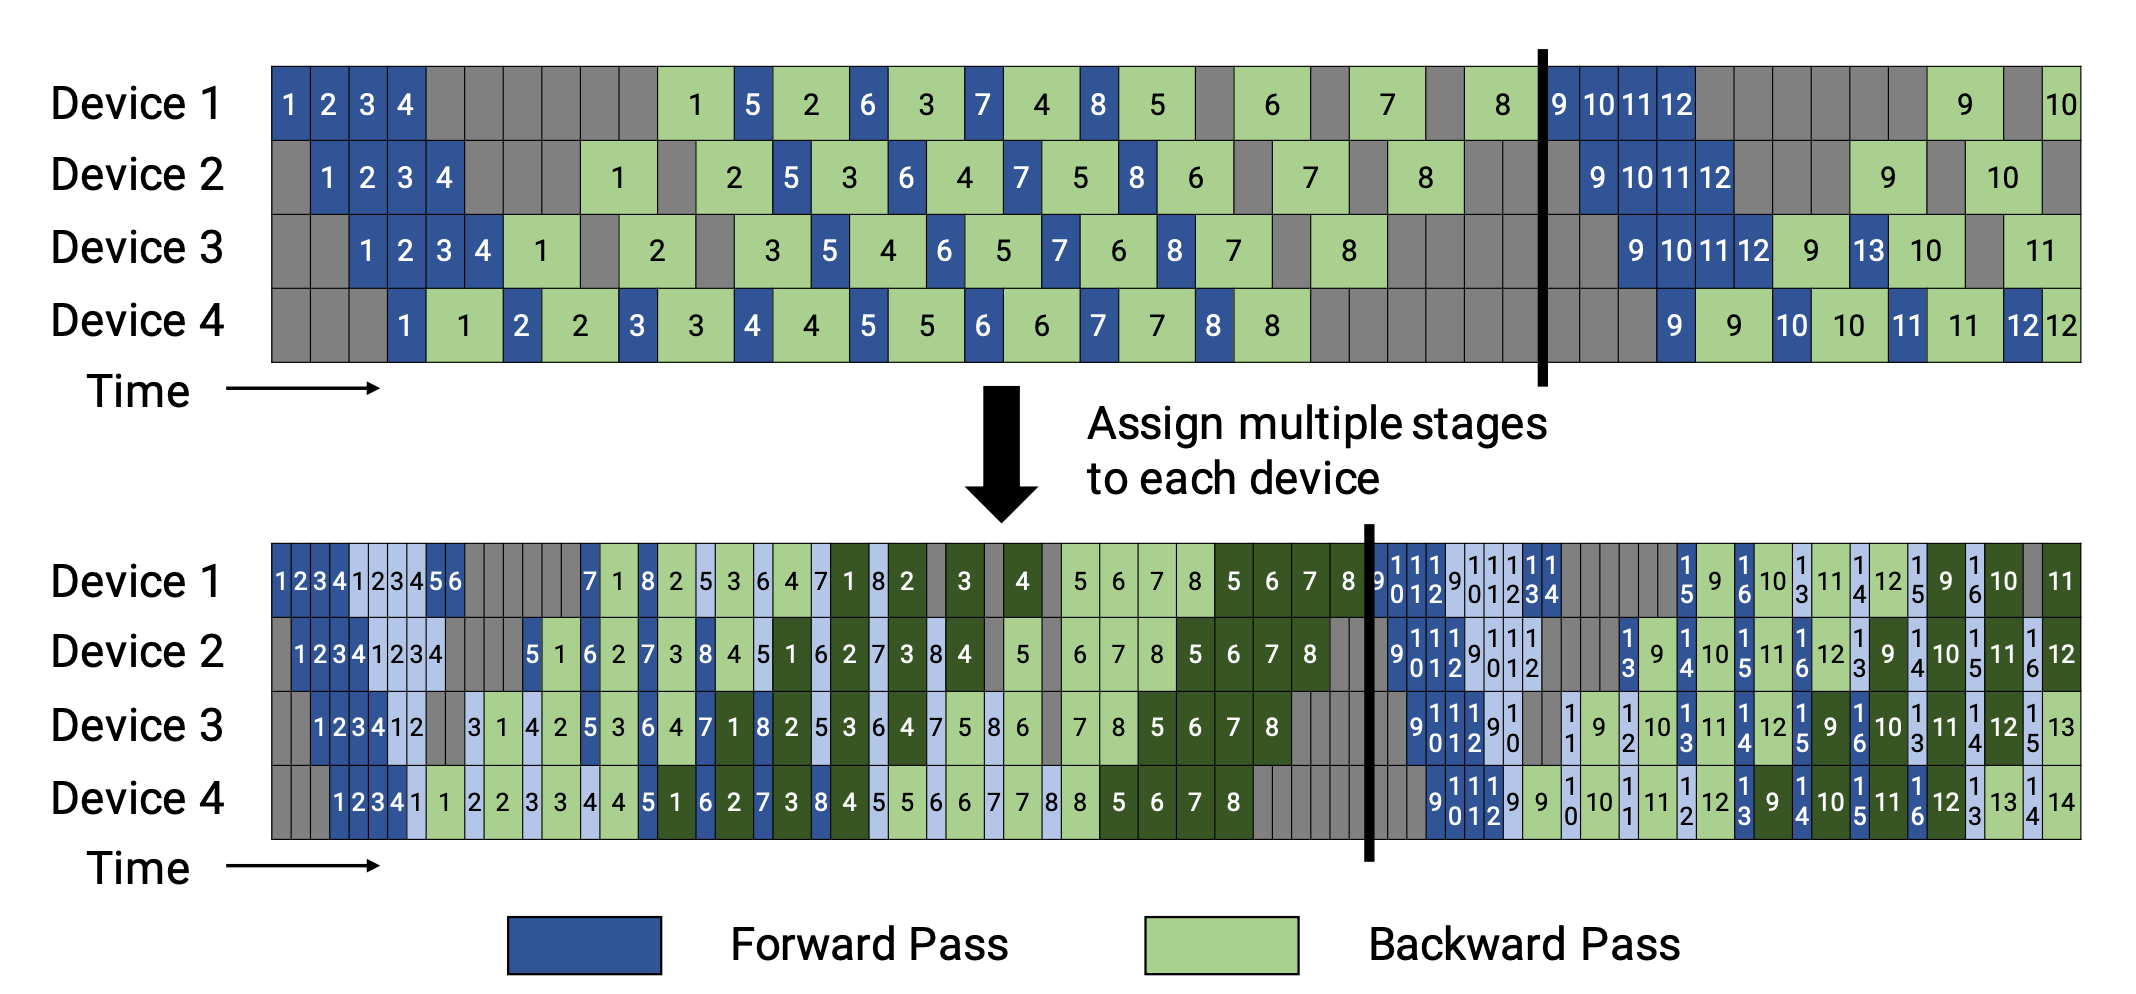
本文详解Kimi K3模型训练中的显存优化策略,通过账本形式分析权重、激活等内存占用,并介绍六项关键技术:均衡PP rank激活、统一激活管理器、MoE反向改写、AttnRes块复用、Pipeline ZeRO-2及P2P Muon,以显存换效率,实现2.8T参数的高效训练。
FreeToken通过专家缓存与CPU-GPU协同,在8GB显存上运行35B MoE模型。它将完整专家池存于内存,显存作为LRU缓存,按q*策略动态分配未命中专家至GPU或CPU,Prefill用双缓冲隐藏传输,并优化Agent状态缓存。相比llama.cpp静态卸载,FreeToken更高效,但仅适用于MoE模型。
Shoehorn是一款用Rust编写的开源工具,通过精确到字节的混合精度量化,优化大语言模型在显卡显存中的分配。它先探测显存,计算权重预算,再用重要性矩阵和背包算法为每个张量选择最优精度,最大化模型质量。测试显示,它可将显存利用率提升至99.998%,困惑度降低近半,支持一键命令行和Web界面,兼容多平台。
FlashAttention是一种IO感知的精确注意力算法,通过分块和在线softmax避免物化完整注意力矩阵,减少HBM读写,提升效率并降低显存占用,虽FLOPs仍为O(n²),但优化了硬件执行路径,使长序列训练更可行。
KV Cache 是自回归推理中缓存历史 token 的 Key 和 Value,避免重复计算前缀。它利用历史 K/V 不变性,将重复计算转为显存占用,成为长上下文推理的核心瓶颈。推理分 prefill 和 decode 两阶段,KV Cache 内存随层数、序列长度和 batch 线性增长。GQA、PagedAttention 和量化等技术用于优化 cache 管理,平衡性能与资源。
本文介绍如何在PyTorch多进程推理中通过CUDA IPC共享模型权重,避免GPU显存重复占用。示例展示了使用`model.share_memory()`共享权重,以及AOTInductor通过`load_constants`绑定父进程权重的方法。文中还讨论了配置要点、TorchScript的局限及程序依赖的重复问题,旨在提升单GPU多进程推理效率。
英伟达推出NeMo AutoModel,基于Transformers v5,提升MoE模型微调速度3.4-3.7倍,显存减少29%-32%。通过专家并行、DeepEP和TransformerEngine等技术,优化内存和计算效率。用户只需添加一行代码即可实现升级,支持更大批次和更长序列,相关代码已开源。
本文讨论了在WSL、Windows和Kaggle上部署PaddleOCR-VL的过程,指出了显存不释放和程序卡死等问题。作者分享了详细的安装步骤和代码示例,并提出了优化显存使用的方法。
阿里云 TorchAcc是一个基于PyTorch/XLA的大模型分布式训练框架,提供多样化的并行策略和显存优化功能,通过图形优化和通信优化提高了分布式训练的效率和性能。该框架在多个模型的分布式训练场景中表现出显著的性能优势。
训练超大规模神经网络需多GPU并行,主要方法包括:数据并行(复制模型、切分数据,分同步与异步)、模型并行(按层切分)、流水线并行(拆分小批次以减少空闲)、张量并行(横向切分运算)。混合专家通过门控稀疏激活专家,GShard、Switch Transformer和专家选择路由可提升规模与效率。显存优化方法包括CPU卸载、激活重计算、混合精度、压缩和ZeRO。
完成下面两步后,将自动完成登录并继续当前操作。