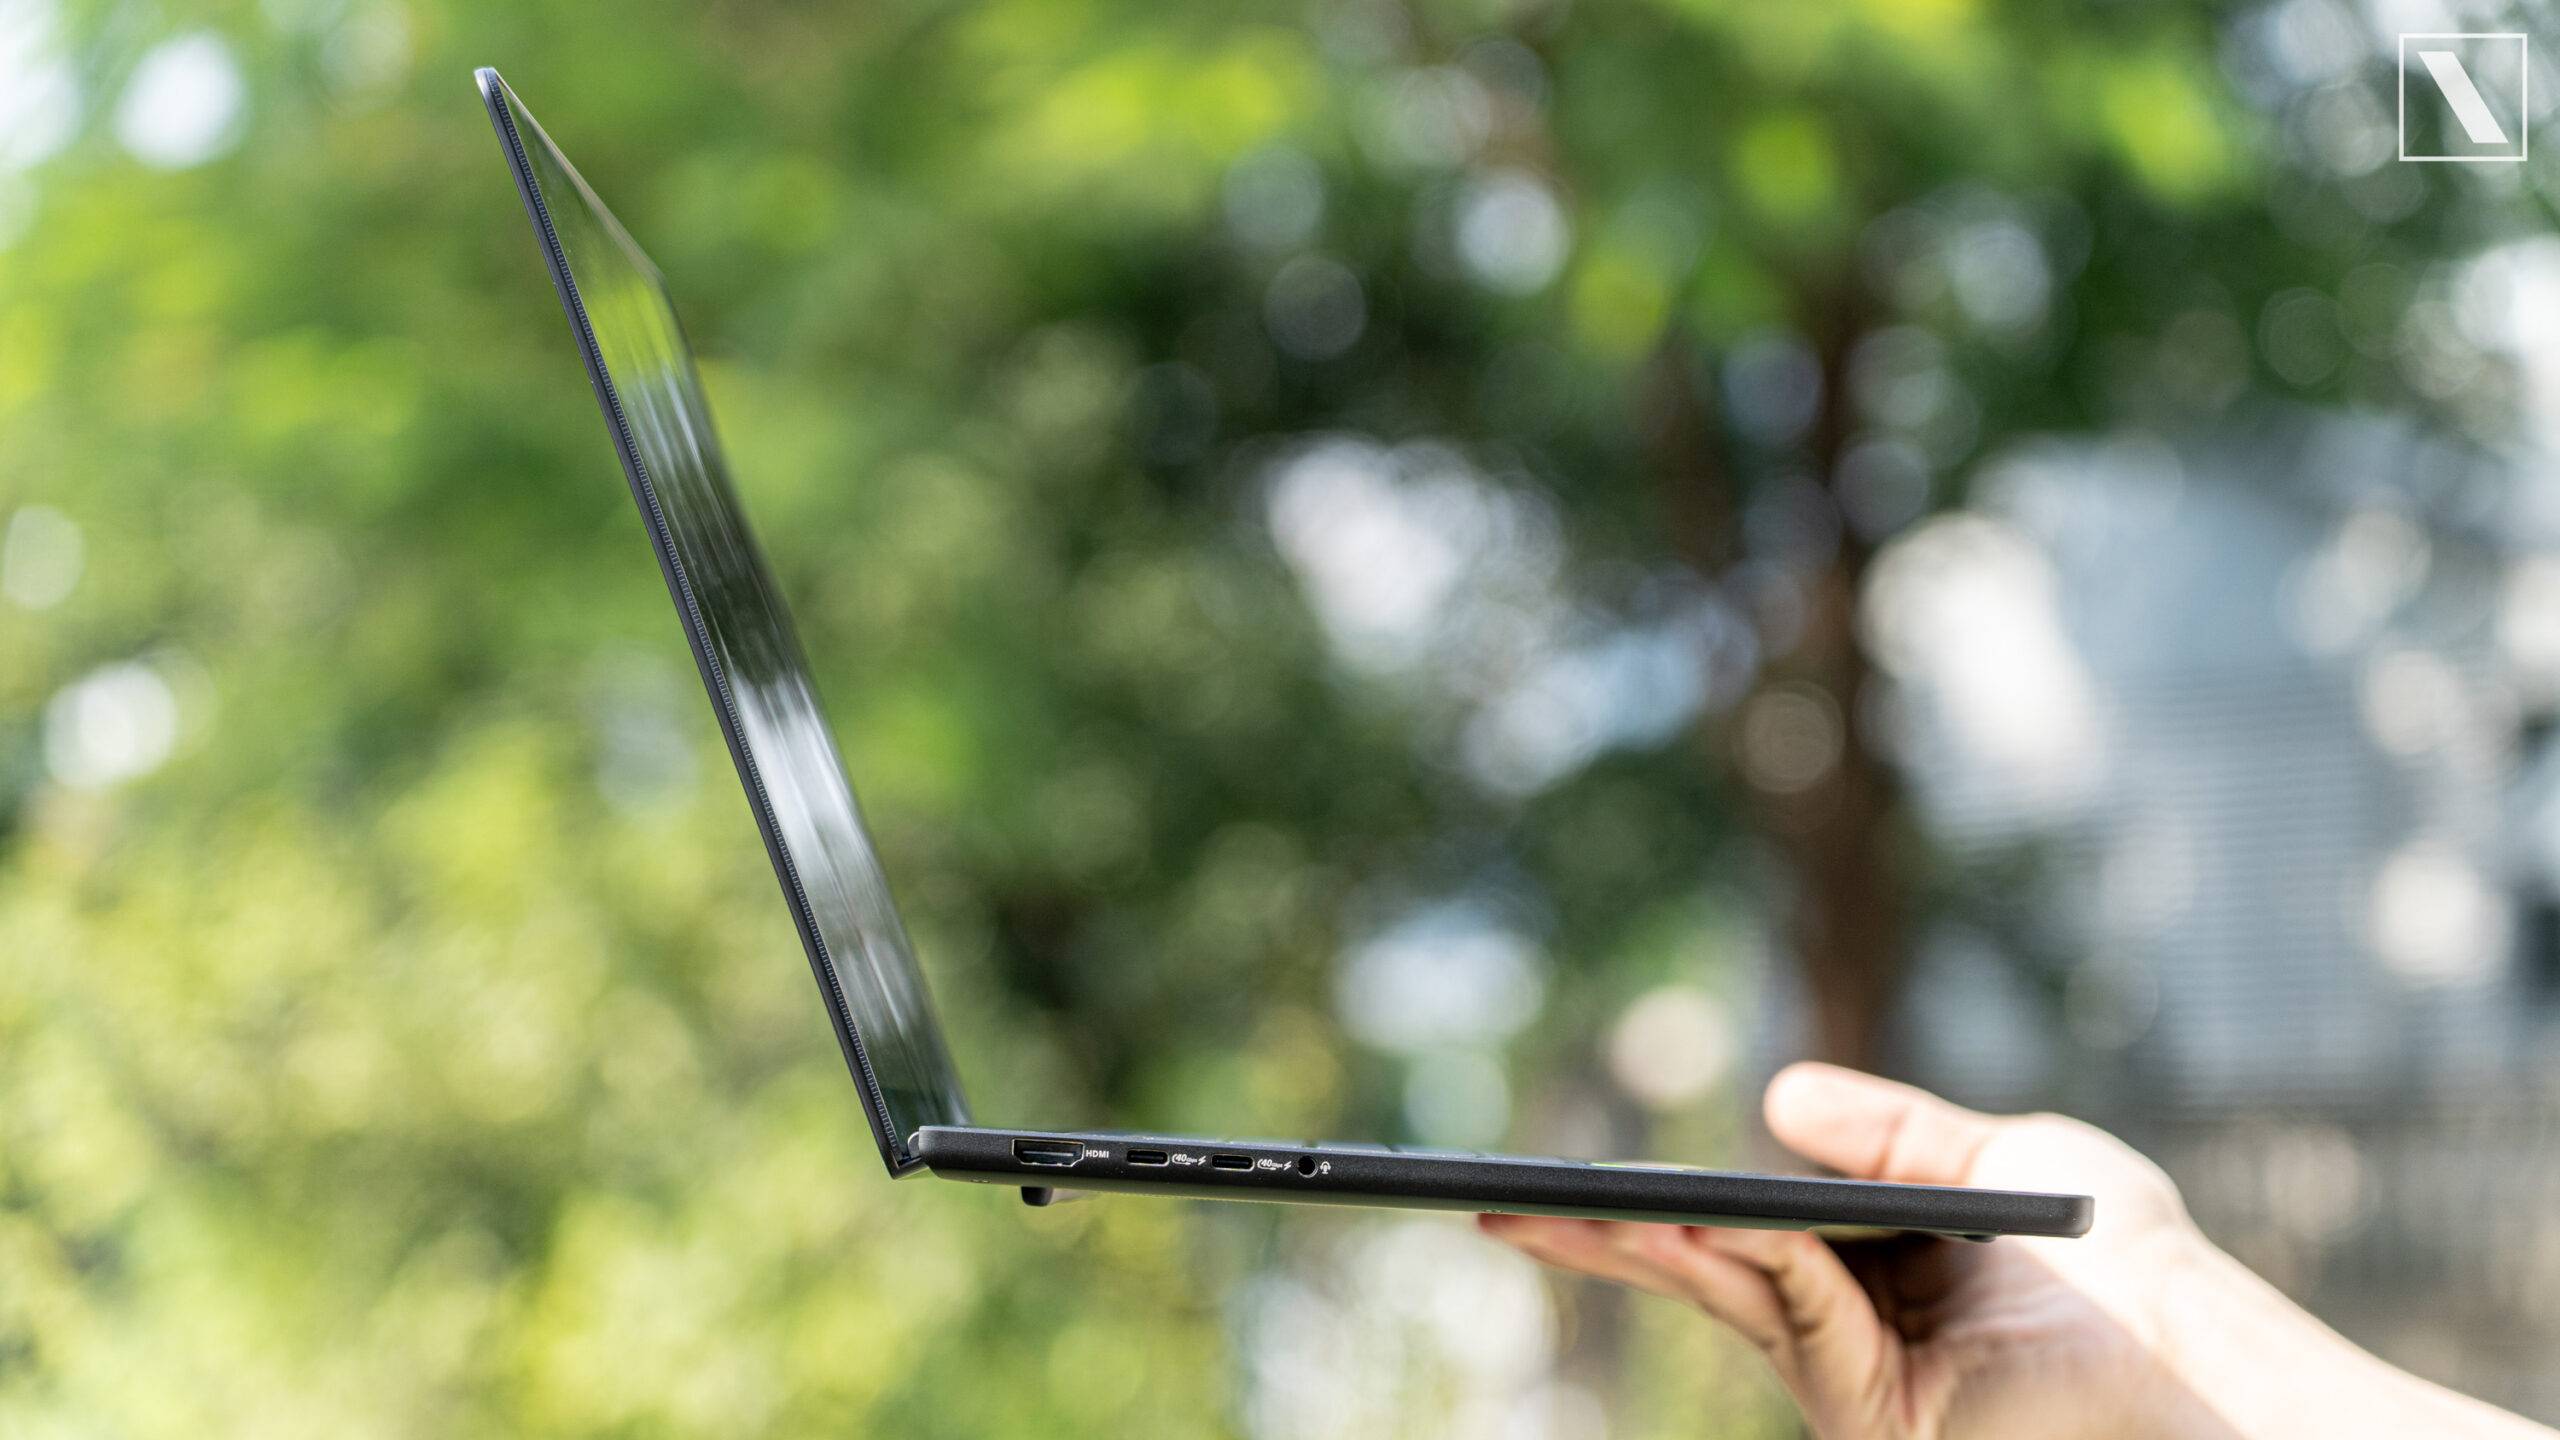
英伟达推出首款搭载RTX Spark超级芯片的Windows笔记本华硕ProArt创16,售价28999元起。该机采用ARM CPU、Blackwell GPU与统一内存,可本地运行270亿参数大模型,续航约1小时15分钟。实测AI推理流畅,配合WorkBuddy可下载本地模型。适合需本地算力的开发者,普通用户暂无需为此换机。
苹果介绍在 Mac Studio 上通过 MLX 本地运行大模型。M5 Ultra 的 GPU 神经加速器使首字延迟较 M3 Ultra 快 4.6 倍,生成速度提升 1.6 倍,功耗约 300 瓦。借助 Thunderbolt 5 上的 RDMA,多台 Mac 可进行流水线或张量并行,四台集群运行近万亿参数的 Muse Spark Open 可达每秒 36 个 token,并支持本地智能体应用。
联想在IFA 2026发布Yoga Pro 9n笔记本,搭载英伟达RTX Spark芯片,配备最高128GB统一内存,可本地运行千亿参数大模型,支持100万token上下文。此举将AI算力带入Windows生态,与苹果Mac系列竞争。联想还推出ThinkCentre X Ultra等产品,推动AI Agent从云端转向本地设备,使电脑成为个人AI算力节点。
苹果未开发布会直接上线新款 Mac Studio,顶配 512GB 统一内存回归,可本地运行数百 B 参数大模型。M5 Ultra 带宽达 1.2TB/s,SSD 升级 PCIe 6.0。其价值不在省订阅费,而在数据主权,适合法律、医疗等敏感场景,是普通人可正规购买的大容量本地 AI 一体机。
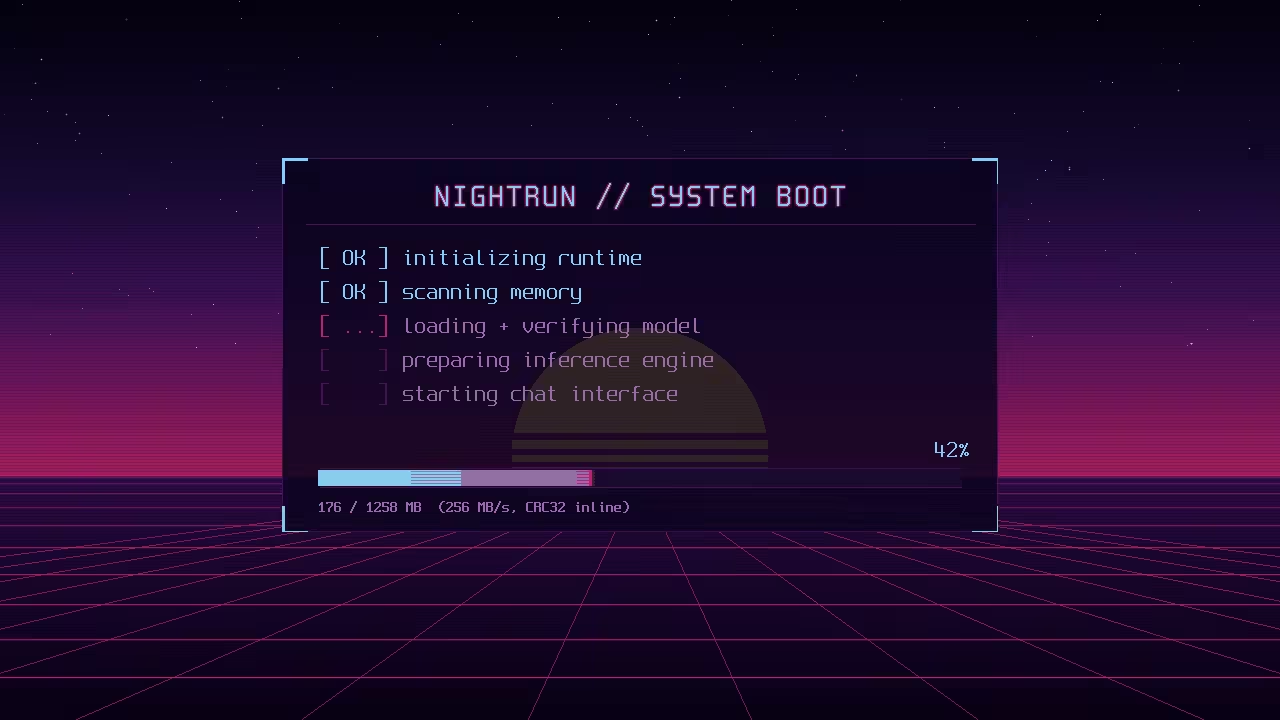
NIGHTRUN是一个极客项目,可直接从U盘通过UEFI启动进入本地大模型对话界面,无需操作系统,支持Llama等模型,纯CPU运行。开发者称其为技术炫技,实际价值有限。若未来支持GPU或内嵌大模型的CPU普及,可能更具实用性。
由于AI Token价格昂贵,许多用户开始转向本地大模型。llmfit软件可以测试电脑能运行哪些模型,而CanIRun.AI网站则无需下载,自动识别硬件并提供可用模型列表。
LM Studio是一个适合非技术用户的本地大模型工具,提供友好的图形界面和零配置操作,支持多平台。用户可以从Hugging Face等平台下载多种模型,确保隐私并支持离线运行。该工具还支持GPU加速,适合本地AI写作和问答服务。
Ollama 是本地运行 Llama 2、Gemma 等大模型的命令行工具,支持 macOS、Linux、Windows。以 Mac 为例,下载后放入应用目录,执行 `ollama run gemma:2b` 即可自动下载并运行模型,生成诗歌、评论等文本。它还提供 REST API,通过 `/api/generate` 和 `/api/chat` 发送请求,返回流式 JSON 响应,逐字输出生成内容。
完成下面两步后,将自动完成登录并继续当前操作。