端侧大模型设备选型应依次考虑数据边界、交付形态和本地算力。PocketClaw是预装智能体系统的迷你主机,模型经云端API完成,上手快但数据需出设备;PokeClaw是开源安卓应用,基于Gemma 4纯CPU本地推理,数据不出设备但启动慢、能力受限;专用端侧芯片方案算力最强但集成成本高。选型还需关注工具链成熟度。
文章以本地推理为例,说明流式输出需生成端、边界与界面协同:异步流逐项产出,背压用有界队列反馈消费速度,协作式取消让生产端在检查点停止并释放资源。三者缺一,界面看似流式仍会积压内存或占用算力。作者用Python最小程序验证慢消费者取消,并指出常见误区:前端停渲染不等于取消、队列越大越平滑、本地推理无需超时。
介绍为 laya-coreml 模型封装类型安全 API:用 Pydantic 定义布尔判断与多分类的输入输出结构,封装本地推理客户端,在 Apple Silicon 上约 5 毫秒完成推理;再用 FastAPI 包装为 HTTP 服务并自动生成 OpenAPI 文档,供前端生成类型安全的请求代码。默认模型限 96 token,长文本需换用支持 1024 token 的版本。
英伟达发布免费开源工具PAIR,可将家中闲置电脑(如RTX显卡PC、MacBook)联网组成个人AI数据中心,用于本地AI推理任务。PAIR非硬件路由器,支持Windows、Linux和macOS,通过六位码和mTLS加密保障安全,能动态适应设备加入或离开,避免干扰用户正常使用。
2026年,.NET生态出现三个本地大模型推理引擎:LLamaSharp借力llama.cpp,性能稳定但依赖原生库;dotLLM纯C#实现,CPU解码追平C++,但预填充慢,零原生依赖;TensorSharp融合GGML内核,GPU吞吐领先,支持多模态和集群。三者各具优势,求稳选LLamaSharp,求纯选dotLLM,求全选TensorSharp,C#本地推理已成熟。
Gemma 4 12B是谷歌DeepMind推出的新型多模态智能模型,旨在直接在笔记本电脑上运行。它采用无编码架构,集成视觉和音频输入,性能接近更大模型,但内存占用更低,适合日常硬件使用。
现代智能手机具备强大的计算能力,可以离线运行人工智能模型。QVAC平台允许用户在本地设备上处理数据,增强隐私和控制。本文介绍了如何使用React Native构建与QVAC交互的应用程序,实现本地AI推理,避免依赖云服务,从而提高响应速度和安全性。
DeepSeek V4发布后,开发者antirez推出了专属推理引擎ds4.c,旨在提升Mac上的运行效率。该引擎使用C和Metal编写,专注于本地推理,支持高效的量化和KV缓存。测试表明,ds4.c在高端Mac上表现优异,生成速度快。antirez希望通过此项目推动本地推理的发展,并强调AI辅助开发的重要性。
本文介绍了如何通过n8n、MCP和Ollama在本地工作站或小型服务器上实现自动化,替代脆弱的脚本和昂贵的API系统。内容涵盖日志处理、数据质量监控、数据标记、研究更新、事件后期分析、合同审查和代码审查等自动化工作流,强调本地推理的高效性和控制力。
本文介绍了如何在本地高效运行GPT-OSS 20B模型,使用llama.cpp和Open WebUI。通过简单的命令设置Python环境、安装必要的包、下载量化模型并启动服务器,用户可轻松获得现代聊天界面,实现本地推理。
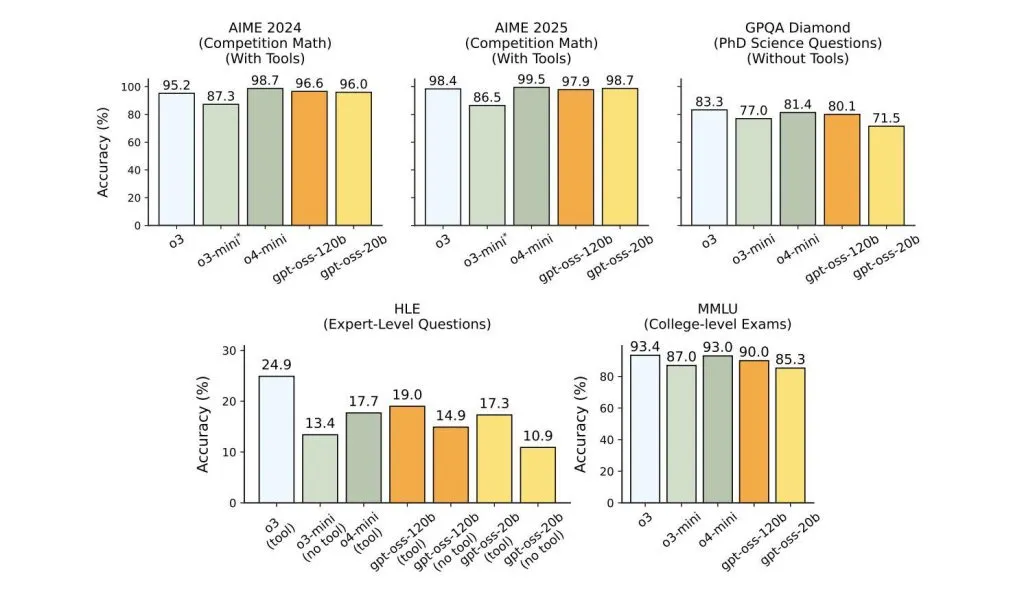
OpenAI 发布了两个开放权重语言模型:GPT-OSS-120b 和 GPT-OSS-20b,允许用户下载和微调。这一举措推动了 AI 领域的透明性和定制化,支持本地推理,确保数据隐私,适用于多种设备,促进本地 AI 创新。
Docker Model Runner 是 Docker Desktop 的新功能,旨在简化本地运行和测试 AI 模型的过程。它通过将推理引擎嵌入 Docker Desktop,提升性能并优化用户体验,支持从 Docker 和 Hugging Face 拉取模型,特别在 Apple 硅系统上实现 GPU 加速。
DeepSeek-R1是一个开源的本地推理模型,性能与OpenAI相当,适用于多种硬件配置。用户可通过Ollama工具在本地运行该模型,支持多种参数选择,安装后可通过命令行或浏览器插件进行交互,提升使用体验。
本研究探讨大型语言模型在移动设备上的应用,分析硬件和网络的进步,提出高效的本地推理和低延迟响应方案,以促进移动智能应用的发展,提升用户体验和数据隐私安全。
Mistral AI发布了两款小型语言模型Ministral 3B和8B,称为les Ministraux,专为本地推理应用设计,性能优于同类模型。8B模型采用滑动窗口注意力机制,推理速度更快。与之前的Mistral 7B不同,les Ministraux需商业许可,并可通过API访问,适用于隐私优先的关键应用。
本文介绍了如何在本地配置PaddleSpeech进行语音合成的本地推理,包括下载音色模型和声码器,编写推理脚本等。同时,提供了两个声码器对象的选择,以及一个音频内容的字典用于生成音频文件。最后,给出了一个基于声学模型FastSpeech2的鬼畜视频一键生成项目的链接。
本文介绍如何使用PaddlePaddle和PaddleGAN构建“懂王”,实现唇形与语音同步,让人物看起来仿佛在唱歌。需要配置Python3.10和CUDA/cudnn,安装PaddlePaddle和PaddleGAN,并进行本地推理。成品视频可在Youtube/B站搜索:刘悦的技术博客,提取码为oo0d。
完成下面两步后,将自动完成登录并继续当前操作。