Humanizer是开源120亿参数模型,基于Gemma微调,可将AI生成文本改写得更像人写。文章介绍在Linux上用llama.cpp本地部署Q8_0量化版,通过API改写文本,并用GPTZero等检测器测试。结果显示AI检测分数从100%降至49%,但作者多次测试效果不稳定,约五五开,且AI检测器本身并不可靠。总体而言,它是免费本地替代方案,但结果不一致,建议自行审校。
英伟达扩展开源模型组合,覆盖语言、机器人、生物、量子计算等领域,包括Nemotron 3.5、Kumo、Cosmos 3.5、Alpamayo 2 Edge、BioNeMo及Ising等,支持欧洲开发者基于本地数据定制并部署于自有基础设施。多家企业已将其用于构建行业智能体、结构化数据预测、自动驾驶、蛋白质设计和量子校准。
文章介绍五个可本地部署的Docker工具,用于替代将敏感数据粘贴到陌生网站:IT-Tools集成JSON、JWT、Base64等日常小工具;CyberChef通过可保存的“配方”链式解码转换数据;ConvertX借助FFmpeg、LibreOffice等转换千余种文件格式;Hoppscotch CE在本地管理API请求与集合;Kroki将文本渲染为图表。建议按需逐步部署,用Compose统一管理,固定镜像版本,并保持服务不暴露公网。
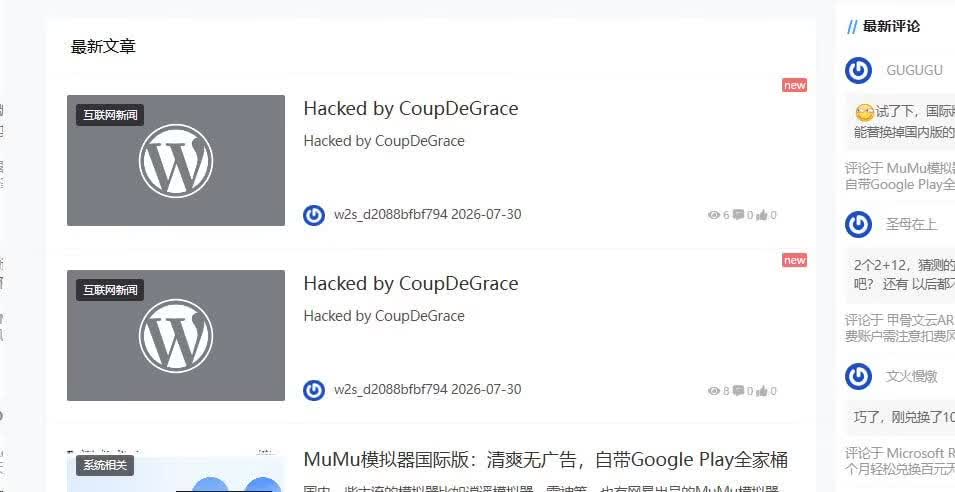
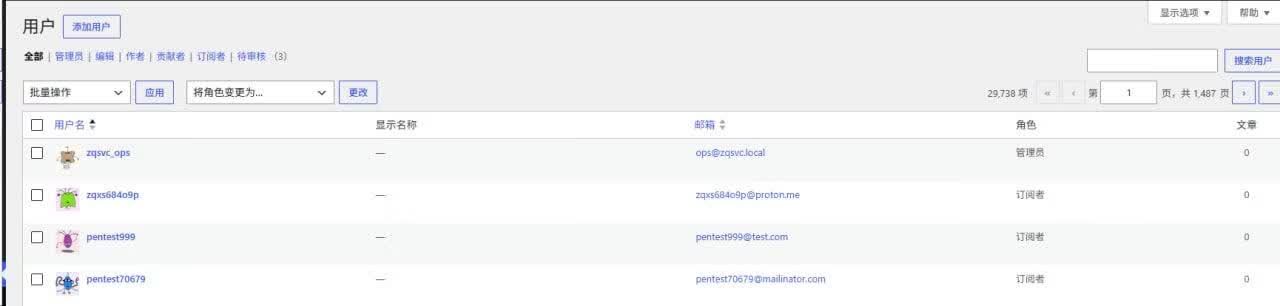
博客三个月内三次被黑,攻击者新建管理员用户并清空主题设置。排查发现插件目录存在木马、首页被注入创建管理员的恶意脚本,主题还引用了有投毒历史的cdn.staticfile.org。作者随后清理全部用户和数据库冗余,将第三方JS、CSS、字体改为本地部署,更换新服务器并重装Nginx,同时配置EdgeOne缓存规则,对后台、PHP及带Cookie请求禁用缓存。
博客三个月内三次被黑,攻击者均新建管理员用户并清空主题设置。排查发现插件目录存在木马、首页及wp_options表被注入恶意脚本,主题还引用了有投毒历史的cdn.staticfile.org。作者清理全部用户和数据库冗余信息,将JS、CSS、字体改为本地部署,更换新服务器并安装最新Nginx,同时配置EdgeOne缓存规则,对后台、PHP及带Cookie请求禁用缓存。
腾讯 Octop 是开源自托管 AI 助手平台,支持多用户与多 Agent,可接入云端或本地模型,并通过消息通道发起任务。文章对比其与 WorkBuddy 的差异,并沿源码分析 Agent Loop、工具调用、会话状态与权限边界,指出其基于 Deep Agents、LangChain、LangGraph 构建,本地部署需自备模型与运行环境。
JetBrains新报告显示,83.4%的DevOps实践者使用CI/CD流水线;72.8%在本地或自管云运行主系统,30.5%采用本地部署,为五年最高;48.8%的组织在至少一项CI/CD任务中使用AI,但仅8%在构建或测试中直接运行AI步骤;28%通过MCP或智能体技能与CI/CD工具交互;AI多用于代码审查、测试编写和构建故障诊断。
Qwen-Image 2.1 是 2026 年 9 月发布的开放权重图像模型,由文本编码器、7B DiT 和 VAE 三组件接力生成图片,支持文生图、参考图编辑、局部修改和透明背景。在 RTX 3060 6GB 显存加 32GB 内存下,借助 Unsloth Desktop 和模型卸载可运行,但 40 步生成一张图约需 40 分钟。文章还介绍了参数配置、与 GPT Image 2 的对比及商用许可限制。
OmniRoute 是一个本地免费 AI 网关,支持通过 npm 或 Docker 在五分钟内完成部署。它可连接 OpenCode Free、Z.AI、NVIDIA NIM、Mistral 等免费提供商,并配置 Claude Code、Cursor 等工具,支持 19 种路由策略与压缩,每月提供约 1.37B 免费 tokens。
本地运行AI模型可保护隐私并降低成本。本文介绍七款开源ChatGPT替代工具:Open WebUI功能全面,llama.cpp WebUI轻量,LobeHub支持智能体,AnythingLLM擅长文档问答,Jan桌面端易上手,LibreChat功能丰富,Hugging Face Chat UI简洁。用户可自选模型、本地部署,打造符合需求的AI工作空间。
devroute 是一款轻量本地开发调试转发工具,内存占用 3.5MB 起,无界面模式 1.6MB,单文件即拷即用。单端口同时支持 SOCKS5 和 HTTP 代理,可按 Host 加路径前缀转发并重写路径。带原生 GUI,支持规则编辑、实时统计、日志、系统代理联动及中英文主题切换。配置存于 config.toml,改动即时生效,转发失败可返回 503 或回退原地址。
企业因AI与合规需求转向本地部署,但开源可自托管不等于企业级。Supabase、Xata仍需云端控制面或大量运维。pgEdge提供签名二进制、SBOM、FIPS与气隙安装,Control Plane实现高可用,ColdFront以Iceberg分层降低存储成本达90%。
文章提出“无嘴模型”概念:AI判断类任务只需概率分布,无需生成文本。Jev等模型一次前向即输出选项概率,耗时约百毫秒、成本极低,适合分类、路由、告警分诊等场景。作者类比数据库OLTP与OLAP,认为这是AI的OLTP时刻,判断层应进入请求链路,并强调校准与本地部署的重要性。
RunningHub 为 MiniMax H3 开源模型推出 H3 Lightning 加速方案,结合后训练加速模型、SageAttention2、Cache-DiT、torch.compile 及 TP2+Ulysses4 多卡并行,在无 NVLink 的 PCIe 多卡环境下实现约 12 倍提速,5 秒视频生成时间从 348.8 秒降至 28.7 秒,并保留 BF16 精度。该方案已开源,可降低创作者试错成本。
推理软件栈的微小差异(如注意力后端、KV缓存量化、权重量化、张量并行度)会导致本地部署的大模型在长上下文中输出不同token,甚至工具调用失败。实验显示,INT4 KV缓存和NVFP4量化翻转率最高,而BF16和特定INT8方案更稳定。这些数值漂移累积后,模型可能做出致命错误决策,且难以排查。
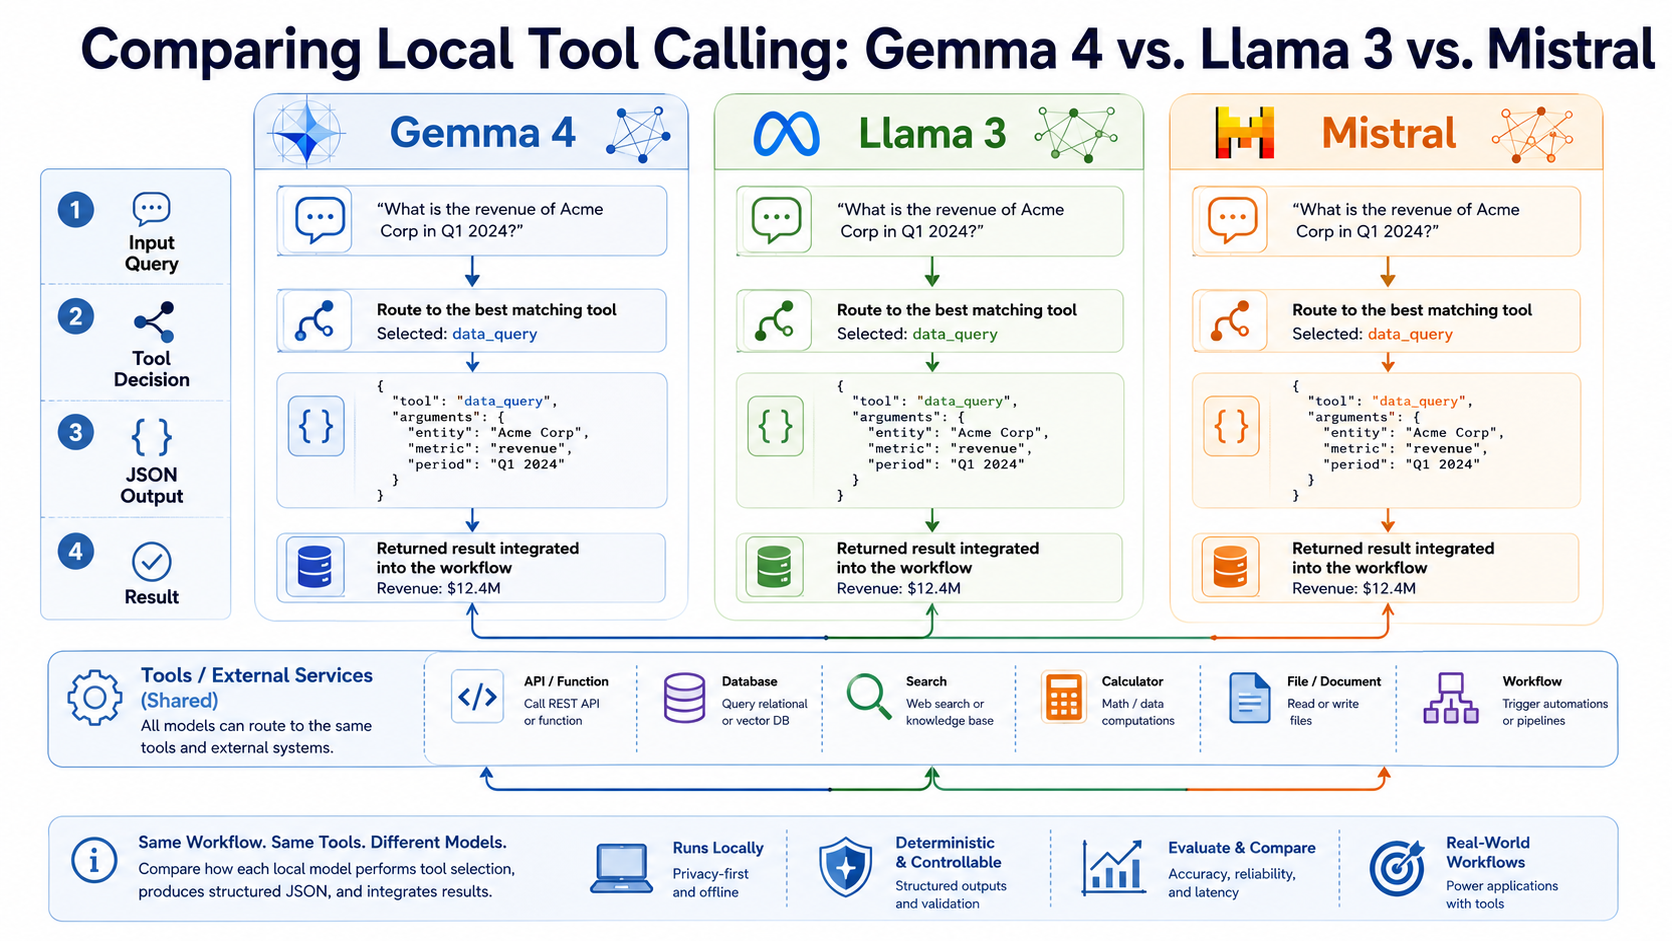
本文比较了Gemma 4、Llama 3和Mistral三种本地部署模型的工具调用功能。Gemma 4原生支持工具调用,适合边缘设备;Llama 3生态丰富,社区支持强;Mistral效率高,适合硬件受限场景。三者均通过JSON格式实现工具调用,但各有优劣,选择取决于硬件和部署需求。
文章介绍了使用两台懒猫AI算力舱本地部署DeepSeek模型的优化过程。通过调整上下文长度至328K、开启思考模式及工具调用功能,提升了模型性能,实现每秒60 tokens的速度,并强调成本极低,每天仅需1.9元,堪称最便宜的DeepSeek方案。
本文介绍如何在普通笔记本电脑上构建无需云端的RAG系统。核心方法包括:量化模型降低内存占用、使用紧凑嵌入模型和本地向量存储。系统涵盖文档分块、嵌入索引、检索和本地生成等步骤。可靠性通过引用来源、相似度阈值、评估集和查询日志实现。推荐使用llama.cpp、LangChain、FAISS等轻量工具,并建议从小规模开始逐步调优。
Siperb 推出本地媒体桥接器,使桌面客户端无需公网或云路由即可连接客户本地 PBX。该组件用 Go 编写,在用户端终结 WebRTC,转为 SIP 明文媒体,避免部署硬件 SBC。首个版本两天内由 AI 辅助开发完成,创始人认为本地部署客户应获针对性服务,而非强制迁移上云。
阿里开源Qwen3.8-27B模型,270亿参数,支持262K上下文,性能接近闭源旗舰。社区实测在双RTX 3090上达105 tok/s,通过量化、MTP加速等技术实现。模型Apache 2.0协议,48小时下载86万次。但速度受场景、配置影响大,多卡未必更快,且长上下文需量化KV缓存牺牲质量。
完成下面两步后,将自动完成登录并继续当前操作。