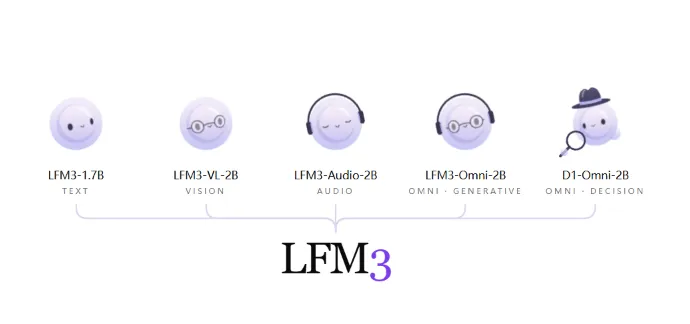
Liquid AI 发布 LFM3 系列,包含 6 个开放权重的 2B 级模型,共享卷积、滑动窗口注意力与全局注意力组成的三混合骨干网络,覆盖文本、视觉、音频、全模态及决策任务。其中 LFM3-1.7B 支持 256K 上下文,4-bit 量化约需 1GB 内存,可在手机和笔记本上运行。该模型在 BFCL V4、WebArena-Verified 等智能体基准上超过 Qwen3.5-9B,但知识与编程能力仍是短板。年营收 1000 万美元以内可免费商用。
谷歌提出Harness²,使Agent能在无标准答案的开放任务中递归地自我改进Harness。该方法采用双层递归:任务级通过“提出—探测—合成”流程,依据同一任务下的行为对照而非真值来判断改动;Harness级将有证据支持的改进存入可复用的改进库。单步改进在4种配置、3个基准上均带来提升,GLM-5在WorkBuddy上平均提升11.5分,弱模型受益更大。消融实验表明改进库、范围划分与合成均有贡献。局限在于行为对照不等于正确性验证,且改进本身存在成本。
Meta 放出 8160 亿参数模型却说“为了安全”! 2026 年 10 月 15 日,Meta 开源了一个叫 Muse Spark Open 的巨型模型。它总共有 8160 亿个参数,但每次干活只激活 420 亿个。这个模型瞄准的是写代码和当 AI 代理干活,能一口气吞下 100 万个 token 的上下文。然而官方同时承认,他们最强的模型 Muse Wonder 并不会开源。 #
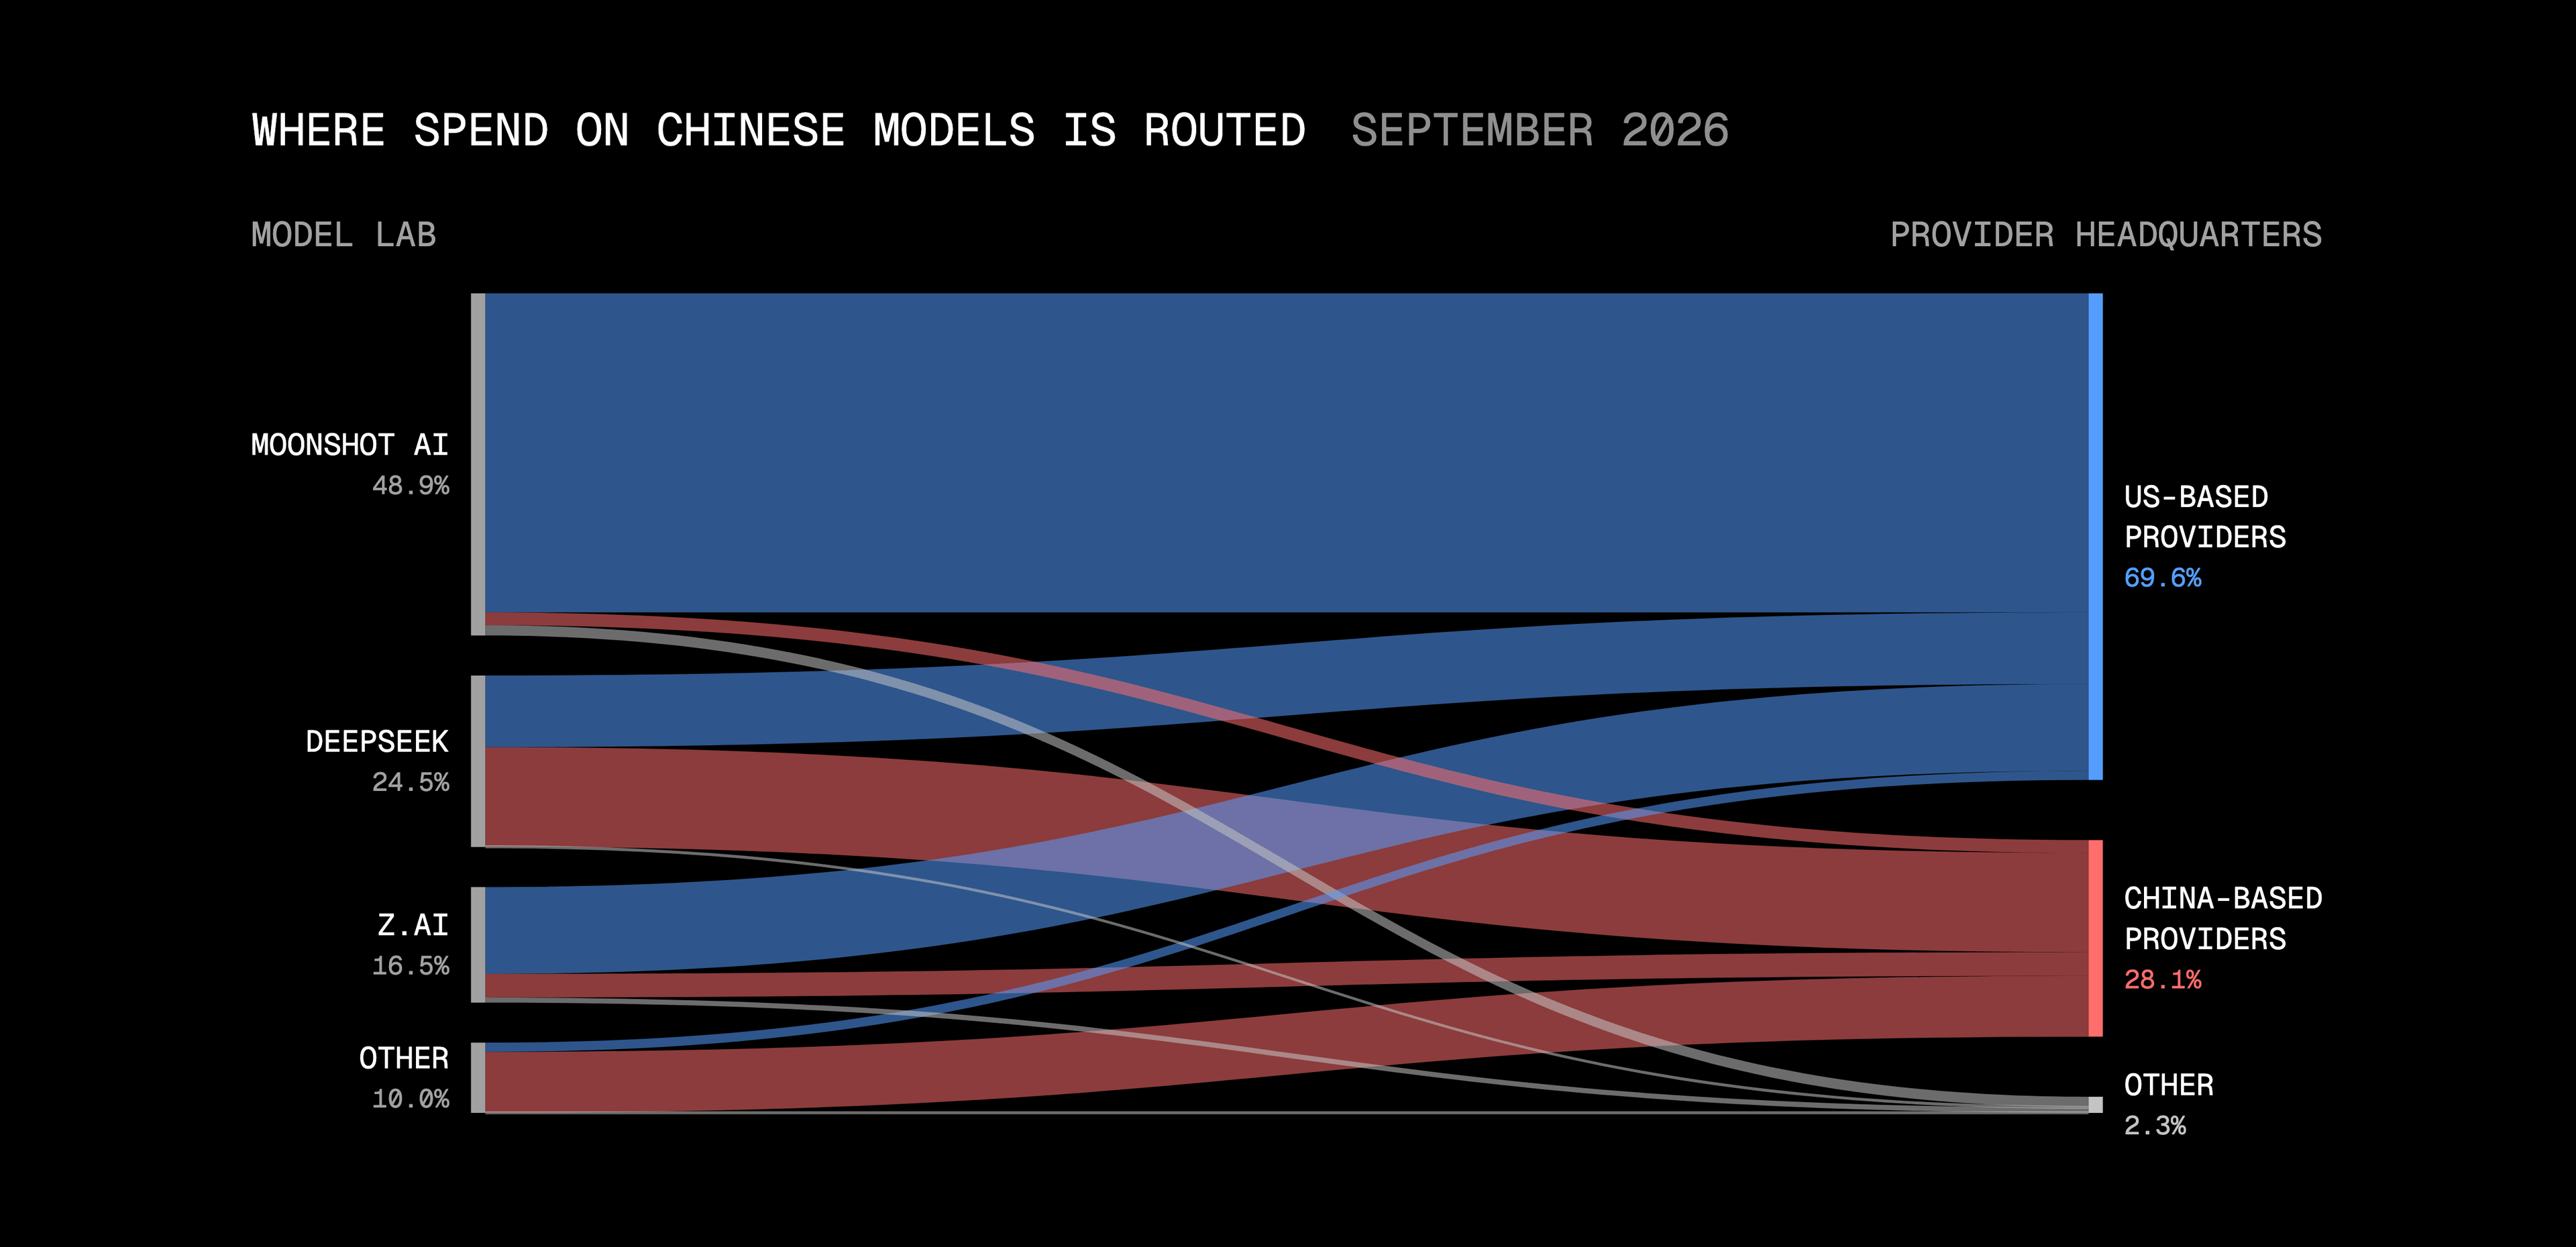
2026年10月AI网关生产指数显示,开放权重模型已占网关token七成以上、支出近四分之一,份额自6月翻两番。9月网关支出约为12月的13倍,单token均价下降47%。近三分之一团队更换主力实验室,创纪录。中国模型支出近七成经美国供应商,较12月不足一成大幅上升。Jev采用最快但支出仅0.27%,Opus 5.5首两周占超一成支出。前沿模型支出增十倍,开放权重增逾七十倍。
Fish Audio 发布文本转语音模型 Drama 3,采用 35B 混合专家架构,每 token 激活约 3B 参数,权重开放。支持 83 种语言、16 个说话人及自然语言表演指令。发音鲁棒性测试得分 93.2%,精确序列为 86.3%。自托管需 48GB 以上 NVIDIA 显存,API 定价每百万字符 50 美元,年营收 50 万美元以下可免费商用。
在布拉格开源峰会上,Percona CEO Peter Farkas 呼吁区分“开放权重”与“开源”:开放权重仅提供模型参数,缺少源代码和训练数据,无法真正使用、研究、修改和共享。斯坦福 HAI 的 James Landay 指出,开放权重只回答“能否运行”,开源则回答“能否信任、改进并在此基础上构建”。小米 MiMo-V2.6 公开强化学习训练过程,DeepSeek 仅发布权重却被广泛称为开源。OSI 2024 年发布首个开源 AI 定义,但争议仍存,现正重新展开讨论。
论坛SEO与博客不同,需通过主题集群积累权重。具体执行包括:内部链接按主题分桶并互链新老帖;用Topic Cluster搭建支柱页与簇页架构;完善结构化数据、分板块Sitemap、静态化等技术基础;引导外链,靠优质帖子吸引引用;用数据监控迭代。核心是激活存量内容,靠时间复利提升权重。
Jev与Laya是两类结构化决策模型:Jev为托管API,Laya为开源权重。JevBench基准中Jev综合分74.4领先,但Laya为零样本测试,且基准由Jev方维护。选型需评估上下文长度、多语言、校准误差、延迟与自托管成本。数据合规场景下,Laya可内网部署,是唯一解。建议按六步评估法实测后决策。
PrismML发布Ternary Bonsai 2 27B三元量化多模态模型,27.36B参数压缩至5.9GB,保留基座98.2%分数。但权重存于旋转基底,运行时需执行Walsh-Hadamard变换,原版llama.cpp与Ollama无法运行。TensorSharp通过显式校验变换契约、转码自定义格式接入该模型,拒绝静默跑错,代价是内存增加6%至29%,性能略慢于官方基线。
NVIDIA在Hugging Face发布开源说话人分离模型Nemotron 3 Diarization,1亿参数,最多追踪8位说话人,支持重叠语音,单检查点兼顾离线与实时流式。采用31层Transformer编码器,输出每位说话人活跃概率,延迟分四档,最低0.32秒。在Voice Arena基准排名第一,DER为14.72%,较前代平均降低41%。权重以OpenMDW 1.1发布,允许商用,经NeMo在NVIDIA GPU运行。
Shopify 的 GraphQL Agent 将生产失败转化为难例,经审查生成成功轨迹,再通过监督微调和强化学习,形成能拒绝坏更新的反馈闭环。系统提示从 6000 Token 压缩到 1500 Gist Token,年化推理成本估算降低 96%。落地应先建质量量表和独立回放集,再挖掘难例,最后微调。
小米发布开源模型MiMo-V2.6,旗舰版为万亿参数,支持百万级上下文与多模态。其亮点是训练透明度:直播五天强化学习过程,公开约350万美元成本,并承诺以MIT许可开源超7000个RL任务环境、训练框架及模型权重。业界认为公开RL环境对推动开源前沿极具价值,也凸显“开放权重”与“开源”的区别。
Vercel数据显示,8月开放权重模型占其AI网关56%的token流量,首次过半,去年12月仅7%;但因价格低廉,仅占支出14%,Anthropic模型仍占支出64%。报告指出,用户忠诚于模型特性而非品牌,新模型无法满足需求时会转向其他厂商。
英特尔研究人员提出BITCOS存储格式,在不改变三元模型的情况下将权重压缩至每权重1.485比特,低于1.58比特的理论下限。该格式分别存储非零权重的位置和符号,利用三元模型中大量零值(占29.7%至51.5%)节省空间,解码吞吐量在CPU上最高提升18%,GPU上最高提升27%。测试仅限英特尔硬件,尚未经同行评审。
2026年9月AI网关生产指数显示,开源权重模型首次占token总量过半(56%),均价较五个月前降逾半,8月再降23.2%。Anthropic的Fable 5支出份额从13.2%跌至4.9%,用户转向半价的Opus 5,Anthropic仍占64%支出。OpenAI新模型Astra上线两天即占其支出三分之一,12天占网关总支出7.7%,超Fable 5.1两倍。谷歌Gemini 3 Flash流失严重,份额从30%降至5%。
Mistral完成3亿欧元D轮融资,估值超210亿欧元,将扩展前沿研究、算力与基础设施。其战略是构建覆盖开源模型、算力、基础设施及产品的全栈,让客户摆脱对单一供应商的依赖,并回应了Anthropic CEO Amodei关于开源权重只是转移算力集中的质疑。
香港城市大学研究发现,Agent评测中的工具调用率受“模型加接口栈”整体影响,接口错配会静默丢弃调用,导致分数失真。实验显示,仅更换接口配置,同一模型分数可从0.00变至0.96。机制上,单独修改模板或解析器无效,需两者匹配。此问题也影响训练信号,但修复接口仅恢复测量,不提升模型能力。
中国AI实验室Z.ai发布旗舰模型GLM-5.3,开放权重但采用限制性许可证,要求年收入超100亿美元的公司托管前需安全审查。模型性能接近美国前沿实验室,但许可证比DeepSeek等更严格,此举或为商业化考虑,因Nvidia和Stripe正收购模型平台,开源模型可能成为带条款的分发渠道。
本文介绍AOTInductor(PyTorch编译器后端)如何将模型权重存储在共享库外,并在推理时线程安全地更新权重。通过设置`package_constants_in_so`为False、`freezing`为False及`always_keep_tensor_constants`为True,权重可外部保存。C++端使用`load_constants`加载权重到非活动缓冲区,再通过`swap_constant_buffer`和`free_inactive_constant_buffer`实现双缓冲安全交换,支持热更新,避免GPU内存峰值。
三篇论文提出Agent自进化新方向:从模型权重转向外部执行框架(Harness)。Recuris通过三层记忆架构和结构化证据实现组件级修补,在τ²-Bench上提升显著;StarHarness用分层搜索优化prompt和工具接口;SkillForge验证技能质量。核心模式是“结构化证据+组件级修补+验证门”,但依赖可验证环境,迁移有条件,归因准确率有限。
完成下面两步后,将自动完成登录并继续当前操作。