PostgreSQL 19 查询优化新特性:新增 pg_plan_advice 扩展,可记录并回放计划器决策以稳定执行计划;pg_stash_advice 支持按查询标识自动应用建议。EXPLAIN 计时改用 TSC 寄存器降低开销。优化器可将非空列的 IS NOT DISTINCT FROM 转为等值连接,NOT IN 子查询在无 NULL 时可用反连接,虚拟生成列可建扩展统计,postgres_fdw 支持导入远程统计,JIT 默认关闭。
ExoBench实测显示,外键数据倾斜(10个大客户占80%订单)导致同一三表连接查询比均匀数据慢约千倍:Postgres从1毫秒升至1572毫秒,SQL Server升至2340毫秒。两引擎均因单列直方图无法识别跨连接相关性而低估约3000倍。修复方式不同:Postgres关闭嵌套循环即可降至约310毫秒;SQL Server需覆盖索引、批处理模式与哈希连接三者叠加才达约330毫秒。
本期介绍EvoOntology自演化本体层,用于连接数据智能体与异构数据源;Python代理轮换指南讲解Requests库的代理认证、轮换与会话管理;开源AI-SQL引擎Quail联合优化查询规划与大模型推理,在29项查询中平均提速1.84倍,KV缓存复用场景最高达14.04倍。
SQL标准不应加入执行提示,因为关系模型要求数据独立性,查询不应暴露索引等存储细节。提示会将存储假设固化进应用,数据变化后反而有害。PostgreSQL长期拒绝提示,最终在查询之外实现计划控制,如pg_plan_advice;更好的做法是用CREATE STATISTICS修正优化器的数据认知,而非指令。
Polars 提速的核心是让计算留在引擎内。三个技巧:用 scan_parquet 替代 read_parquet,让优化器下推过滤和列裁剪,避免中途 collect;用 over() 在单次遍历中完成组内聚合,替代 group_by 加 join;用 when/then/otherwise 替代 map_elements,避免逐值调用 Python。
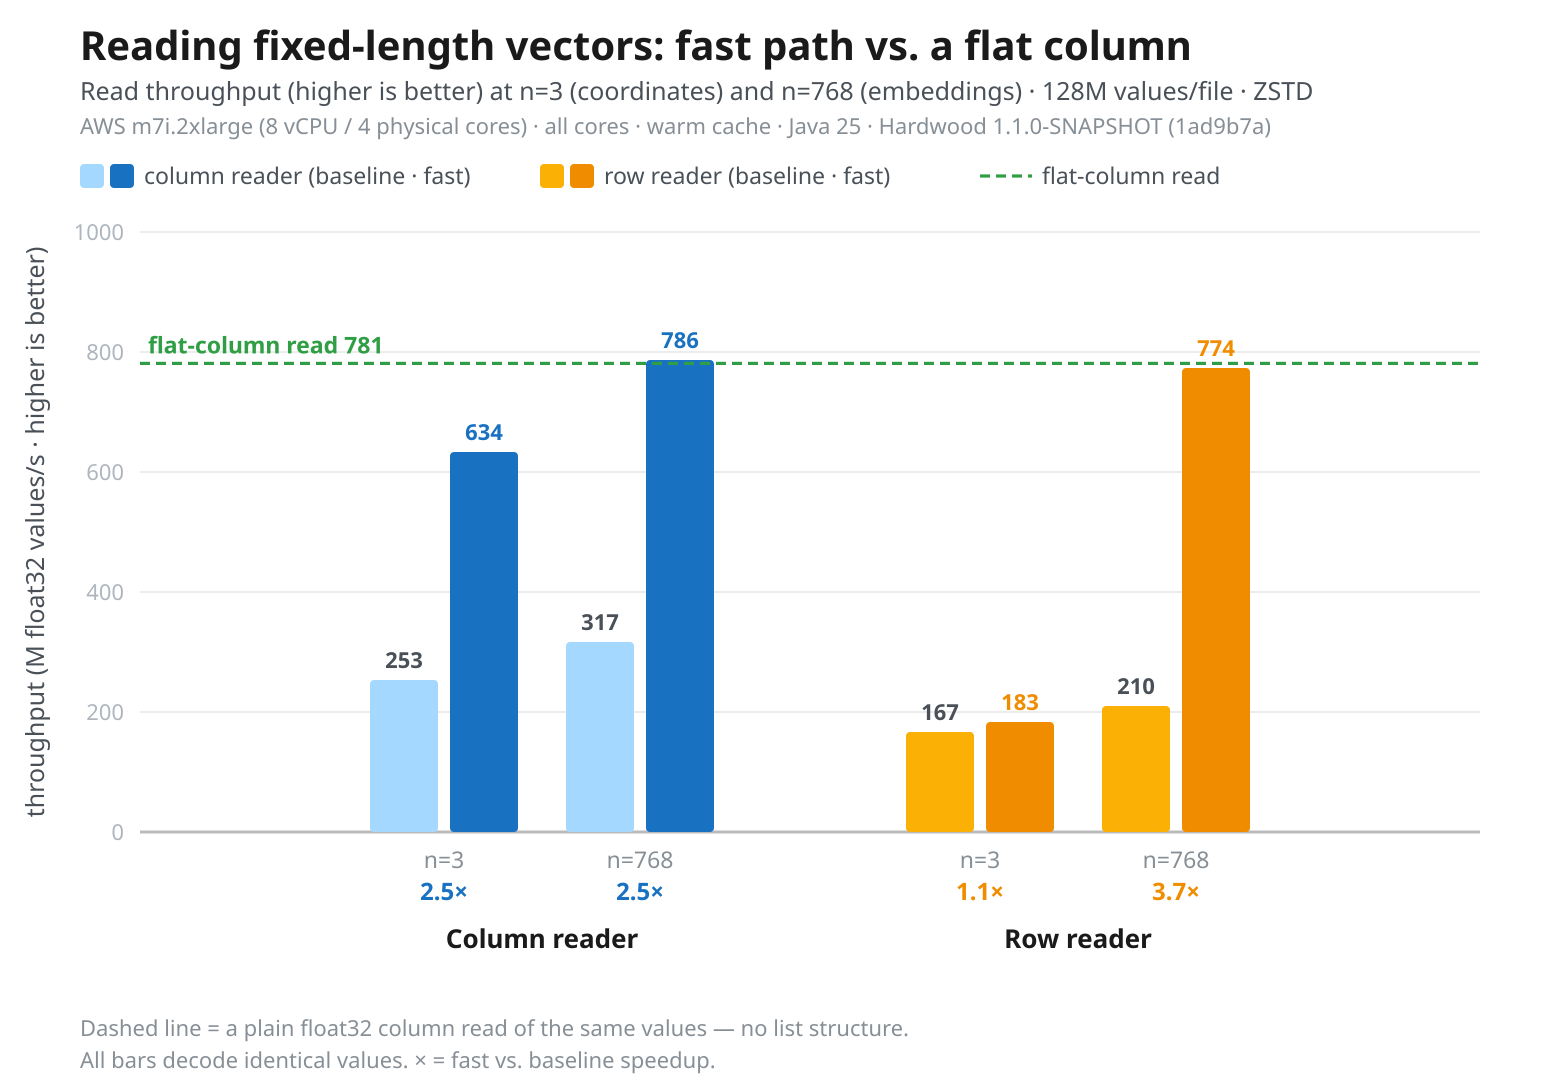
Hardwood 1.1 Beta1发布,首次支持Parquet写入,提供RowWriter和ColumnWriter两种API,并优化查询层(Bloom过滤器、字典行组剪枝)及性能(固定长度列表快速路径等)。CLI改用Æsh框架,启动更快,新增AI代理技能和WebAssembly实验版本。此版本修复109个问题,兼容DuckDB和parquet-java,未来将完善写入功能。
文章讨论PostgreSQL查询优化问题。面对16亿行大表,查询因日期范围条件而变慢,但构建索引耗时过长不可行。解决方案是创建映射表记录每个组合的最小起始日期,通过子查询限制范围,使查询从数秒降至百毫秒内。最终建议使用外部表避免数据冗余,保持性能。
DuckLake是一种基于DuckDB扩展的湖仓格式,将元数据与数据分离:目录(本地文件或PostgreSQL)存储表结构、快照和文件指针,Parquet文件存储实际数据。支持本地运行及PostgreSQL+MinIO生产部署,通过分区将文件组织在S3中。查询时利用目录中的列统计进行分区剪枝和谓词下推,可跳过无关文件,显著提升查询效率。
本文介绍如何用Python和Neo4j构建知识图谱,涵盖建模、数据加载与查询优化。核心在于利用图数据库的索引无关邻接实现高效多跳查询,优于SQL的多次连接。内容包括节点/关系建模原则、UNWIND批量加载、索引与约束设置、查询计划分析,以及结合向量搜索构建AI知识图谱的方法,并附完整可运行脚本。
PostgreSQL默认的random_page_cost=4.0基于2002年机械硬盘假设,在SSD上导致查询计划错误选择全表扫描。将参数设为1.1后,查询从125.98ms降至68.69ms,提升1.83倍;添加覆盖索引可进一步降至41.16ms。建议根据缓存命中率调整此参数,并验证实际效果。
本文介绍Neo4j 5的索引与约束机制。索引分四类:LOOKUP(标签/类型)、RANGE(属性范围)、TEXT(文本子串)、POINT(空间),用于加速查询起点选择,但不解决深度遍历爆炸问题。约束(唯一、存在、类型、KEY)保证完整性,但会带来写放大。过索引增加空间和写入成本,需谨慎设计。
本文介绍图数据库Cypher计划中Expand算子家族:单跳Expand(All)生成邻居、Expand(Into)连接已知两端,变长路径需设上界防爆炸,Pruning优化仅需唯一终点,最短路径用双向BFS而非变长枚举。强调存储耦合、谓词下推及实操要点,如避免超节点扫描、量化路径剪枝等。
本文介绍OLAP查询规划器与优化器的实现,涵盖三个阶段:绑定器解析名称和类型、优化器通过谓词下推、常量折叠和投影下推提升效率、物理规划器将逻辑算子映射为可执行算子。以DuckDB为例,展示逻辑计划树构建及优化过程,最终减少数据处理量,提高查询性能。
本文讨论了Elasticsearch 8.x的查询机制,重点介绍了协调节点在查询过程中的角色,包括查询的分发、归并和获取阶段。查询分为局部查询和全局排序与聚合两个阶段。可选的DFS模式提供全局统计以提高BM25评分的准确性,但会增加延迟。此外,文章还探讨了查询优化和深度分页策略。
文章介绍了Jimmy Angelakos在LinkedIn Live上进行的关于修复PostgreSQL中错误SQL的直播课程。课程基于其书籍《PostgreSQL Mistakes and How to Avoid Them》的第二章,重点讲解常见的SQL反模式及其导致的错误结果和性能问题,并通过实际示例展示如何识别和修复这些问题,以提高查询的安全性和效率。
本文讨论了分布式OLAP查询引擎的写作规划,重点分析Trino、Spark SQL、DuckDB和DataFusion的查询优化与执行框架。系列文章将探讨SQL解析、逻辑优化、执行模型及MPP调度等核心问题,旨在帮助数据工程师理解引擎的内部运作及性能优化。
本文比较了Trino与Spark SQL在数据处理中的差异,分析了两者的查询执行路径、优化机制及Iceberg连接器的能力。Trino采用解释型操作,而Spark通过全阶段代码生成和自适应查询执行来提升性能。文章还对比了两者在Iceberg下推能力,强调了各自的适用场景和优化风格。
在处理时间序列数据时,PostgreSQL使用ORDER BY可能导致查询变慢。通过使用time_bucket和连续聚合,可以将查询时间从4秒缩短至9毫秒。此外,偏斜的分区键可能导致写入瓶颈,需要在架构层面进行诊断和修复。
AI成本上升的原因包括模型价格上涨和上下文管理问题。企业需将知识转化为可用上下文,以降低代理查询成本。通过建立统一的知识层(上下文湖),可减少冗余调用,提高效率。实验表明,优化查询方式能显著降低AI使用成本。
Postgres的pg_stats用于生成统计信息,帮助查询规划器优化执行计划。通过ANALYZE命令更新统计数据,pg_stats提供列的独特值、常见值及其频率等信息。准确的统计数据对查询性能至关重要,错误的统计会导致不佳的执行计划。使用相关统计可以提高多列过滤的准确性。
完成下面两步后,将自动完成登录并继续当前操作。