实测 Supabase RLS 中 auth.uid() 与 (select auth.uid()) 的差异:在百万行表且无索引时,count 查询从 923ms 降至 42ms,原因是包装后只执行一次;有索引时两者均为 0.1–0.3ms。查询自带 user_id 过滤时也很快。建议为策略列建索引,仍用 (select …) 包装 auth.uid() 和 auth.jwt(),并将角色检查改用 to 子句。
作者实测PgLens的179条索引建议,发现18%反而拖慢查询,最差一条估算省91%但实测慢约十倍,原因是规划器低估行数;另有34条因值过长无法建索引。规划器排序尚可,但单条提速估算不可靠。作者因此将数字标为估算,并新增真实建索引计时与超长值警告。
本文是Postgres监控系列终篇,介绍如何查询pg_stat_statements定位问题。故障时应先查pg_stat_activity查看当前活动,而非pg_stat_statements,因为后者只记录已完成查询的累计数据。获取时间窗口有两种方法:间隔取两次快照做差值,或重置指标重新观察。可按总执行时间、调用次数、平均耗时、磁盘读写等维度排序,最慢查询未必是真正问题。建议使用监控工具保存历史趋势。
该文通过MusicBrainz数据集测试,对比SQLx与TeaQL查询性能。直观SQLx全局窗口查询耗时5871毫秒,而先选根对象的两阶段查询仅2.5毫秒,差距达2378倍。TeaQL通过声明业务边界(如根对象数量、关联限制),自动生成优化执行计划,避免处理无关数据。文章强调性能差异源于执行计划的数据量,而非驱动本身,并指出TeaQL优势在于减少手工维护执行细节,确保治理一致性。
Postgres在9表查询中因默认的join_collapse_limit=8,导致执行计划从0.3ms的嵌套循环剧变为467ms的哈希连接,性能下降1500倍。添加5行小表即触发此问题。SQL Server和MySQL无此缺陷。修复方法:设置join_collapse_limit=12,恢复最优计划。建议检查并调整此参数以避免类似性能悬崖。
Databricks推出Variant数据类型正式可用,支持灵活摄取半结构化数据(如JSON、XML),无需牺牲查询性能。通过Predictive Optimization的Shredding技术,自动优化字段存储和统计,读取速度比未分片快4倍,比JSON字符串快30倍。已有5000多团队使用,每月处理超5亿查询,适用于流数据和API数据,未来将扩展更多功能。
PostgreSQL中,小型元数据表的过时统计信息会悄然拖慢大型查询。通过EXPLAIN可识别此问题,无需迁移schema即可修复。文章强调,及时更新统计信息对优化查询性能至关重要。
作者分享了使用SQLite作为Django网站数据库的经验,启用WAL模式和运行ANALYZE显著提高了查询性能。清理数据库时建议分批操作以避免超时。虽然当前Django ORM查询性能尚可,但未来可能考虑使用Postgres。备份方面,作者尝试了restic和Litestream,后者支持增量备份。整体上,作者对SQLite的使用体验积极,期待未来继续学习。
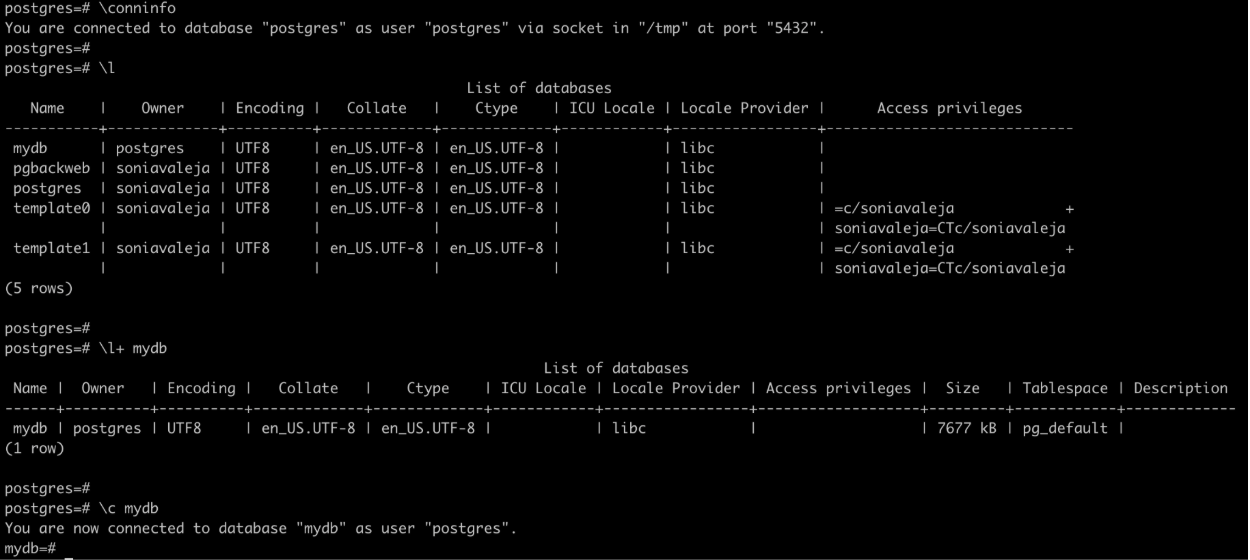
PostgreSQL的元命令是数据库管理员日常管理的重要工具,帮助高效导航和控制数据库会话。常用的元命令如\d系列可用于发现数据库对象和查看元数据,简化重复任务,监控会话,提升查询性能。元命令与SQL相辅相成,前者提供数据库环境的洞察,后者用于数据操作。
本文讨论了Lucene的TieredMergePolicy及其在段合并中的作用。Lucene段文件不可原地更新,删除文档通过liveDocs标记为“死”,物理空间回收需待合并。TieredMergePolicy通过分层合并段,平衡写放大与查询性能。整体上,删除与合并策略影响存储效率与查询性能。
本文介绍了Milvus 2.6.x中Data Node的功能与架构。Data Node负责历史数据的离线处理,包括索引构建和数据压缩。它通过协调组件调度,处理数据加载、索引生成和清理,确保查询节点高效访问数据。文章还讨论了索引构建策略、数据新鲜度及其对查询性能的影响,以及优化资源调度以减少在线查询延迟的方法。
CBO(基于成本的优化器)在OLAP引擎中通过基数估计和代价常量做出决策,影响连接算法和顺序。统计信息对优化至关重要,直接影响查询性能。Trino和DuckDB的统计机制不同,DuckDB通过内置估计提高计划准确性。统计过期会导致错误的连接顺序,因此需定期更新统计信息以优化查询。
本文探讨了分布式OLAP查询引擎Trino和DuckDB如何通过批量处理提升性能,强调向量化执行的重要性,指出逐行处理会浪费CPU资源。文章比较了不同引擎的批处理结构和调度机制,介绍了DuckDB的morsel-driven并行模型及其内存数据布局,并通过实验展示了DuckDB在查询性能上的优势。
本文讨论了Trino的TableScan操作及其在执行中的重要性,重点介绍了通过Connector将逻辑计划转化为物理计划的过程,包括Split管理、列裁剪和谓词下推等优化技术。这些技术旨在提高查询性能,减少不必要的I/O操作,并对比了Trino与PostgreSQL在扫描和优化方面的不同机制。
本文讨论了OLAP查询中Hash Join和Hash Aggregation的执行机制,重点介绍了Trino的内存管理、溢出机制及其对查询性能的影响。Hash Join分为Build和Probe阶段,采用小表广播或分区策略;Hash Aggregation通过Partial和Final阶段进行数据聚合。文章还探讨了内存溢出时的处理策略,并与DuckDB进行了对比实验,强调内存管理在查询优化中的重要性。
本文介绍了Trino的MPP架构,包括Client、Coordinator和Worker三种角色。Coordinator负责解析、调度和汇总输出,Worker执行任务。查询过程分为Query、Stage、Task、Driver和Operator五层,Split由Connector定义并调度。理解Fragment与Stage的关系有助于分析查询性能。
Iceberg通过四层不可变元数据树解决了对象存储中的目录管理问题。这四层分别存储表的状态、快照信息、manifest列表和数据文件,确保原子提交和快照隔离。查询时,Iceberg利用元数据快速定位数据文件,避免了传统方法中的高成本LIST操作,并支持高效的分区裁剪和文件裁剪,提升查询性能。
ClickHouse 的主键是稀疏排序索引,结合二级跳数索引实现 granule 剪枝。主键需为 ORDER BY 前缀,合理选择排序键可优化索引体积和查询性能。跳数索引类型包括 minmax、set 和 bloom_filter,适用于不同查询场景。设计时应考虑高基数列的索引策略,以提升查询效率。
pg_stat_statements是PostgreSQL的扩展,用于监控数据库查询性能。它通过哈希表记录查询的执行次数和总时间,但不保存具体查询文本。查询ID在不同版本间不稳定,且相同查询可能因结构不同而被视为不同。ORM的使用可能导致查询形状的多样性,影响性能监控。该扩展无法提供历史数据或详细执行记录,平均执行时间可能掩盖性能问题。
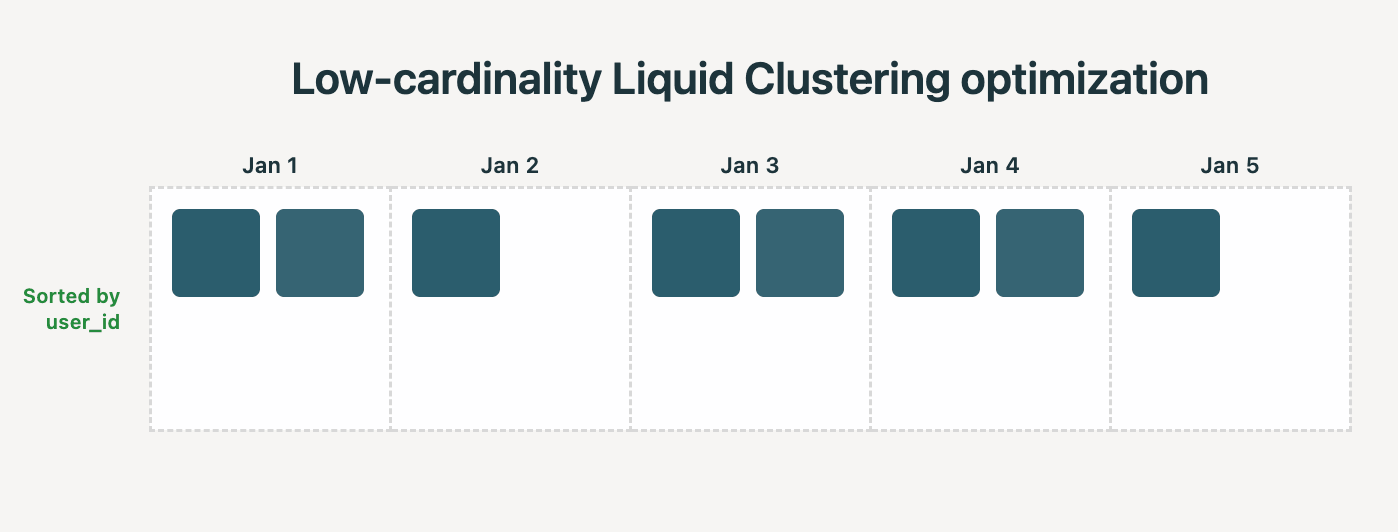
液态聚类是现代湖仓的数据布局标准,解决了传统分区的小文件和过度分区问题。它支持动态调整聚类键和行级并发,优化查询性能。与分区相比,液态聚类在处理高基数列时表现更佳,并支持元数据操作。案例分析表明,液态聚类显著提高了数据处理效率,减少了存储空间。
完成下面两步后,将自动完成登录并继续当前操作。