Visual Studio 2026 18.11 版新增键盘操作标签页功能:Ctrl+Shift+PgUp/PgDn 可将当前标签左移或右移一位,支持垂直标签和工具窗口,并遵循固定标签、项目分组等既有布局规则;Ctrl+数字小键盘 1 至 9 可按视觉顺序直接激活对应标签,切换文档组后顺序随之更新。工具窗口标签改为独立宽度并统一为 24 像素高度,用户可在键盘设置中自定义快捷键。
ChatGPT的Chrome扩展升级,可读取用户已打开的标签页,支持跨标签比较、填表、整理信息等操作。侧边栏集成完整ChatGPT及对话历史,ChatGPT Work还能控制标签页,执行发消息、填表、下载文件等任务,类似谷歌Gemini的自动浏览功能。
YouTube为AI生成音乐添加“Made with AI”标签,率先在YouTube Music上线,后扩展至主应用。该标签适用于主要用生成式AI创作或修改的曲目,如用生成模型制作作曲和人声。未主动披露者,平台可能依据其他信号判定。Spotify、Apple Music等也推出类似标注,Deezer支持过滤,Bandcamp则直接禁止AI音乐。
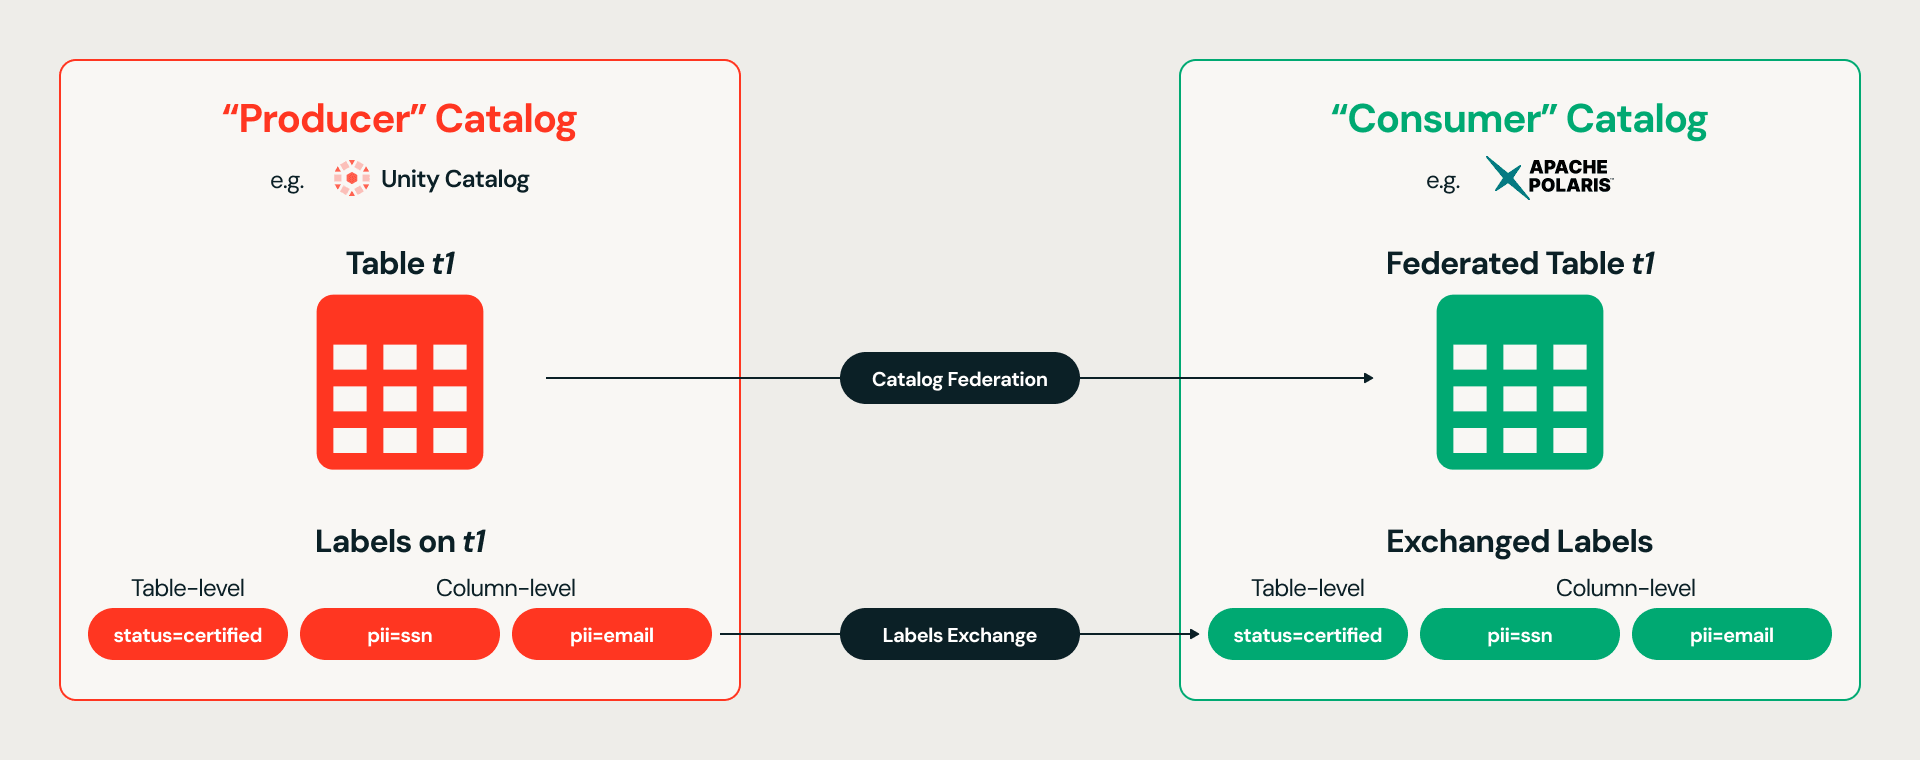
Apache Iceberg社区新增读取限制和目录标签两项REST目录规范。读取限制支持目录向受信任引擎下发过滤和掩码,适用于引擎直连目录;目录标签通过键值元数据在异构目录间传递治理信息,由消费方本地执行,适用于目录联邦。两者与集中式执行共同实现跨引擎、跨目录的统一治理。
Firefox 157 正式向桌面和移动端推送全新设计,采用圆角标签页、圆润地址栏及新配色、图标和主题,两端设计语言统一且不影响性能。此次改版增加更多主题和壁纸选择,并恢复 Compact Mode,可缩小标签和工具栏,为网页留出更多空间。
谷歌为Chrome推出新功能:跨设备标签页切换可记忆滚动位置和未填表单,方便继续阅读或填写。Chrome中的Gemini扩展支持分析播客、非YouTube视频等更多媒体,提取要点并答疑,还能根据当前网页生成互动测验。测验功能先在美国和印度桌面端英文版推出,未来数月扩展至其他地区和移动端。
半监督联邦ASR因伪标签误差累积易发散。关键在教师与锚点耦合设计:每客户端在线教师稳定后可媲美或超越全局教师,种子增强后过渡教师更优;服务器需在轮次间持续用标注数据训练以稳定在线教师。该方案在11组中9组超越先前最佳,域内平均提升20.8%,跨域10.0%。
Go提案#75047拟为每个测试的goroutine自动添加test和test_iter标签,便于CI超时排查时定位卡死goroutine所属测试。配套CL已实现标签注入与崩溃回溯显示。社区正讨论标签命名、分隔符及迭代号显示方式,评审委员会认可方向,细节仍在打磨。
本文是iOS NFC开发实战手册,基于TapCard项目。NFC标签可用容量仅约137字节,无模拟器,必须真机测试;需付费开发者账号、App ID、entitlement和描述文件,配置错误只报签名错误。作者手写NDEF解码器,因流行库会丢弃语言代码、截断emoji。写入需先查询容量再写并回读验证。还介绍焦点计时器、标签永久锁定、自建Swift原生模块、删除依赖并保留证据,以及EAS构建对比和Android预览。
Anamanaguchi 乐队在《The Verge》问卷采访中分享创作工具与网络生活,推荐 Ableton、罗技鼠标和节拍器,提到浏览器标签过多,并谈论社交媒体、游戏和 AI 音乐。他们最自豪 2025 年专辑《Anyway》,新单曲《Yeah I Guess》延续其风格。
本文介绍如何在Kubernetes中通过NetworkPolicies实现零信任网络模型。实验使用Calico CNI,在命名空间内设置默认拒绝规则,再基于标签允许特定流量:前端访问后端80端口,后端访问数据库5432端口,并配置出站策略及DNS例外。验证表明,标签是身份标识,通信需源端出站和目标端入站规则同时匹配,且需注意端口限制和CoreDNS访问。
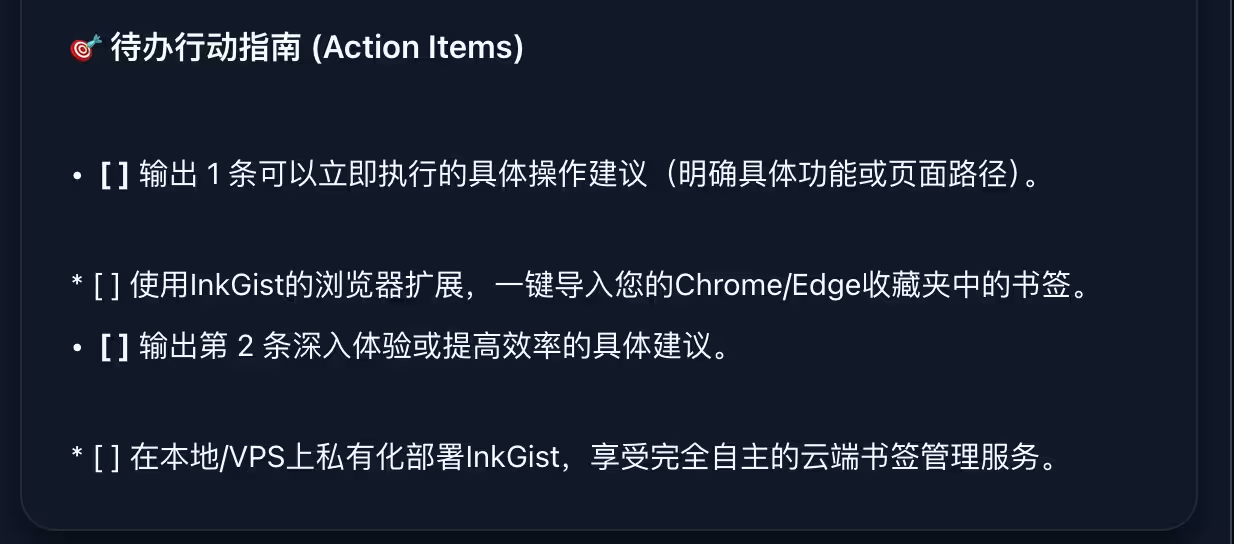
墨萃(InkGist)是一款AI网页速读与云端书签工具,能将链接自动总结为知识卡片,包含核心说明和待办建议,并保存至书签页面。支持批量导出至HTML、Markdown或同步到Karakeep,帮助用户高效处理大量标签页,减少焦虑。
本文介绍Rust社区多个项目:Plush解释器用64位标签值替换枚举,提速17%;PhastFT纯安全Rust实现高性能FFT,比RustFFT快2倍;PumpkinMC纯Rust Minecraft服务端开放Beta;ModuRL基于Candle的深度强化学习框架,支持多种算法。
2026年AI内容溯源与水印专利增多,EU AI Act要求AI生成内容具备机器可读标记。现有标签易被移除,专利转向全链路凭证,如C2PA元数据和多频段水印。落地机会包括批量合规打标SaaS和署名归属报告,面向MCN和企业,成本低,但需深化合规证明。
本文首次将迭代伪标签训练法应用于中英混合语音识别(CS-ASR),利用未标注数据提升性能。方法分三阶段:生成伪标签、两阶段双语模型训练及迭代优化。在SEAME数据集上,devman和devsge子集词错误率分别降低6.35%和8.29%,显著提升复杂混合场景识别精度。
本文介绍Cilium v1.20中Endpoint与Identity机制:Endpoint是节点上共享IP的网络实体,Identity是由安全相关标签导出的集群范围数字键,用于策略匹配。标签变更会触发身份重解析,产生init拒绝、新身份拒绝、旧身份放行三类短暂窗口。排障时应区分窗口类型,而非简单归咎于策略错误或系统不稳定。
当代哲学缺乏统一时代标签,分析哲学与大陆哲学分裂百年,语言不通、互不理解。虽有跨界尝试,但整体碎片化严重。命名努力如“新实用主义”等均失败,反映学科处于旧范式消亡、新范式未生的空隙期。态度转变但行为未变,哲学界仍困于传统壁垒。
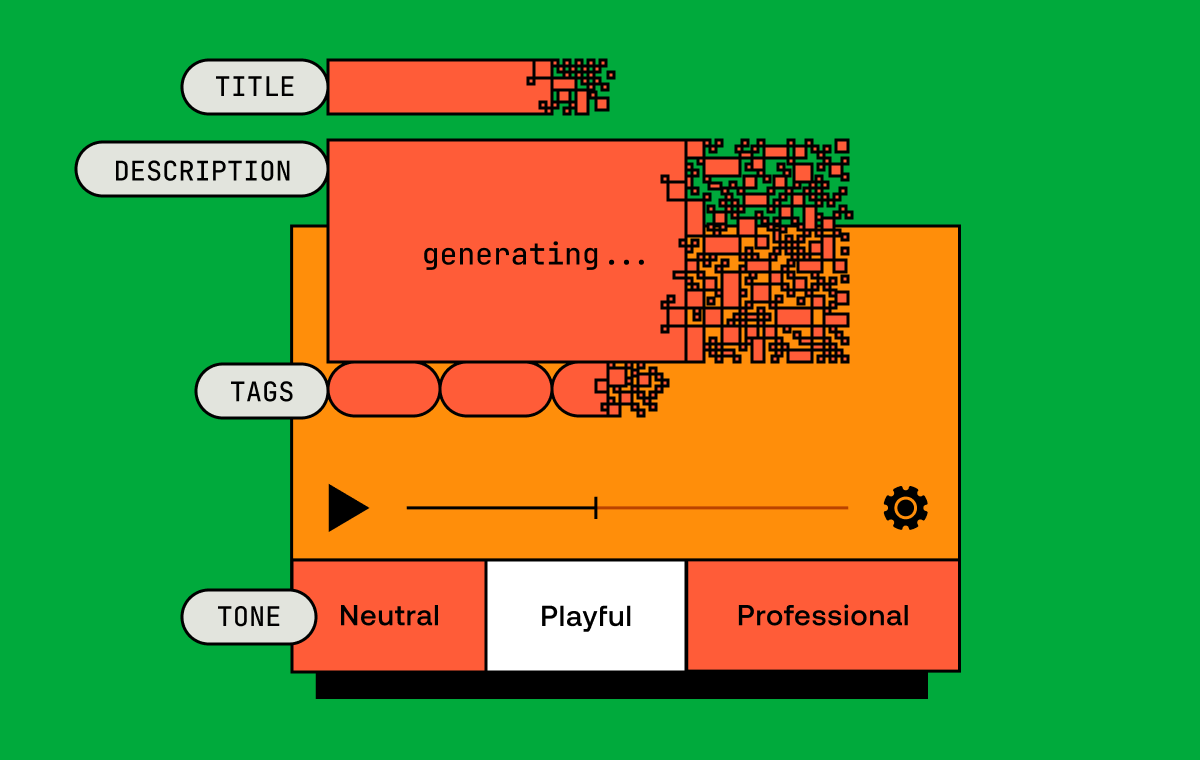
本文介绍如何通过Mux Robots Summarize工作流,为视频生成高质量标题、描述和标签。核心是设置基调(中性、俏皮或专业),调整基本参数(标题长度、标签数等),并利用输出导向选项(如摘要风格、受众、品牌术语和标签分类法)定制内容。以NASA视频为例,展示默认输出与定制输出的差异,后者标签更精准、无拼写错误且贴合受众。最后建议用编码代理快速迭代优化参数。
本文介绍Neo4j 5的索引与约束机制。索引分四类:LOOKUP(标签/类型)、RANGE(属性范围)、TEXT(文本子串)、POINT(空间),用于加速查询起点选择,但不解决深度遍历爆炸问题。约束(唯一、存在、类型、KEY)保证完整性,但会带来写放大。过索引增加空间和写入成本,需谨慎设计。
本文介绍Databricks dbt Query Tags功能,通过一行配置或Genie自动为每个模型注入标签(如模型名、团队、成本中心),记录在system.query.history中,实现成本归因、性能调试和监控。参考项目展示如何用SQL或Genie构建仪表板,识别高计算模型(如四个mart表占92%时间),并支持指标视图标签,帮助团队优化FinOps实践。
完成下面两步后,将自动完成登录并继续当前操作。