


在大规模AI训练中,GPU利用率取决于“好吞吐”,即有效计算时间占比。数据加载和检查点机制是关键:频繁异步保存检查点(如每30分钟)可减少故障恢复成本,提升好吞吐至91%;数据管道需重叠预取和本地缓存,避免GPU空闲。同时,检查点需包含数据位置和随机数状态,确保恢复后训练正确。
本文讨论了PostgreSQL中checkpoint_timeout设置对高可用性的影响,指出即使有HA副本,若主库重启耗时过长,副本也可能面临同样问题,因此建议保持默认值以确保稳健性。随后介绍了Postgres排序规则更新项目,包括使用Docker和GitHub Actions进行测试,并提及使用OpenAI Codex的Luna模型以低成本高效完成项目,展示了其性价比。
本文介绍MongoDB手册中WiredTiger存储引擎的运维参数映射:缓存大小、约60秒检查点、日志与历史窗口等旋钮对应内核机制;列出数据目录关键文件(.wt、WiredTigerHS.wt、日志等);明确不展开复制集、分片等边界;强调调参前需回看机制篇,避免误操作。
Postgres 19引入了CHECKPOINT命令的新功能,DBA可以选择FAST和SPREAD两种模式来优化写入性能。FAST模式快速完成检查点,而SPREAD模式则平滑写入,减少对存储的冲击。此外,新增的FLUSH_UNLOGGED选项允许手动刷新未记录表的数据。这些改进提升了CHECKPOINT的灵活性,以满足不同的数据库管理需求。
数据库的检查点是核心功能,负责将脏页写入磁盘。检查点滞后可能导致数据库无法恢复。文章回顾了两个事件,强调在检查点问题时重启数据库的风险。健康系统的检查点快速完成,而不健康系统在负载过重时可能延迟至一小时。应避免在检查点滞后时重启数据库。
本文讨论了AI代理在数据库创建和使用中的作用,指出它们在基础设施清理方面的不足。介绍了数据库分支、零扩展和集中访问控制如何帮助团队适应代理驱动的发展。Databricks Lakebase是一个兼容Postgres的操作数据库,具有快速分支和计算存储分离的特点。
文章讨论了PostgreSQL中的两个检查点参数:checkpoint_flush_after和checkpoint_warning。checkpoint_flush_after控制写回操作,默认值为256kB,建议在Linux上保持不变。checkpoint_warning是日志参数,用于警告检查点过于频繁,默认值为30秒,建议在出现警告时增加max_wal_size。
本文讨论了PostgreSQL中的两个重要检查点参数:checkpoint_timeout和checkpoint_completion_target。检查点是确保脏页写入磁盘的时刻,影响崩溃恢复时间。建议将checkpoint_timeout设置为至少15分钟,以减少写放大和I/O负担,同时将checkpoint_completion_target设置为0.9,以平滑I/O负载。合理配置可提高系统性能和稳定性。
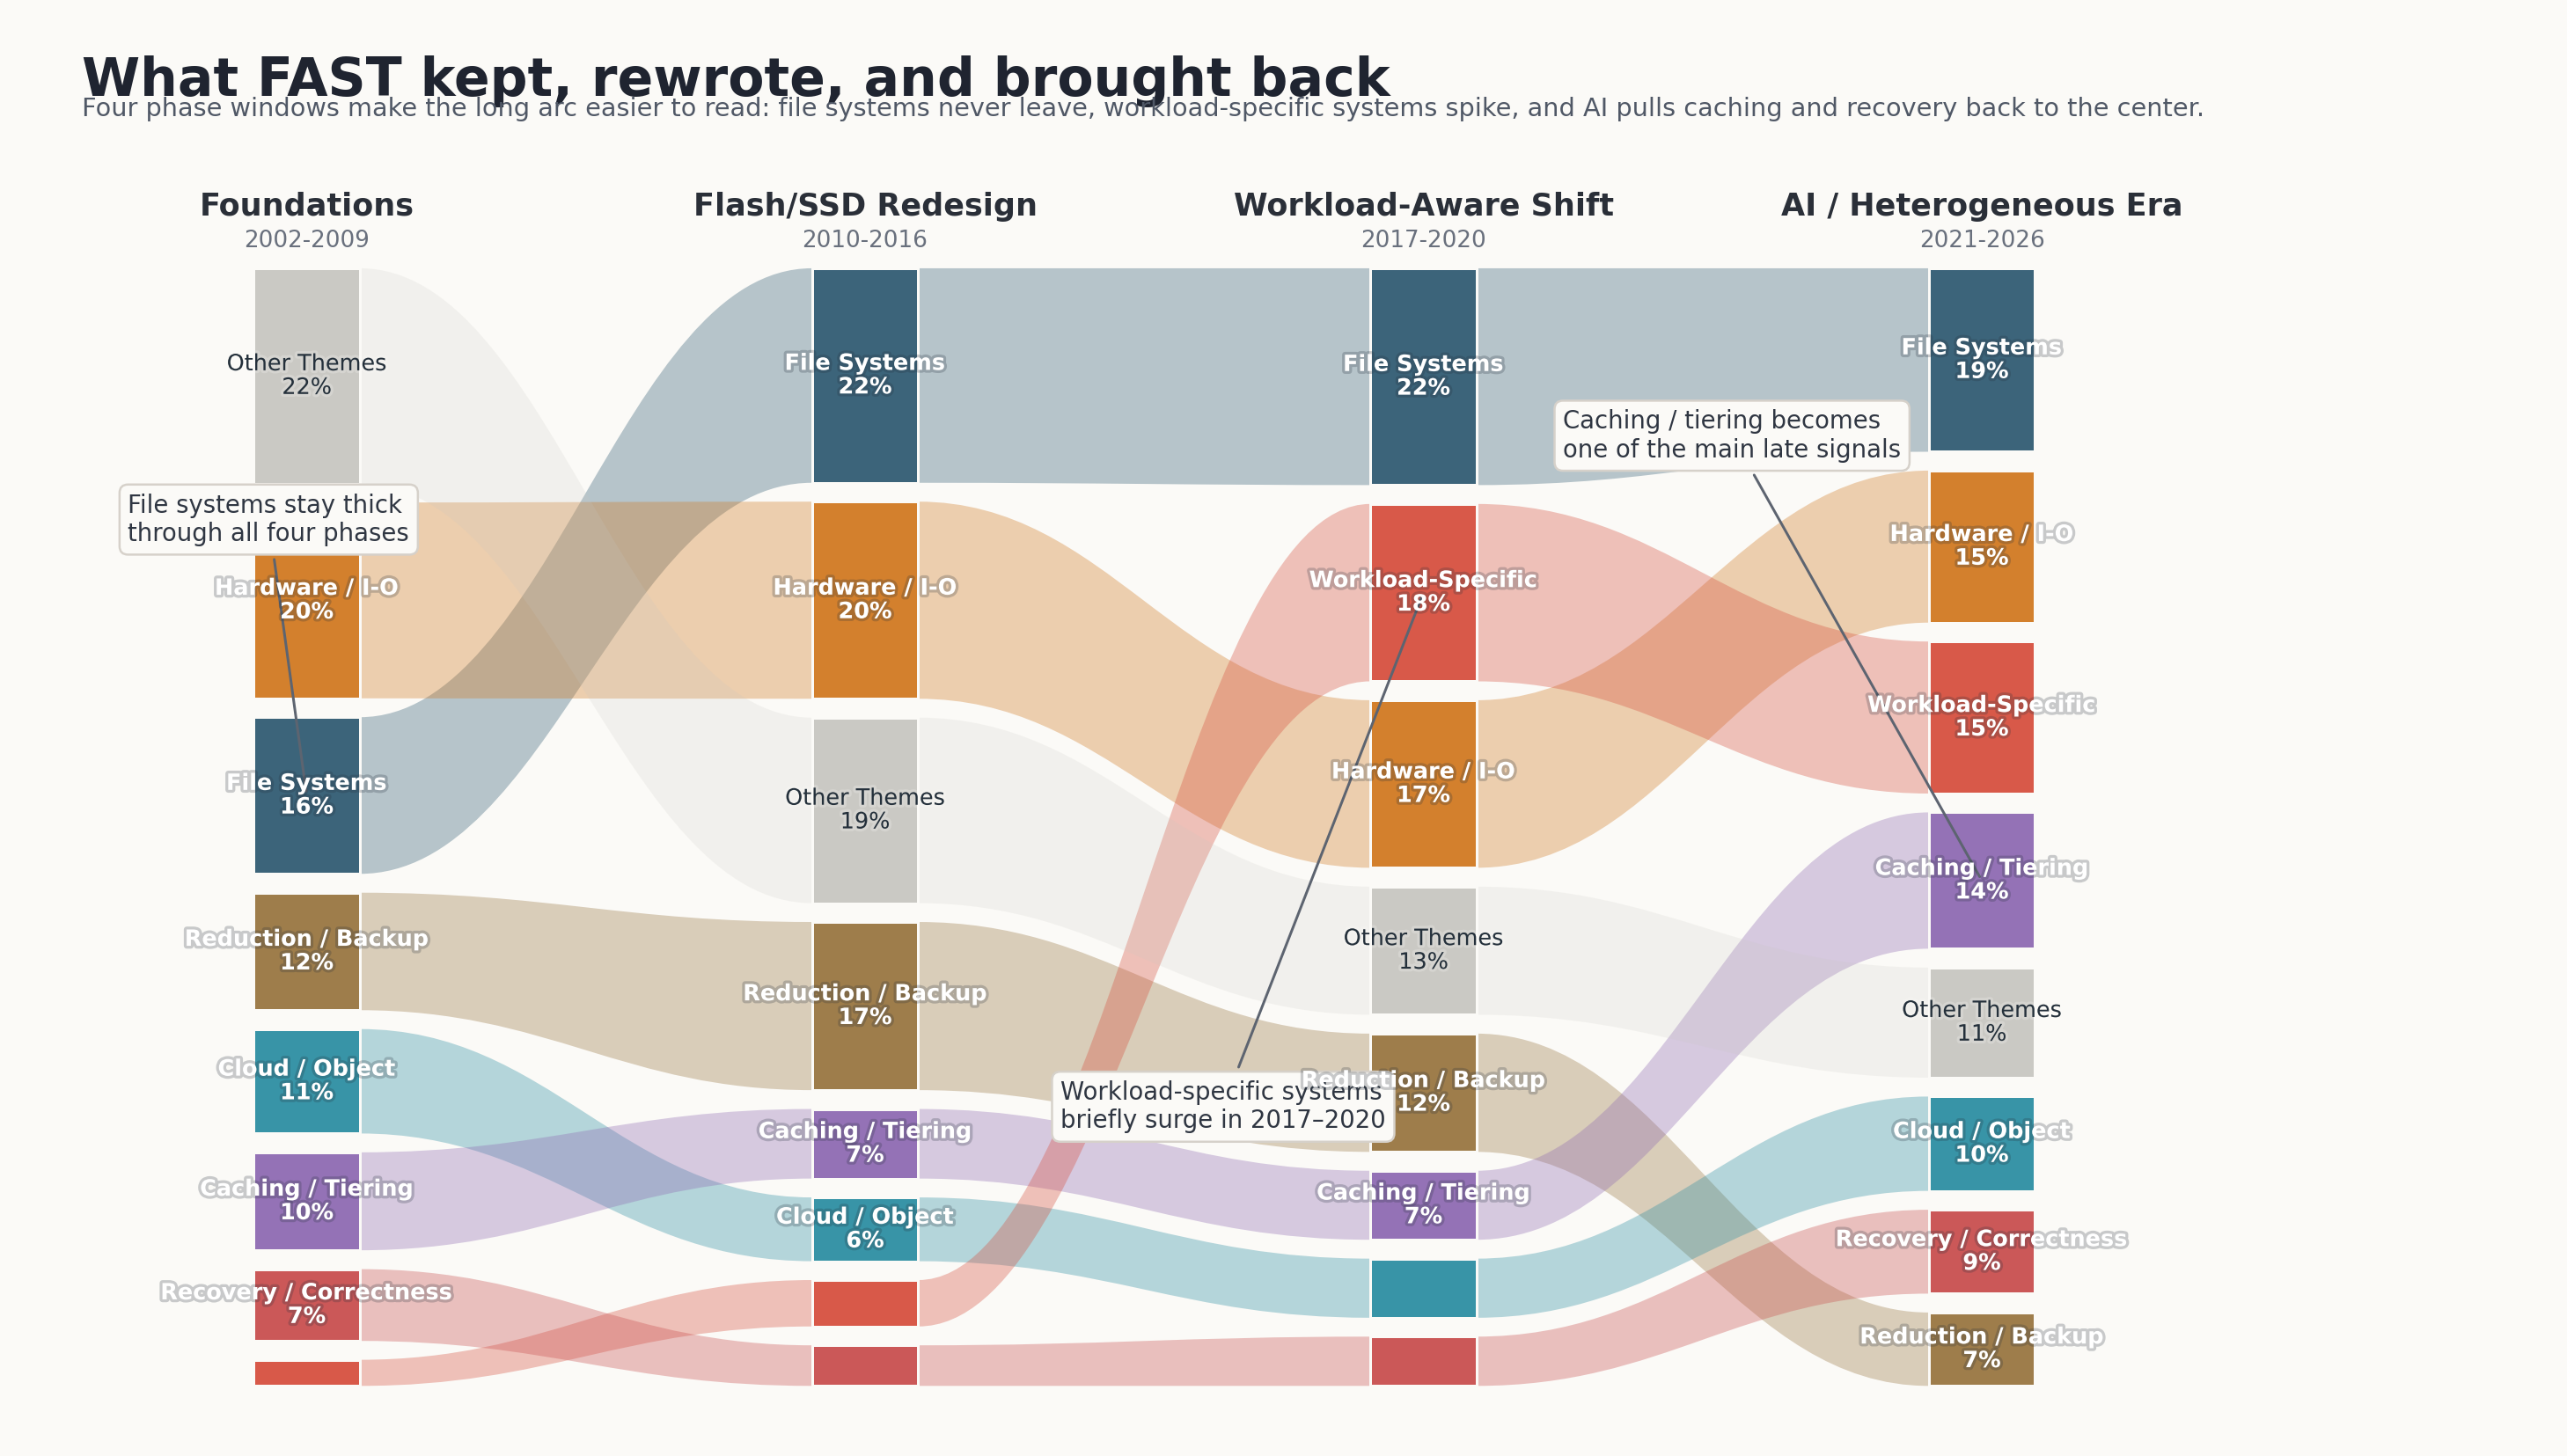
本文回顾了存储系统研究的演变,强调在AI时代,传统存储问题如缓存、恢复和文件系统重新受到关注。通过分析FAST会议的论文,发现AI并未取代旧问题,而是促使其以新形式回归。研究显示,KV缓存、模型加载和检查点等主题在存储系统中变得更加重要,反映出存储研究的主线逐渐转向服务和数据路径的协同。
Postgres通过预写日志(WAL)解决内存与磁盘的矛盾。检查点是将脏页写入磁盘的过程,处理不当会影响性能。合理设置max_wal_size可以减少强制检查点,从而提升系统性能。监控检查点活动是优化数据库的重要步骤。
检查点调优在许多博客中被讨论,但常常被忽视,导致服务器资源浪费和性能问题。检查点是PostgreSQL确保数据一致性的时间点,合理调节检查点间隔可减少WAL生成,提高性能并降低I/O负担,用户通常可获得约10%的性能提升。
检查点调优对PostgreSQL性能至关重要。合理配置检查点间隔可减少WAL生成,提升性能,避免频繁检查点导致的I/O高峰,从而提高系统效率,减轻备份和存储负担。
Kubernetes成立了Checkpoint/Restore工作组,旨在将检查点/恢复功能集成到Kubernetes中,以优化资源利用、加速应用启动、实现容错、支持负载均衡和安全事件调查。该工作组将促进Kubernetes社区与CRIU生态系统的合作与讨论。
训练语言模型需要大量内存,尤其是处理长序列数据。本文介绍了在内存受限环境中训练模型的技术,包括低精度浮点数、混合精度训练和梯度检查点,这些方法能有效节省内存并提升训练效率。
本文介绍了MoE-PHDS(后hoc声明稀疏性),一种轻量级的SFT方法,允许在推理时灵活调整稀疏性,而无需更换模型或架构。PHDS通过在不同稀疏水平上训练,提高了模型的准确性和延迟可预测性,简化了MoE的部署,并提升了跨稀疏性的一致性。实验结果显示,PHDS在多个操作点上优于传统模型。
Amazon SageMaker HyperPod 推出了无检查点训练和弹性训练功能,前者减少恢复时间,提高模型开发效率;后者自动调整资源使用,最大化集群利用率。这些技术帮助团队专注于模型性能,缩短训练时间。
PostgreSQL中的“脏页”是指内存中已修改但尚未写入磁盘的数据页。它们会影响性能,尤其在检查点期间可能导致I/O峰值。通过调整共享缓冲区、后台写入器和检查点参数,可以优化脏页处理,减少查询延迟,确保数据持久性。
LangGraph Redis 0.1.0版本进行了全面重构,优化了检查点数据存储,性能显著提升。通过去规范化存储、使用有序集合和批处理管道,获取检查点速度提升12.4倍,列表检查点速度提升31.6倍。新版本不兼容旧版本,专注于新部署的性能优化。
Apache Flink是一个分布式流处理框架,利用检查点机制实现容错。它定期保存应用状态,确保在故障时可恢复。Flink通过障碍记录对齐操作符状态,并管理状态后端。在故障发生时,Flink从最后一个完成的检查点重启作业,确保数据不丢失。
GitHub Copilot Edits在Visual Studio 2022中提升了代码迭代效率,用户可查看受影响文件和建议更改,直接比较代码差异,并使用检查点回顾早期版本。该功能适用于Visual Studio 2022的17.13 Preview 3及以上版本。
完成下面两步后,将自动完成登录并继续当前操作。