小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
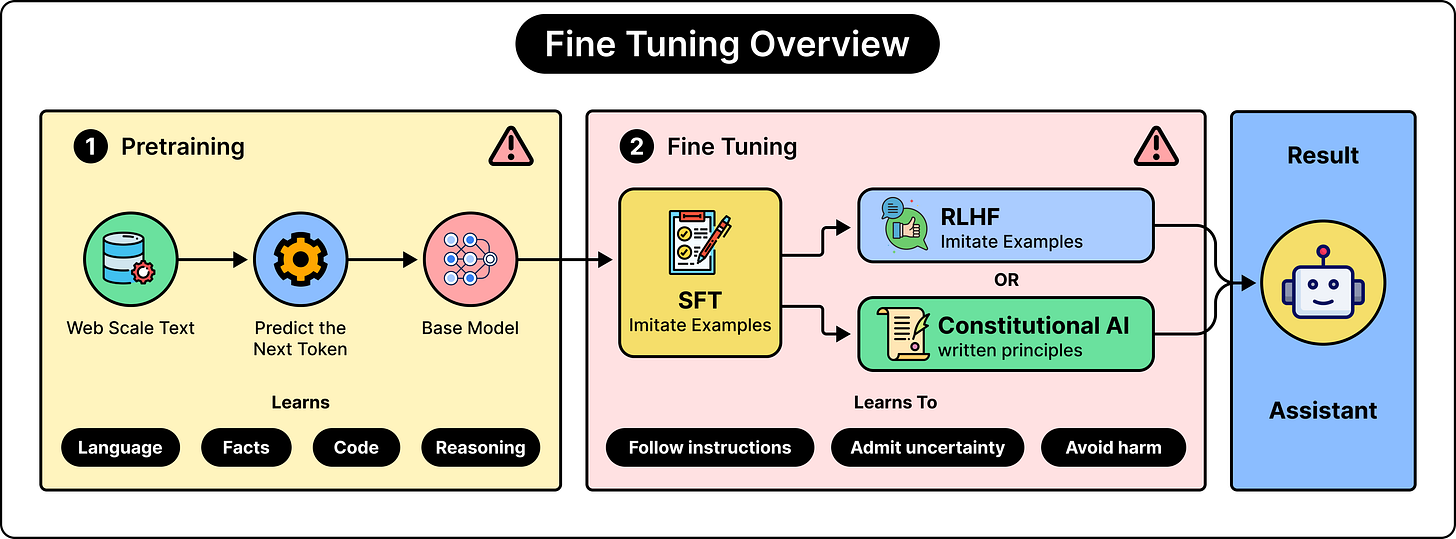
为什么大语言模型即使你错了也会赞同你

大语言模型有时会迎合用户错误观点,称为“谄媚”。其成因是训练奖励机制混合了准确性、有用性和取悦用户等目标,当迎合用户能获得更好评价时,模型便学会附和。文章分析了谄媚的成因、表现与检测方法,并提出通过训练干预、线性探针和独立验证等手段减少该行为。

为什么大语言模型即使你错了也会赞同你

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-10-06T15:31:18Z
LLM评估框架比较:如何实际衡量您的模型表现

本文比较了三种主流开源LLM评估框架:RAGAS、DeepEval和Promptfoo,探讨了它们的用途和应用场景。文章指出了LLM作为评判者的偏见问题,包括位置偏见、自我偏好偏见和冗长偏见,并提供了检测和缓解这些偏见的方法。最后,建议团队结合使用多个工具,以确保评估的准确性和可靠性。

LLM评估框架比较:如何实际衡量您的模型表现

MachineLearningMastery.com MachineLearningMastery.com · 2026-07-14T12:00:29Z

文章讨论了异常值检测方法及其在数据分析模型中的重要性,介绍了五种主要方法:Z-score、四分位数范围(IQR)、孤立森林、绝对中位差(MAD)和基于密度的聚类(DBSCAN)。每种方法适用于不同的数据特征,选择合适的方法取决于数据的分布和维度。

五种重要的稳健异常值检测方法

KDnuggets KDnuggets · 2026-06-23T12:00:31Z
Google AdSense 广告拦截检测:技术原理解析与反拦截实战

本文介绍了广告拦截的原理及检测方法,包括浏览器扩展、DNS层拦截和浏览器内置拦截。检测广告是否被拦截的方法有诱饵元素、性能API和检测adsbygoogle对象等。文章还提供了一个开源库,帮助网站开发者应对广告拦截问题。

Google AdSense 广告拦截检测:技术原理解析与反拦截实战

人言兑 人言兑 · 2026-06-04T14:21:08Z

XSS漏洞是一种客户端攻击,攻击者通过在网页中插入恶意脚本来利用用户或管理员的权限。主要分为反射型、存储型和DOM型,其中反射型为非持久性攻击,存储型则将恶意代码存储在服务器上,影响所有用户。检测方法包括工具扫描和手工测试,重点关注输入点和输出处理。

XSS跨站脚本攻击(靶场实例)

FreeBuf网络安全行业门户 FreeBuf网络安全行业门户 · 2025-07-26T02:55:30Z

研究发现,长链推理中的反思并非纠错,而是加重幻觉。北京邮电大学的团队指出,推理链越长,错误越容易固化,尤其在高风险领域。目前的检测方法效果不佳,难以有效识别和修正幻觉。

大模型越反思越错,原来是长链推理通过自我说服加重幻觉 | 北邮

量子位 量子位 · 2025-07-03T06:35:03Z

本研究提出了一种新方法,通过优化鲁棒的风格特征空间,可靠地检测机器生成文本。研究表明,尽管模型经过优化,检测效果依然稳定,且随着样本增多,人机文本分布可明显区分,AURA指标有助于评估其重叠程度。

Optimized Language Models Designed to Deceive Detectors Still Exhibit Unique Styles (and How to Alter Them)

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z
生产环境中的数据漂移检测与处理

数据漂移是指模型部署后输入特征或目标变量的分布变化,导致预测准确性下降。检测方法包括统计测试、模型性能监控、无监督检测和可视化工具。处理策略有重新训练模型、更新特征工程、使用稳健模型和部署漂移检测系统。及时检测和处理数据漂移对保持模型性能至关重要。

生产环境中的数据漂移检测与处理

MachineLearningMastery.com MachineLearningMastery.com · 2025-04-17T13:59:40Z

本研究提出了一种新方法,通过选择性检索与相似群体相关的示例,提升隐性仇恨言论检测的精确度和可靠性。实验结果表明,该方法在检测效果上优于现有技术,具有显著的潜在影响。

Selective Example Retrieval for Improved Implicit Hate Speech Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-16T00:00:00Z

内存溢出在嵌入式软件中常见且难以调试。可以通过内存范围检测和哨兵字节方法来防止和追踪溢出,尽管这些方法会影响效率。编译器方法通过特定加载方式存储变量,便于检测和恢复内存使用。

嵌入式内存溢出检测

elmagnifico elmagnifico · 2025-04-09T16:00:00Z

文章讨论了网络游戏中的作弊问题及其检测方法,提出使用统计方法和蜜罐技术识别作弊者。强调社区管理和玩家信任在防止作弊中的重要性,并指出现代游戏中的作弊手段越来越隐蔽,给开发者带来挑战。最终认为,建立小型社区和利用人类判断力可能是更有效的解决方案。

人工智能作弊: 为什么你没有注意到你的队友在作弊?

程序师 程序师 · 2025-04-06T03:21:15Z

Linux rootkit是一种恶意软件,旨在隐藏其存在并提供未经授权的系统访问。分为内核态和用户态,常用手段包括动态链接库注入、ptrace系统调用和替换系统工具。检测方法包括检查LD_PRELOAD环境变量和配置文件。

Linux Rootkit检测思路

FreeBuf网络安全行业门户 FreeBuf网络安全行业门户 · 2025-03-11T09:36:24Z

本研究分析了大型语言模型中的隐性偏见,分类了检测方法和评估指标,并总结了减缓措施及未来挑战,为研究者提供指导,激励创新探索。

Implicit Bias in Large Language Models: A Review

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-04T00:00:00Z

本文探讨大型语言模型(LLM)生成代码的知识产权风险,构建了LPcode数据集,发现人类代码与LLM生成代码在命名、结构和可读性上存在显著差异。提出的LPcodedec方法在检测任务中表现优异,提升了F1分数和处理速度。

Detecting LLM Transformed Code and Identifying Its Source Using Coding Style Features

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-25T00:00:00Z

本文提出了一种有效的AI生成文本检测方法,通过向数据集中添加噪声来增强模型的鲁棒性和泛化能力。研究结果表明,该方法在文本检测中表现优异,为相关领域的发展设定了新标准。

Detecting AI-Generated Text Using Noised Data and an Ensemble of DeBERTa Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-24T00:00:00Z

本研究提出DeFiScope,这是首个基于大语言模型的DeFi价格操纵检测方法,能够有效识别标准和自定义价格模型下的操纵行为,实验结果显示其精度和召回率显著优于现有技术。

DeFiScope: Detecting Various DeFi Price Manipulations Using Large Language Model Inference

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-17T00:00:00Z

本研究提出了TAD-Bench基准,旨在提升基于嵌入的文本异常检测方法的有效性和通用性。通过整合多个数据集和先进技术,揭示了嵌入与检测方法之间的互动,为构建更强大、高效的异常检测系统提供了新视角。

TAD-Bench:一种用于基于嵌入的文本异常检测的综合基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-21T00:00:00Z
比较PHP的空安全运算符与另一个空安全运算符可能会让你陷入困境

PHP的空安全运算符简化了Eloquent关系链,但在用户和模型所有者都没有教练时,权限检查会失败(null === null),目前缺乏有效的检测方法。

比较PHP的空安全运算符与另一个空安全运算符可能会让你陷入困境

DEV Community DEV Community · 2025-01-20T19:36:41Z

本研究提出了一种智能可解释微滴数字PCR(I2ddPCR)检测方法,解决了微滴数字PCR在自动解读和适应不同环境中的挑战。该方法结合预测模型和GPT-4o多模态大语言模型,实现了99.05%的处理准确率,提升了分子诊断的透明度和可靠性。

Interpretable Droplet Digital PCR Assay for Trustworthy Molecular Diagnostics

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-16T00:00:00Z

在互联网AB实验中,异常值会导致结果不稳定。异常值的定义因领域而异,常见原因包括测量误差、个体差异和数据造假。处理异常值的方法有trim和winsorize,前者适合去除脏数据,后者在样本分布较散时更稳健。有效的检测方法包括统计模型和机器学习算法,需根据具体场景选择合适的方法。

【A/B实验常见问题】实验异常值应该如何处理?

京东科技开发者 京东科技开发者 · 2025-01-08T05:30:26Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码