文章介绍如何用Cohere Embed 5 Pro与Qdrant实现可扩展的PDF检索。Embed 5 Pro以单个稠密向量表示整页图像,无需OCR,在5个ViDoRe V3英文语料上优于多个晚交互模型。结合Matryoshka降维、非对称量化(页面1比特、查询8比特)与全向量重打分,512维方案每页仅占64字节内存,并保留99.2%的检索质量,适合大规模生产部署。
BrowseComp-Plus测试显示,GPT-4.1直接获得支持文档时准确率为93.49%,但使用BM25检索时仅14.58%,表明模型智能无法弥补未检索到的证据。智能体搜索需多次并行检索,检索质量、尾延迟和查询量至关重要。应让智能体使用过滤器、排序策略等丰富接口,并通过Schema-to-Skill将模式转化为可用的检索技能。
本文提出基于AWS托管服务的GraphRAG汽车售后知识助手方案,融合知识图谱与向量检索,解决维修手册多语言、多模态、难关联查询等痛点。方案涵盖文档解析、实体抽取、混合检索与可溯源问答,可缩短手册启用周期、降低技师依赖,并可推广至其他知识密集型领域。
Perplexity 发布 pplx-embed-v2-late 视觉检索模型,可直接搜索 PDF 页面图像,无需 OCR。每页约 1700 个向量,float32 下占 856KB,百万页需 800GB。Qdrant 用 TurboQuant 将其压缩至 1 比特,每页仅 40KB,缩小 21 倍,保留 96.5% 检索质量,重排序后达 99.9%。测试显示页面图像检索优于 Markdown,OCR 应变为可选。
miniCOIL EN-ES是首个双语稀疏神经检索器,能将英语和西班牙语中意思相同的词(如home与casa)映射到稀疏向量的同一概念槽位,无需翻译即可用单一倒排索引跨语言检索。模型基于multilingual-e5-small,用MUSE词典构建约1.2万概念,实际训练2398个概念头,并保留BM25回退。评测显示单语检索略有提升,跨语言检索召回率优于翻译加BM25,但排序精度稍逊。
该文本仅为 Tanzu Spring 的订阅推广信息,无实质文章内容可总结。
Cohere发布Embed 5,包含Pro和Fast两个版本,共享同一嵌入空间,可分别用于索引和查询,无需重建索引。测试显示,Pro索引配Fast查询的检索质量达98.4,接近Pro对Pro的100。Fast吞吐量高2.4倍,价格更低。支持多语言、图文输入及多种向量维度与格式,适合RAG和智能体场景。
Voyage发布Rerank 3系列重排序模型,包括rerank-3和rerank-3-lite。在95个检索数据集上,两者分别超越Cohere Rerank v4.0 Pro 2.72%和2.23%。长文档检索提升最大,rerank-3比前代高3.35%,比Cohere高13.84%。代码检索也显著改进。模型保持32K上下文和指令跟随能力,价格不变,rerank-3-lite以40%价格达到rerank-2.5质量,无需改代码即可升级。
搜索效果差时,不应只升级重排序模型。大规模重排序成本高、延迟大,且候选池本身没有好结果时重排序也无能为力。更优方案是将检索设计为多阶段漏斗:先用低成本词法、向量或混合检索生成大量候选,再逐步收窄,最后才用机器学习重排序。该思路同样适用于RAG,需权衡召回率、相关性、延迟与成本。
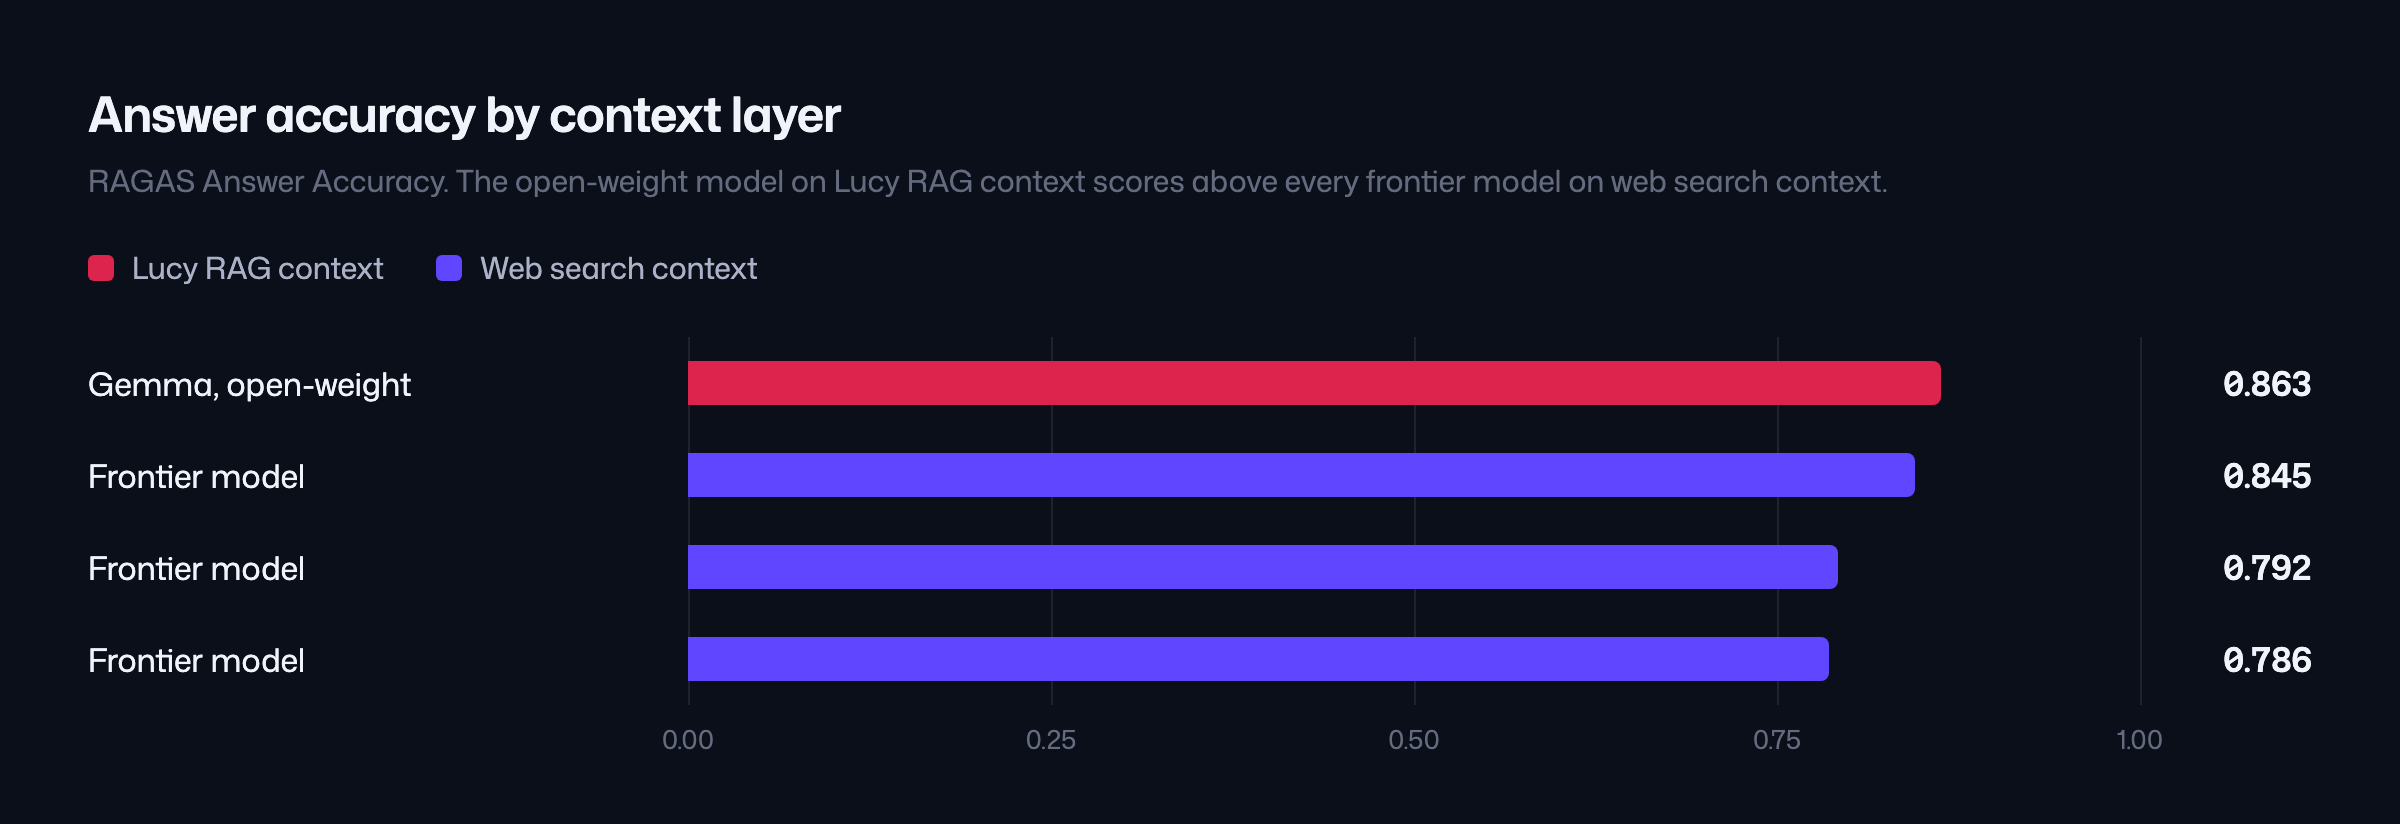
Lucy为金融AI构建数据基础设施,将SEC和韩国DART的280多万份监管文件转为可检索数据。其RAG系统采用Qdrant的混合搜索、元数据过滤和量化技术,在FinanceBench上Recall@10达94.7%,仅靠检索即提升答案准确率0.16,使开源小模型表现超过依赖网络搜索的前沿模型,且答案可溯源至原始文件。
OpenAI发布法律AI工具Astra for Law,其检索索引覆盖超99.9%美国已公布先例判例法,并结合GPT-6 Astra,法律研究正确率达54%,远超网页搜索版。该工具支持零数据保留、26个插件,并允许律所定制。但成本高、定价未公布,模型仍可能出错,需律师审核,且存在供应商锁定风险。
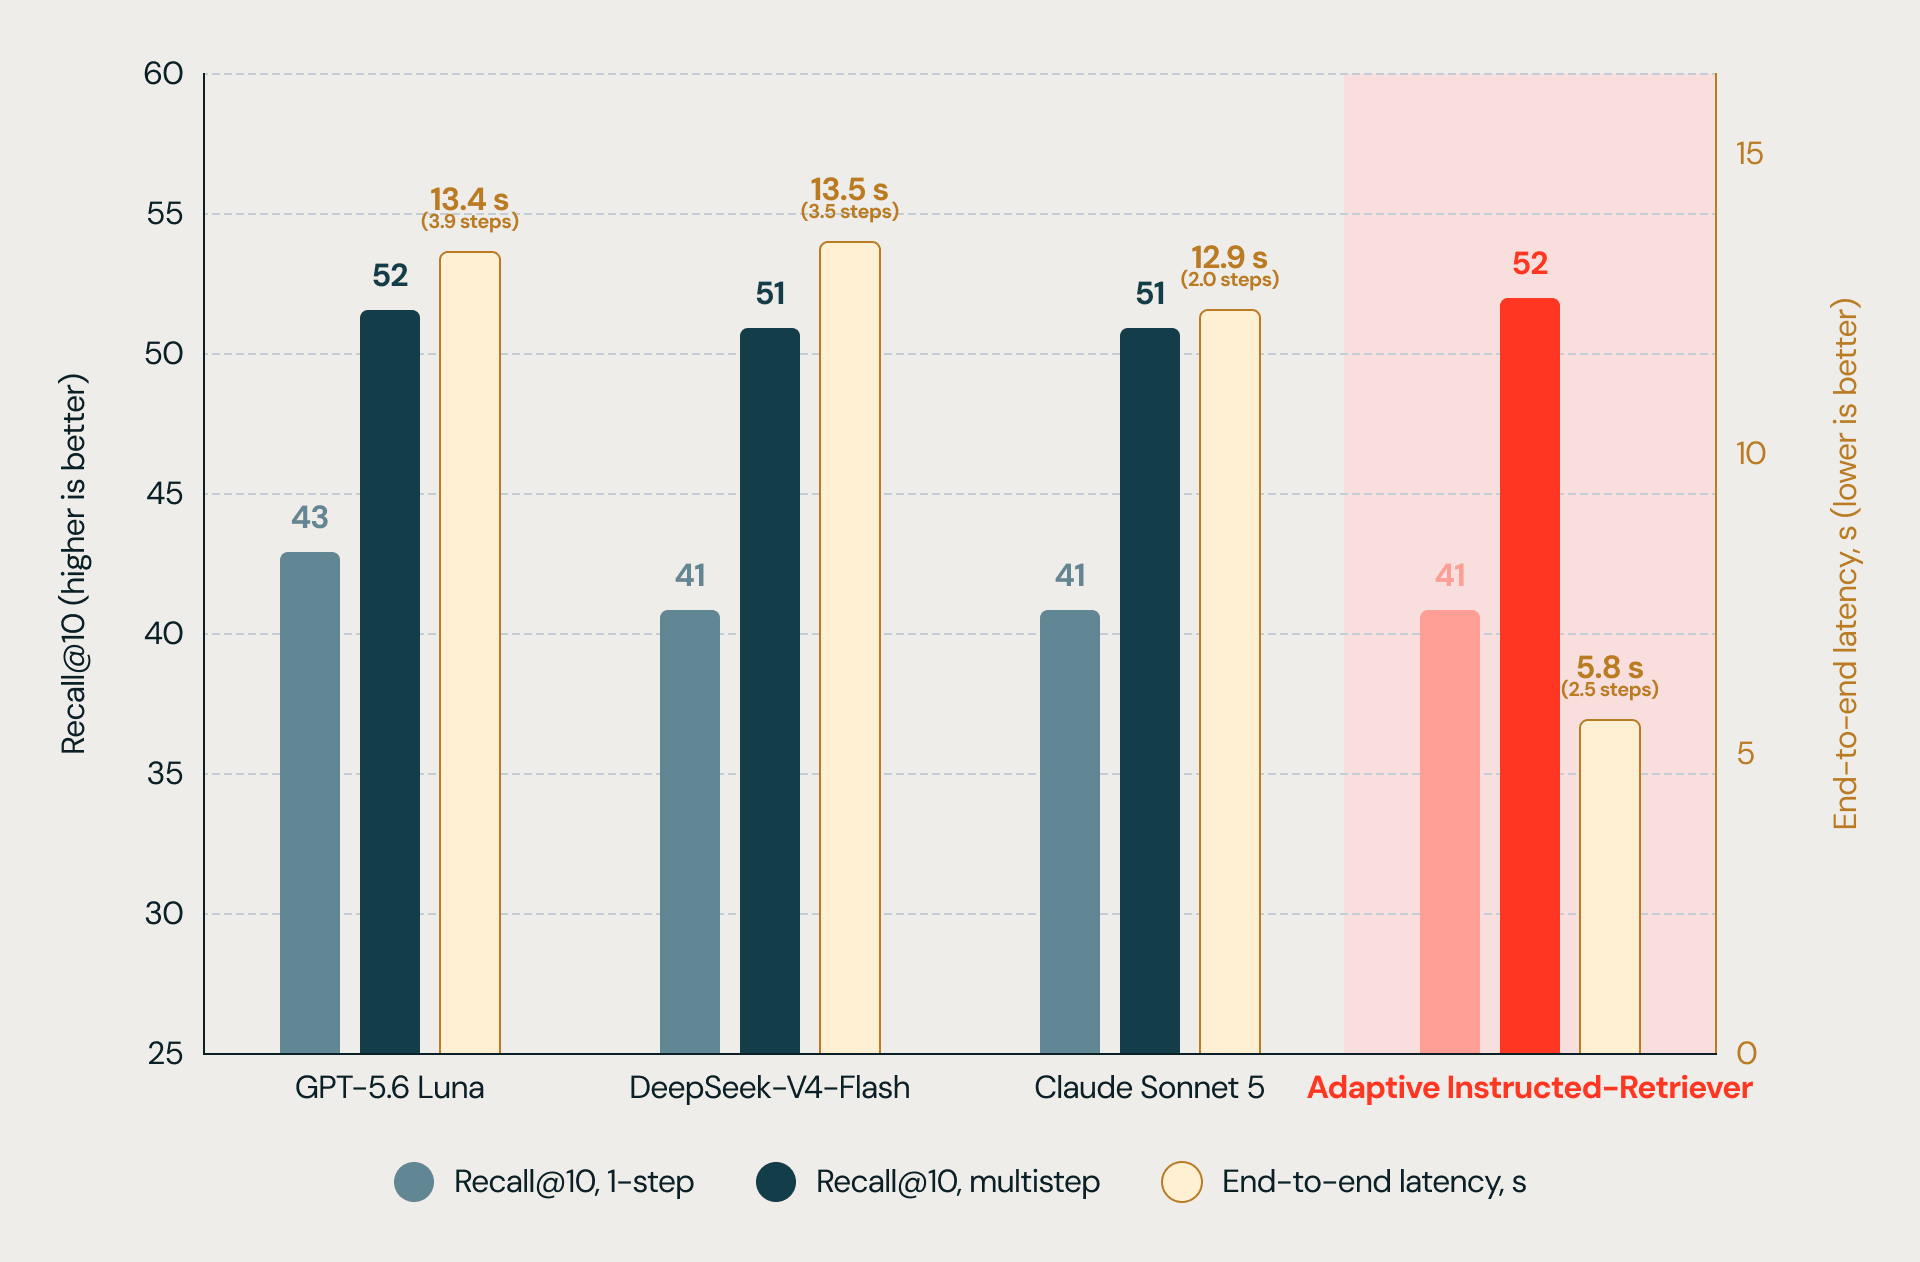
Databricks推出自适应指令检索器,结合并行与顺序搜索,根据查询复杂度动态调整步骤,平衡质量与延迟。训练采用在线强化学习,优化步骤惩罚,实现2倍低延迟且性能媲美顶级模型,适用于企业数据代理场景。
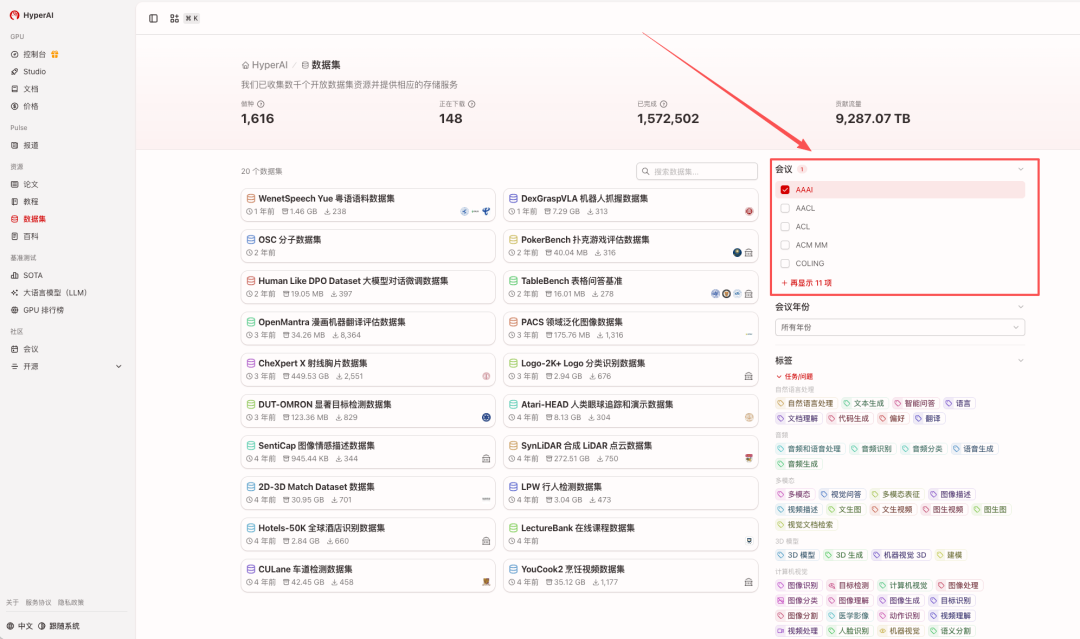
HyperAI平台推出三项更新:上线MCP服务器,支持在Claude Code和Cursor中通过自然语言管理算力、数据集等资源;新增AI顶会(如AAAI、CVPR)筛选功能,便于查找相关教程和数据集;推出系列教程,系统化覆盖AI基础、机器学习等方向,提升学习效率。
企业大规模部署AI代理时,检索架构面临并发查询、数据新鲜度及相关性漂移等挑战。现有碎片化系统难以支撑多代理协同,导致性能下降。9月24日网络研讨会将探讨如何通过统一检索层解决此问题,提升代理扩展性与效率。
本文介绍如何用Amazon DynamoDB原生向量搜索构建Agent长期记忆,无需双写。通过将业务属性和embedding存入同一item,用一次PutItem写入,SearchVectors语义召回,Query按时间读取。文章涵盖数据模型、建表、写入、检索细节,并指出分区键非安全边界、等值过滤限制、成本按字节计费等注意事项,适合操作型数据已在DynamoDB的场景。
随着组织从聊天机器人转向能调查、推理并代表用户行动的AI系统,检索成为应用质量的基础。传统搜索和RAG应用可容忍不完美检索,但智能体不能。检索工程需结合混合检索、实时信号、排序和机器学习推理,确保在服务时提供最佳决策。竞争优势转向决策,即决定智能体应看到什么及顺序,这将成为核心工程学科。
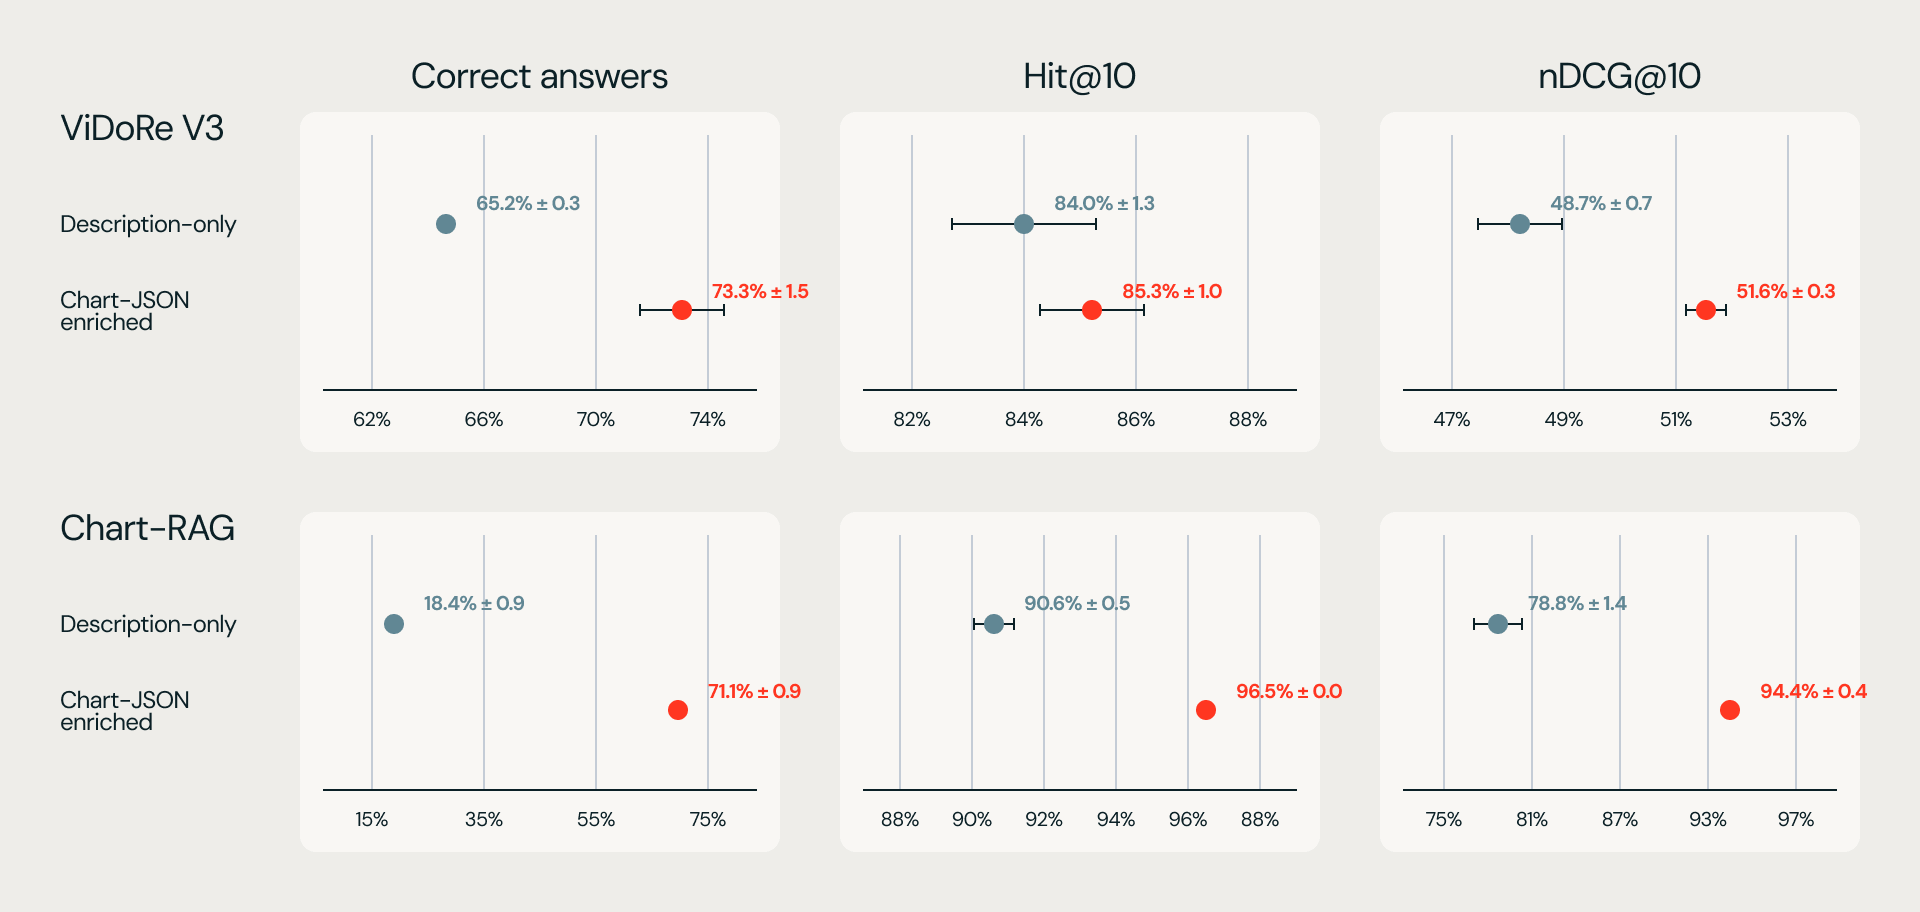
Databricks团队通过ai_parse_document将图表提取为结构化JSON,结合轻量文本检索,显著提升图表检索和智能体回答准确率,优于大型多模态嵌入模型。在ViDoRe V3和Chart-RAG基准测试中,该方法表现优异,且模型更小、开销更低。未来将集成至Genie,改善企业文档图表问答。
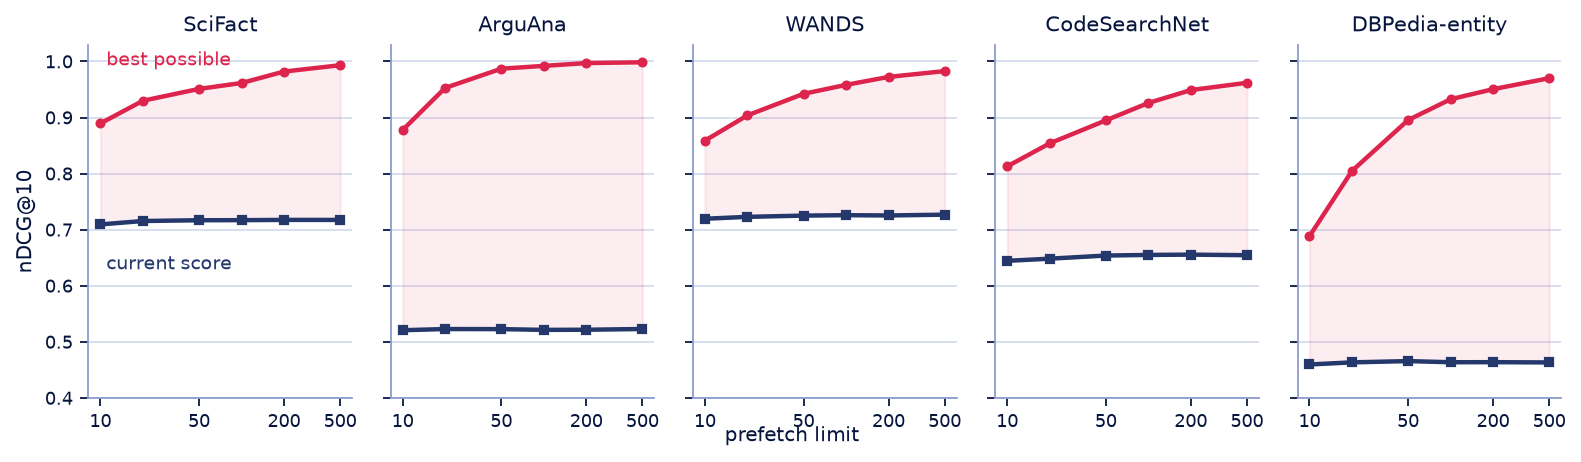
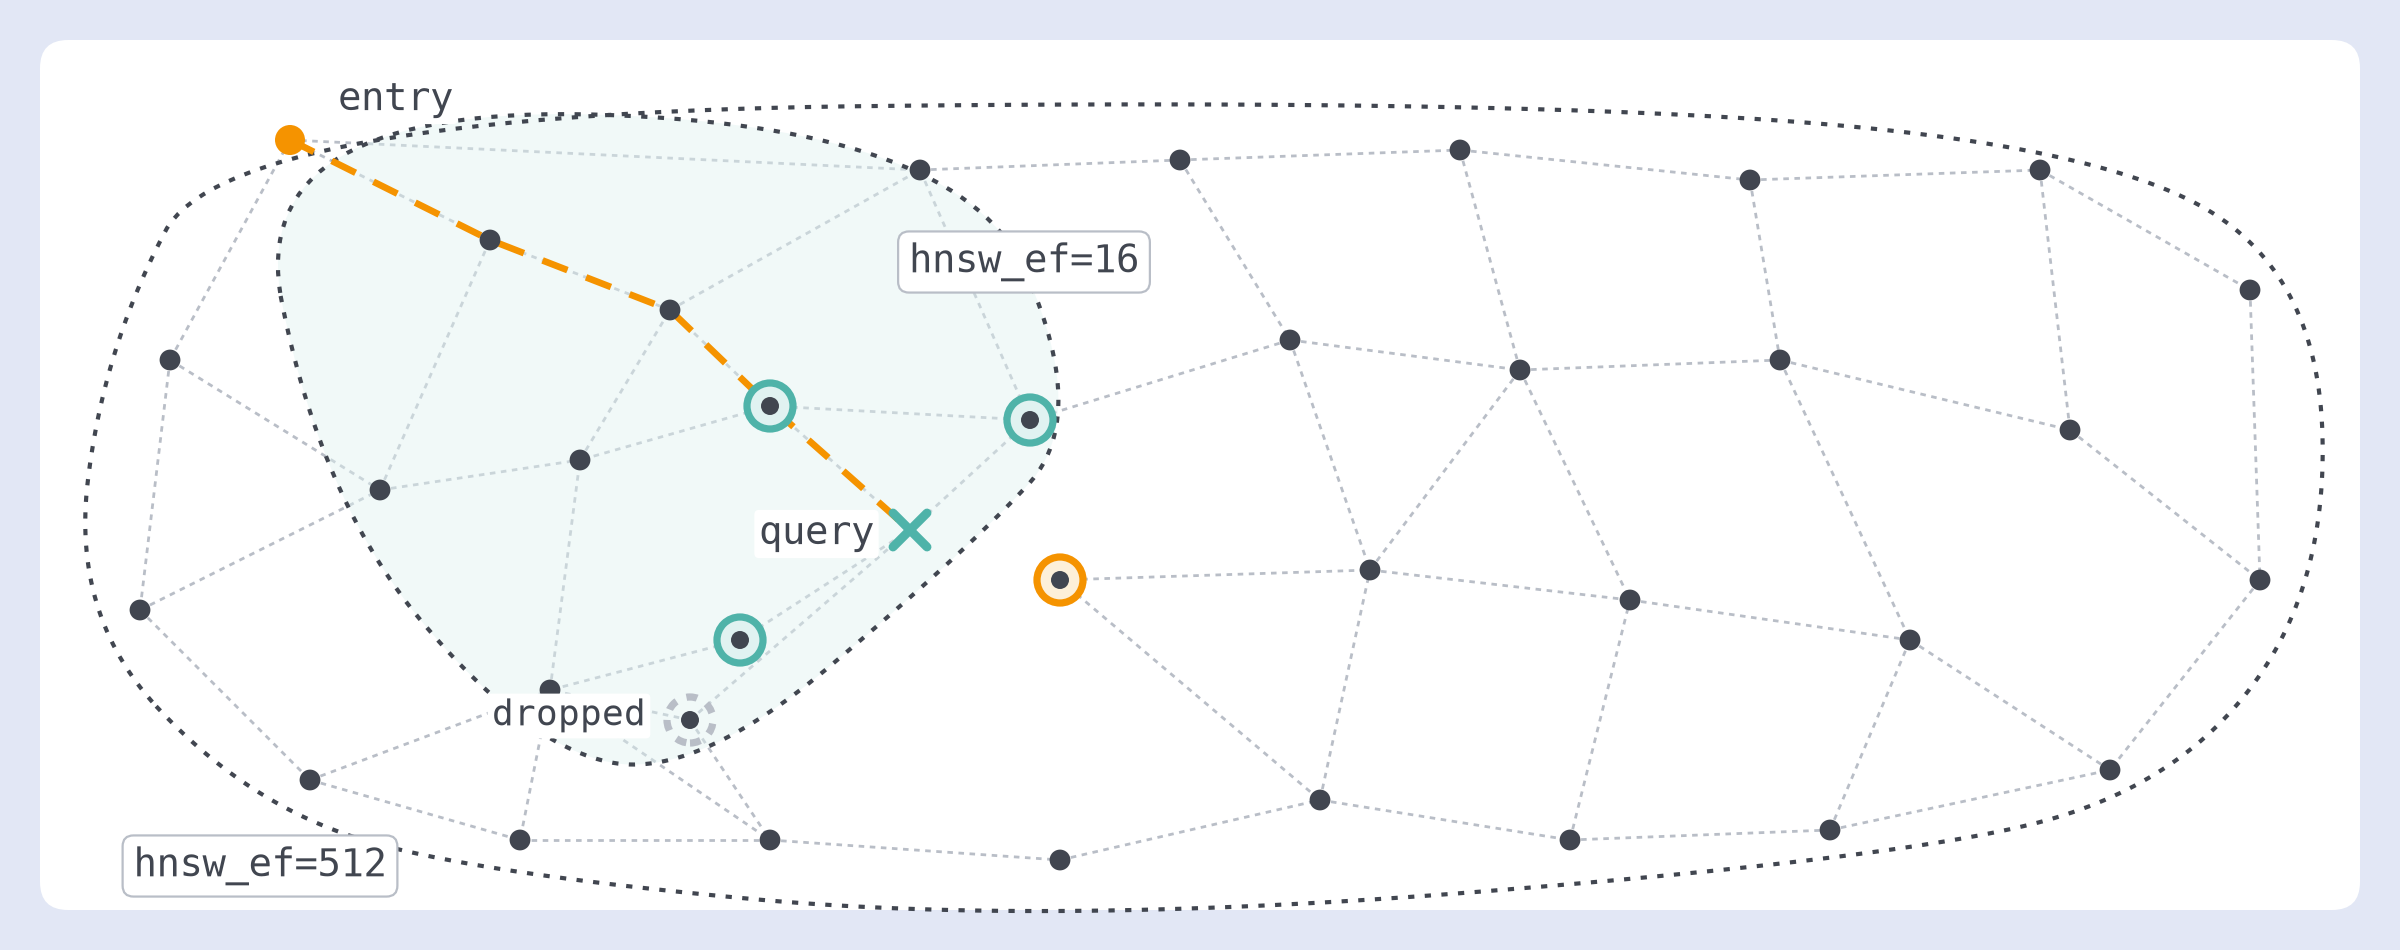
本文讨论检索系统中候选深度(candidate depth)的调优方法。建议先设置基线,测试100-200的limit值,并对比近似搜索与精确搜索的召回率。增加候选可提升最佳可能分数,但需权衡延迟。当RAM受限时,优先考虑量化而非降低深度。hnsw_ef仅在召回率未饱和时调整。最后根据最佳可能分数与当前分数的差距,决定优化排序或检索。
候选深度是检索阶段传给后续排序的候选数,仅当后续阶段能利用额外候选时才有意义。建议初始测试100至200,但需按自身数据验证。提高hnsw_ef仅在召回率仍上升时有效,否则只增延迟。内存受限时优先测试量化,而非降低候选深度。
本文介绍如何在普通笔记本电脑上构建无需云端的RAG系统。核心方法包括:量化模型降低内存占用、使用紧凑嵌入模型和本地向量存储。系统涵盖文档分块、嵌入索引、检索和本地生成等步骤。可靠性通过引用来源、相似度阈值、评估集和查询日志实现。推荐使用llama.cpp、LangChain、FAISS等轻量工具,并建议从小规模开始逐步调优。
完成下面两步后,将自动完成登录并继续当前操作。