作者分享两个Rust小工具解决Claude Code痛点:ccm用于模型路由,支持多模型切换、将OpenAI兼容端点转为Anthropic协议,并提供路由策略、熔断与成本台账;ccs用于跨项目会话查找,可在TUI过滤后直接回到原目录恢复会话。两者均为单二进制、无运行时依赖,支持Windows和Linux。
Cloudflare在AI Gateway推出Auto Router公开测试版,用户可将模型设为cloudflare/auto,系统自动按任务难度选择足够胜任的模型,无需手动挑选。内部测试显示,相比只用前沿模型,成本最多降低30%,性能接近Opus等顶级模型。其流程为先筛选可用模型,再用分类器判断任务类型与复杂度,结合价格和缓存成本评分,选出性价比最高者。
OpenAI发布GPT-6.1 Sol,能力接近Astra但单任务成本更低。文章强调,真实成本不应只看token单价,而应等于调用成本乘以尝试次数,再加上工具、人工复核与失败损失。建议先记录成功率、缓存命中、重试和人工耗时,再按失败代价路由模型,并进行灰度验证。
企业AI成本治理不能只看Token单价。微软AI FinOps更新支持按租户、群组、用户设置预算与提醒,并关联Azure订阅。核心指标应为“单位有效任务成本”,即模型、工具、复核与重试费用除以通过质量门禁的任务数。实践需统一任务标识、建立三层预算、开展模型路由对照实验并定期淘汰低效场景,让预算与结果数据共同指导投入。
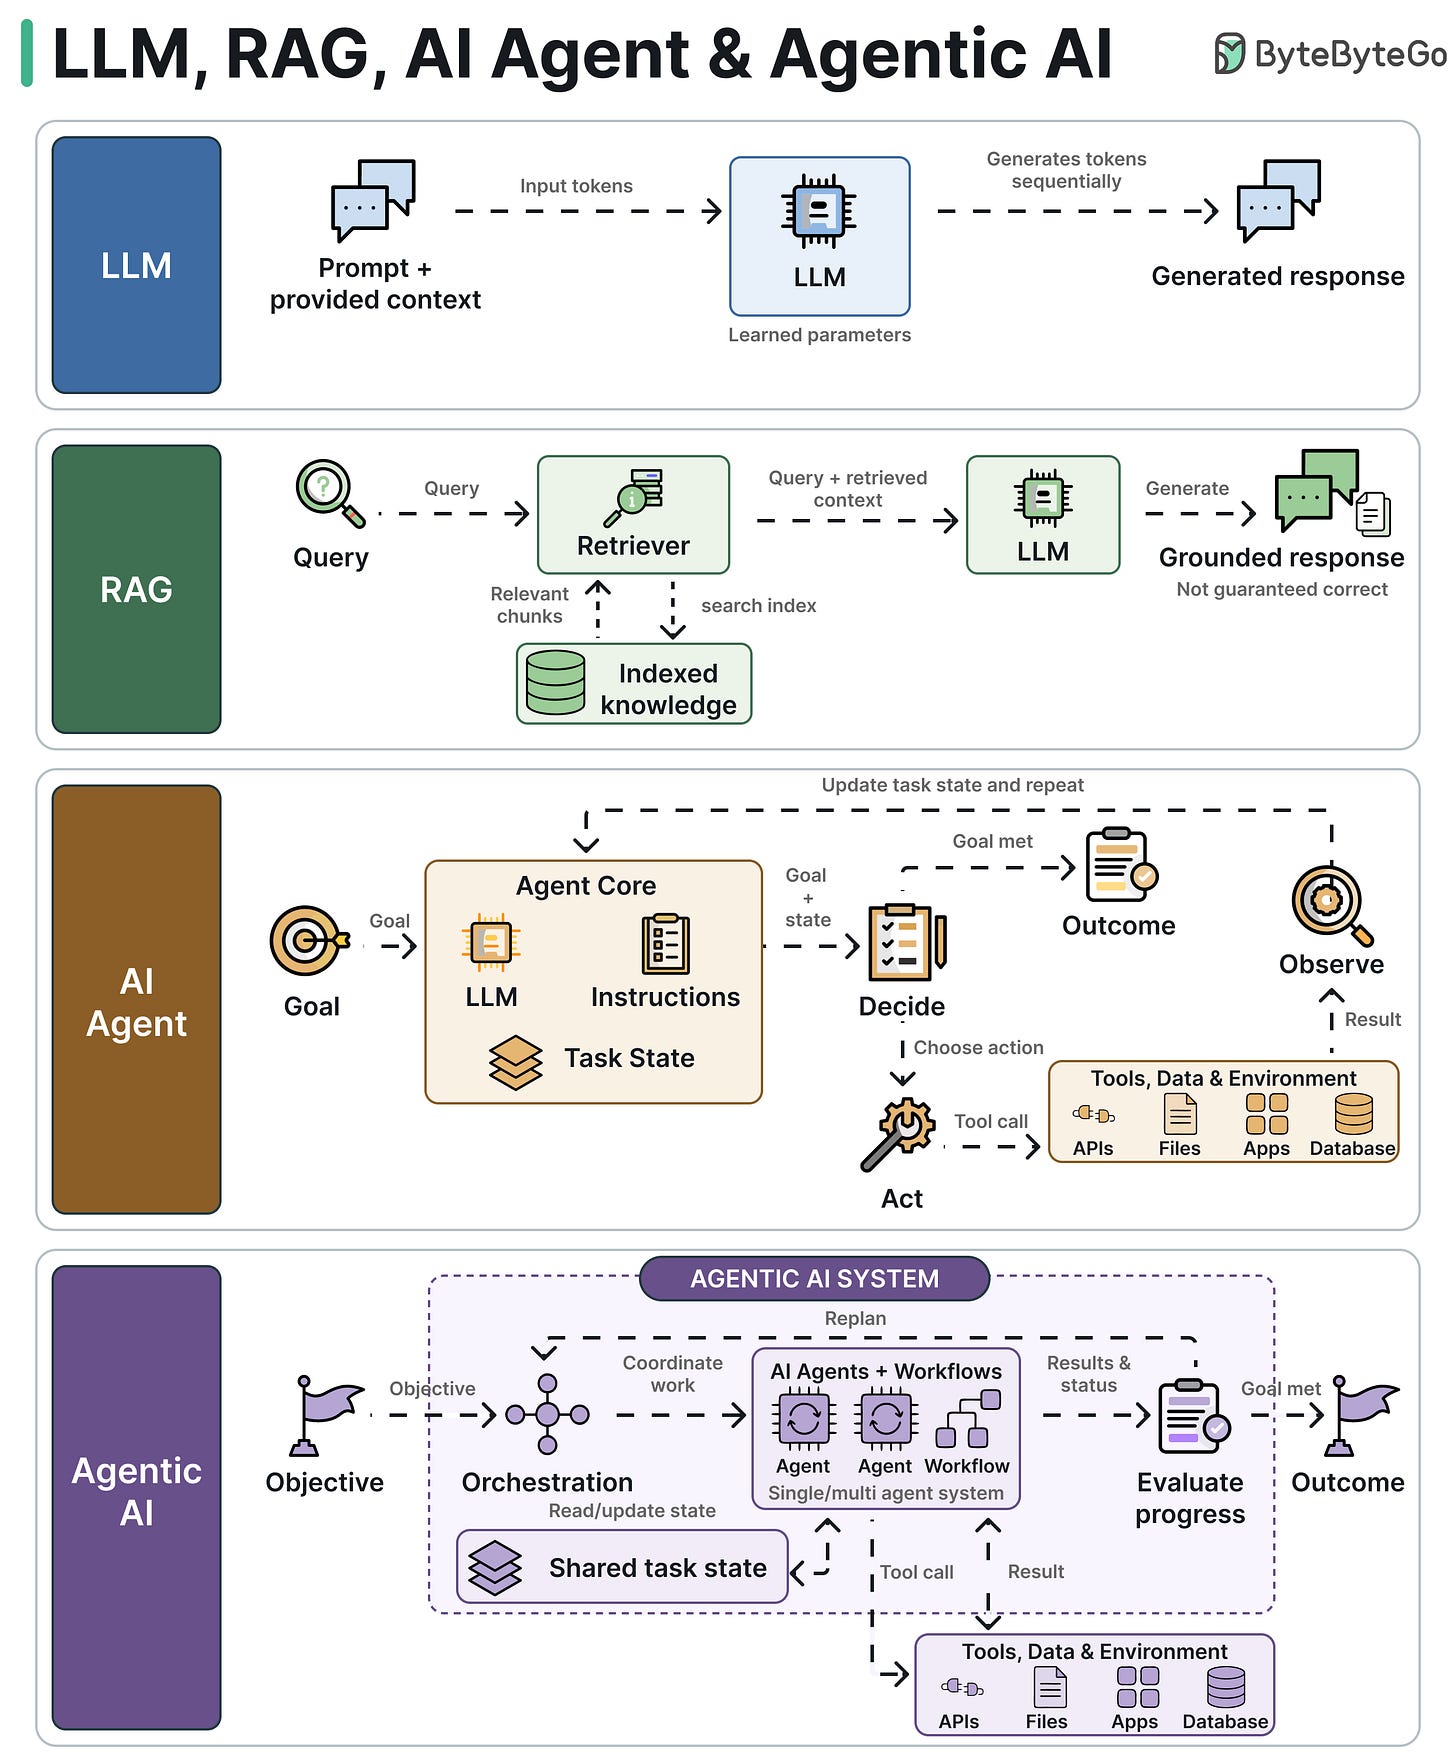
文章介绍Jev的九大用途:模型路由、安全护栏、工具调用权限分类、邮件分类、重排序、LLM评估、批量标注、实时决策和置信度门控,核心思路是用LLM负责生成、用Jev处理周边决策。文章还对比了LLM、RAG、AI代理与代理式AI,说明MCP与函数调用的区别,并列举Claude Code上下文窗口的九个来源。
TypeSafe发布JEV模型,定位为“System One”决策引擎,仅做结构化判断,不生成文本。支持是非、多选、打分三种原语,输出带概率与置信度,响应70~500毫秒,输出免费,结构上不会产生格式幻觉。LangChain、Vercel已集成,用于模型路由、工具风险拦截等。JEV不擅长生成、计数和日期比较,本质是更聪明的if语句,而非替代大模型。
TypeSafe AI 推出决策小模型 Jev,专用于选择题、打分和是非判断,每百万输入 token 仅 0.042 美元,输出免费,比大模型快 200 倍、便宜 400 倍。文章介绍其三种题型与十步集成方法,并展示浏览器操作、邮件分类、安全护栏、模型路由、上下文压缩五大场景,指出智能体约八成调用实为选择题,应交给 Jev 处理。
codex-router 是社区开源的本地模型路由工具,让 OpenAI Codex 无需更换客户端即可接入 DeepSeek、Kimi、Claude 等外部模型。它通过 LiteLLM 转换协议将外部模型并入 Codex 原生选择器,密钥本地加密隔离,支持一键安装、多客户端共享、可视化监控与自定义模型,不覆盖原有配置,可免 OpenAI 账号使用。
Dome Systems由HashiCorp前CEO创立,获1400万美元融资,提供AI代理治理平台,整合代理注册、工具网关和模型路由,以统一控制代理行为。公司现开放自助服务,旨在解决企业采用AI代理时的安全、运营和财务控制问题,类比云基础设施的治理需求。
AI编程助手处理大量I/O任务时浪费昂贵模型token。通过Spotify BackPortal的AiKA Modes创建bulk-reader和code-writer两种模式,用便宜模型处理文件读取和代码生成,可节省约90%token。但无法委托编辑和推理任务,且延迟较高。该方案将模型路由从系统工程问题变为配置问题。
文章介绍如何通过Spotify的AiKA Modes优化AI编程成本。作者创建了bulk-reader和code-writer两种模式,将文件读取和代码生成等重复性任务委托给便宜的Gemini 2.5 Flash模型,而将复杂推理留给Claude。通过Claude Code插件shunt自动路由,测试显示可节省约90%的token消耗,同时保持代码质量。
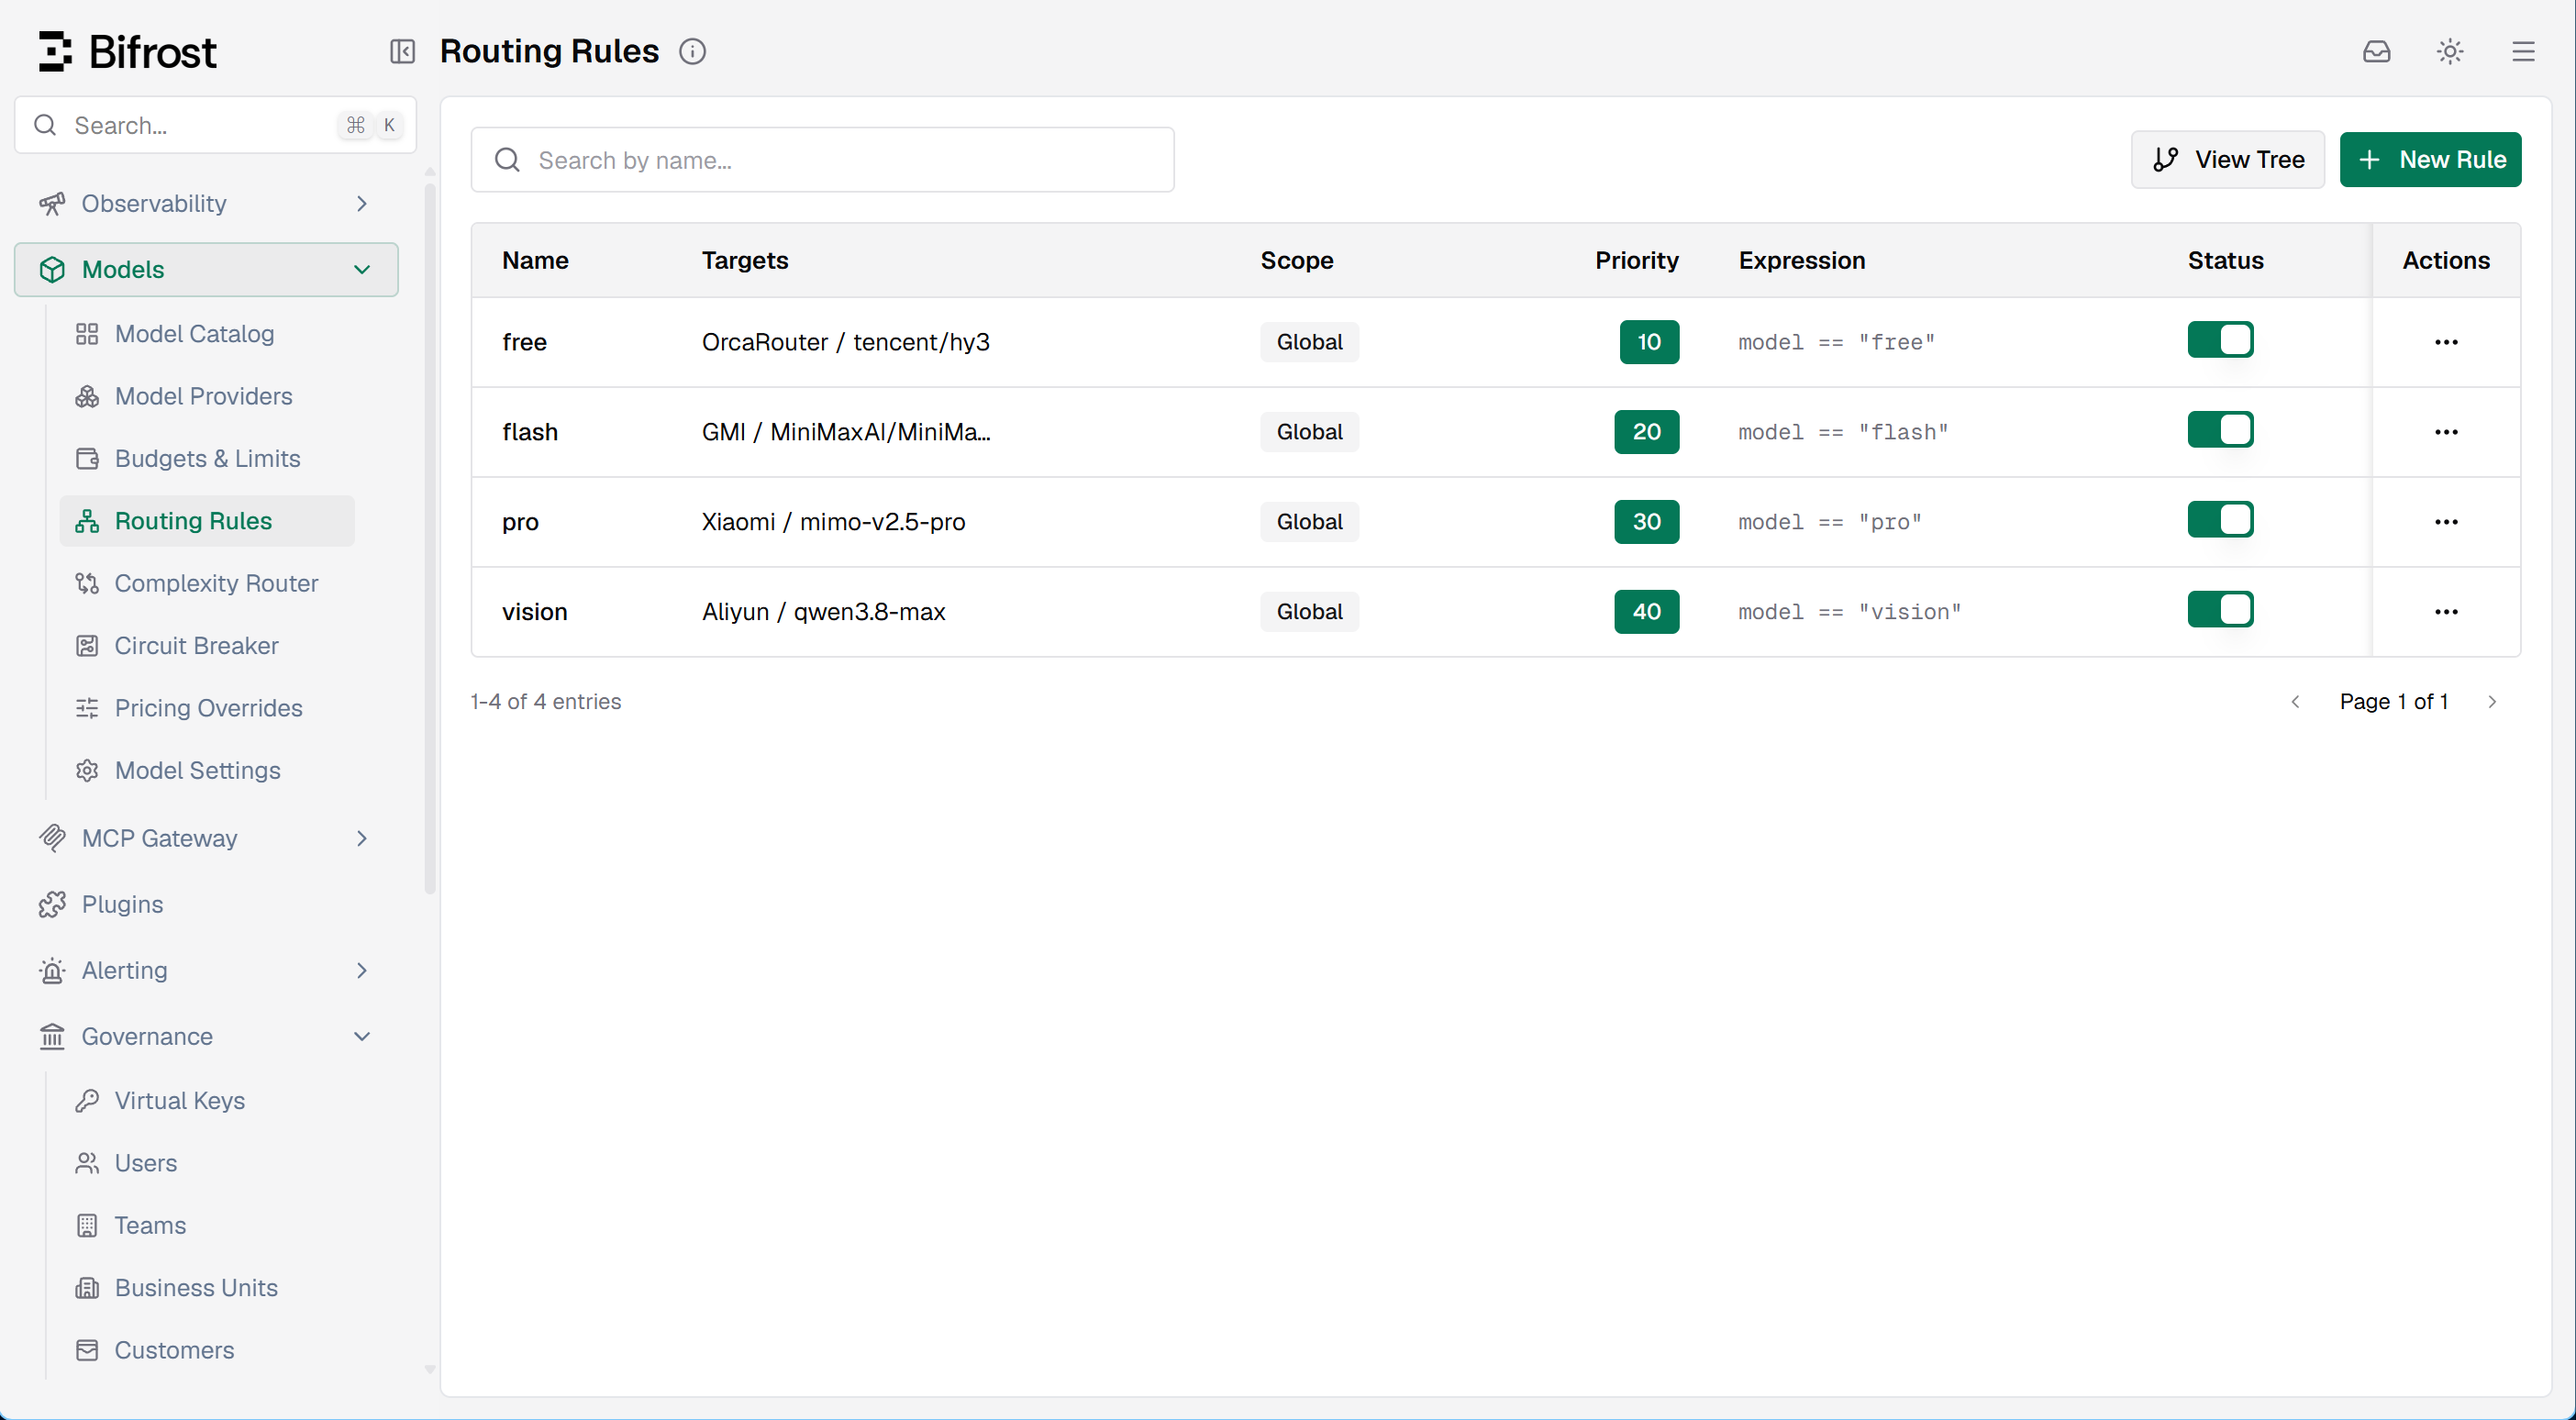
作者因AI模型提供商众多、切换配置繁琐,尝试自建AI网关。对比New API、OmniRoute后,选用轻量级Bifrost,通过Docker部署在Mac mini并绑定公网域名。配置安全访问、模型接口及虚拟密钥,创建路由规则(免费、快速、专业、视觉)重定向模型。最终实现客户端统一调用网关,切换模型只需在网关操作,省时省力。
AI系统设计面试已从“设计YouTube”转向“设计ChatGPT”等AI产品,重点评估候选人对概率性、成本受限系统的推理能力,核心权衡延迟、成本、质量与安全。文章提出七步框架:澄清需求、估算负载、架构草图、深入组件、权衡取舍、故障模式与可观测性、系统演进。关键原语包括RAG、模型路由、护栏、评估和代理循环。常见错误是过早设计、只列组件不解释原因、忽略成本延迟及故障模式。
role-model是一个开源AI模型路由协议,支持本地与云端混合路由,根据任务类型、成本、延迟自动选择模型。DeepSeek Harness插件生态通过“一切皆插件”架构集成,但需手动配置。通过llm-adaptive等插件实现复杂度路由,缓存命中率可达99%,降低推理成本。未来官方插件将统一配置,实现更细粒度路由。
企业架构中,模型路由应置于Harness层而非网关。实测表明,网关路由导致成本增加237%、延迟增加65%,而Harness路由节省58%成本,91%的会话成本减半。网关缺乏任务上下文和缓存信息,无法优化决策;Harness能感知会话状态、失败信号和缓存代价,实现高效路由,同时保持质量不降。
本周AI领域密集发布三款前沿模型:Grok 4.6、Qwen 3.8-Max和DeepSeek V4-Pro,均主打成本优势而非能力提升。开源权重模型压低价格,使价值转向模型路由层。Nvidia推出开源路由器NeWo Switchyard,优化任务分配。专家指出,更便宜的模型不会减少AI预算,反而因杰文斯悖论增加使用量。企业约70%任务用本地小模型,20%用中端API,10%用前沿模型。
DeepSeek V4 Pro 0813虽涨价三倍,但在智能体任务中可能更省钱,因其模型能力提升减少了工具调用和Token消耗,且1M上下文和缓存优化降低了总成本。Pro适合复杂任务,Flash适合简单任务,模型路由和任务分层是关键,最终竞争聚焦单位任务成本而非单价。
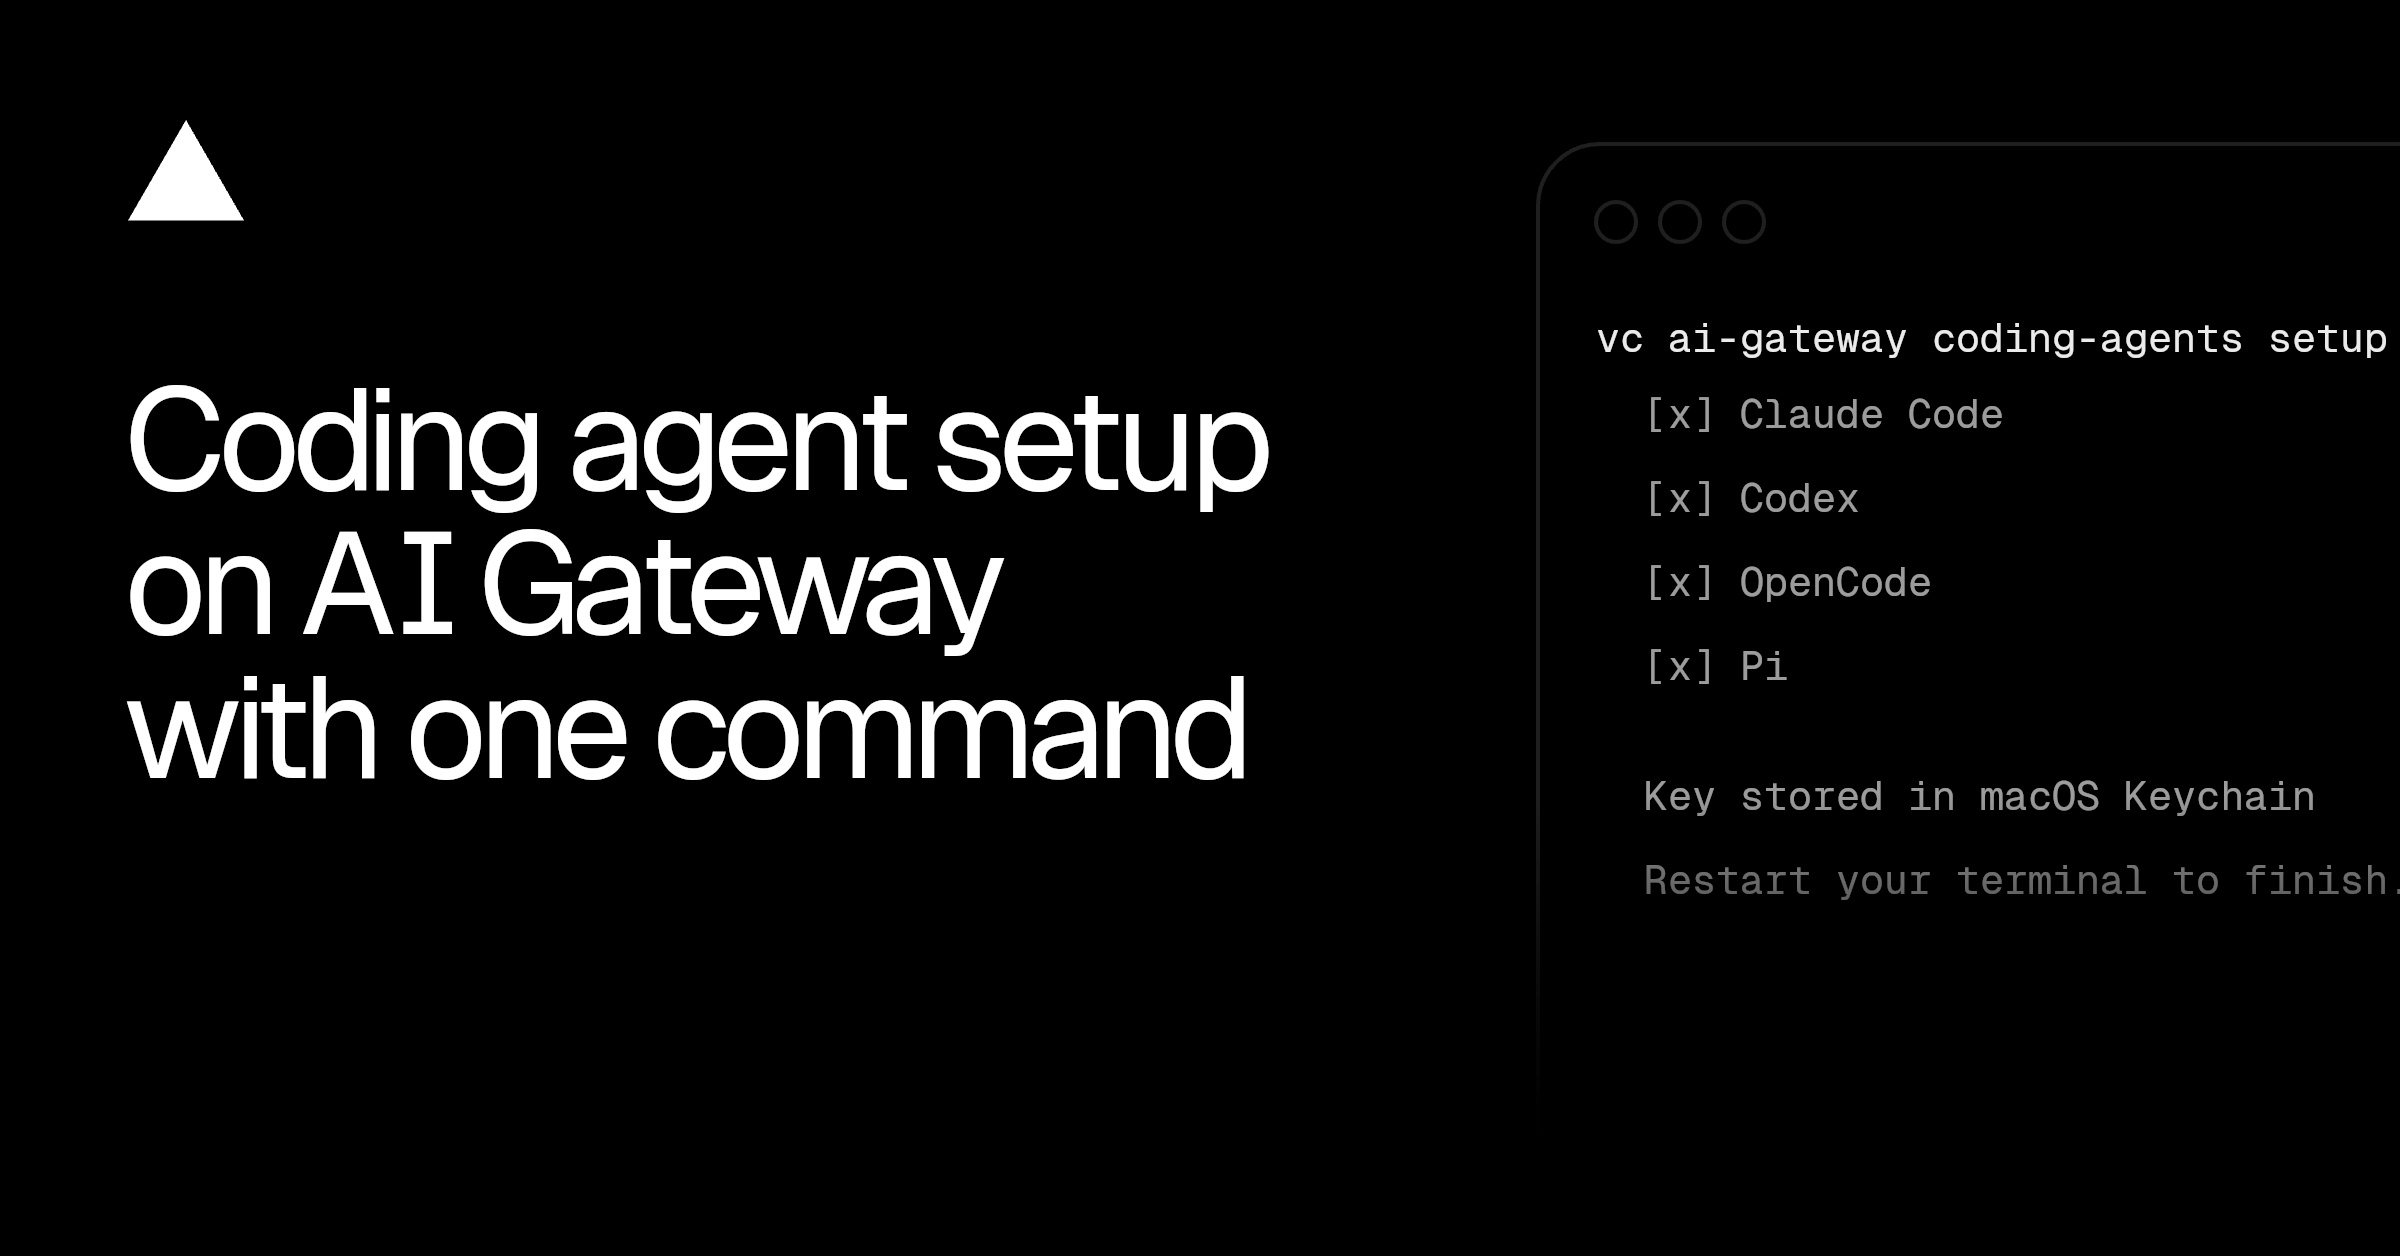
Vercel AI Gateway新增coding-agents setup命令,支持集中管理Claude Code、Codex等9种编码代理。用户可通过单条命令配置API密钥、路由200多种模型,并统一监控流量与成本,设置预算和数据保留策略,简化多代理管理。
多智能体AI系统中,令牌使用量易激增,导致成本高和延迟。本文介绍四种节省令牌策略:静态指令缓存、语义缓存、即时工具加载和任务升级路由。通过示例代码展示语义缓存与模型路由结合,优化资源,降低成本。
本文介绍如何构建一个多模型AI编排系统,以解决单一模型架构的成本高和单点故障问题。系统通过PromptAnalyzer分析提示词复杂度,ModelRouter将任务路由到合适的模型,ResilientModelEngine实现自动故障转移。文章提供了Python代码示例,并强调使用轻量级分类、设置超时和跟踪指标等生产实践。
完成下面两步后,将自动完成登录并继续当前操作。