A社开源了FlashProve研究原型,利用zkSNARK零知识证明验证AI回复是否来自指定模型:先对模型权重作密码学承诺,再为推理结果生成证明,用户可验证而权重保持私有。该技术可用于第三方服务验证、企业安全和模型评测,但需模型提供商主动接入证明流程。代码以Apache 2.0开源,含证明生成、C++验证程序及Lean形式化证明。
Anthropic的Frontier Red Team发布开源系统FlashProve,利用zkSNARKs密码学证明验证AI响应来自特定模型权重而不暴露权重,可帮助开发者核查第三方AI服务是否被偷换模型。测试基于Llama 4 Maverick,单张H100上约每秒处理110个提示词,证明约18.78MB、验证约21秒,但生成证明的GPU开销是常规推理的70至95倍,且仅支持1024 token上下文,尚属研究原型,未接入Claude API。
文章以“小螃蟹”为例说明AI预测:预测是依据数据和模式估计未知结果,与推理相关但侧重不同。应明确目标、数据来源和验证方法,不能只信大模型给出的数字。需用点预测、区间预测和概率表达不确定性,并用新数据检验误差、与简单方案比较。预测后还要结合业务代价做决策,并持续更新。
2026年10月19日,医疗健康世界模型分会在南京举行,主题为“预见疾病·推演生命”。八场演讲围绕临床需求、建模方法、科研验证与应用,探讨疾病演变与干预推演。会上发布高质量数据集共建计划、医疗世界模型一体机、五项慢病模型、地贫筛查模型及数据底座等成果,并强调模型须经真实数据验证,不能替代医生决策。
文章介绍如何验证Claude中转站是否提供真实模型。方法分三步:解码签名明文检查模型标识、通过OpenRouter交叉验证签名真伪、定时巡检防止中途切换假模型。核心原理是Anthropic私钥签名跨平台兼容且绑定模型身份,组合验证可确保响应真实且模型匹配。
本文强调,非数据科学家也能从数据科学和AI中受益,关键在于以决策为起点,而非技术。应先理解数据质量,选择简单有效的模型,严格验证,并将分析转化为行动。大型语言模型应视为助手,需保持人类判断。最终,AI应被审慎用于真正改善决策之处,而非盲目跟风。
本文介绍了DigitalOcean的评估功能,帮助团队在生产前验证模型和推理路由配置。用户可以通过结构化评估,使用预设指标和自定义评分标准管理数据集,并在同一平台上进行评估。该功能支持程序化触发,便于集成到工作流程中,确保模型性能的持续验证。
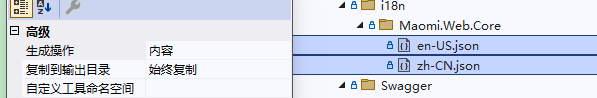
本文讲解了如何在ASP.NET Core中定制Web开发,包括模型验证、统一响应模型、筛选器、异常处理和Swagger定制。通过创建自定义模型验证器和响应模型,确保API的输入输出符合需求,并实现多语言支持和接口版本管理,以提高开发效率和用户体验。
Evalite是一个基于TypeScript的评估框架,旨在帮助开发者将模型和应用检查转化为可重复、自动化的测试套件。它支持模块化测试单元、CI自动化和多种评估指标,便于持续验证模型行为和比较不同模型。
研究发现,虚假奖励能显著提升Qwen模型的性能,接近真实奖励水平。华盛顿大学团队指出,错误奖励和随机奖励同样有效,尤其在Qwen2.5-Math模型中。研究强调推理过程的重要性,建议未来关注非Qwen模型的验证。
本研究评估了重抽样技术在因果分析中的应用,解决了非实验方法验证因果模型的不足。通过理论和模拟实验,揭示了重抽样方法与算法调优参数的关系,并提供了选择重抽样方法的指导。
机器学习在人工智能中至关重要,数据和领域知识同样不可或缺。领域专家在数据收集、特征识别和模型验证中提供关键见解,确保模型的相关性和有效性。忽视领域知识可能导致模型偏见和错误决策。将领域知识与机器学习结合,可以提升模型的准确性和可靠性。
本文探讨了自动化AI功能测试的策略与最佳实践,强调数据验证、模型验证、边缘案例测试和对抗性测试的重要性。Genqe.ai工具能提高测试效率与准确性,确保AI模型在各种条件下的可靠性与安全性。
.NET Core中的ApiControllerAttribute属性简化了Web API开发,提供自动路由和模型验证,减少重复代码。与.NET Framework相比,.NET Core统一了控制器类,提高了开发效率。使用该属性后,模型验证自动处理并返回详细错误信息,增强了API的可用性和一致性。开发者可配置自定义响应行为以满足特定需求。
我在思考如何在AWS API网关中使用JSON schema验证事件负载,并在Lambda中使用Zod解析为强类型对象。为了避免手动重复,确保API网关和Lambda共享同一JSON schema,我寻找与JSON schema兼容的解析器,并发现了一个有前景的候选者。
在医疗和金融领域,模型验证至关重要,以确保AI模型的准确性和公正性。由于许多公司数据质量不高,可能导致偏见和不可靠的决策。通过在真实环境中测试模型,验证其符合监管标准,从而增强信任和可靠性。常用的验证方法包括K折交叉验证、引导法和稳健性测试,帮助识别模型的弱点和偏见。
Sang.AspNetCore.CommonLibraries 是一个 ASP.NET 通用库,旨在简化开发过程,提升代码复用性和可维护性。它提供一致的返回格式、异常处理、模型验证和 HTML 消息页面生成功能,适用于 API 开发和用户提示,增强用户体验。
本研究探讨了复杂社会系统中模型验证的局限性,指出传统的训练-测试范式无法有效评估现代AI系统的有效性。提出参与式数据管理和开放科学等解决方案,以提升AI应用效果。
本研究自动提取脊柱MRI报告中的标签,验证了开放源代码模型的有效性。该方法在五种脊柱病症下优于GPT-4,提取的标签可用于影像模型训练,性能与临床医生手动标注相当。
本文探讨了记忆驱动Transformer在生成放射学报告中的应用,提出了XrayGPT和MAIRA-1等模型,并通过实验验证了其在图像质量和文本生成方面的优势。这些模型有效降低了放射科医生的工作量,提高了报告的准确性和流畅性,同时解决了图像与文本的对齐问题。研究表明,结合视觉编码器和大型语言模型的多模态方法在医学报告生成中前景广阔。
完成下面两步后,将自动完成登录并继续当前操作。