
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ

本研究提出CLIP-Refine方法,旨在解决现代视觉语言模型中图像与文本特征的模态差距问题。通过在小型数据集上训练,实现特征空间对齐,提升零样本性能。实验结果表明,CLIP-Refine有效减轻了模态差距。

视觉语言基础模型中的后预训练用于模态对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-17T00:00:00Z

本研究提出了后处理嵌入标准化方法I0T_post和可训练方法I0T_async,以解决CLIP在下游任务中的模态差距问题,显著减少模态差距并保持原始嵌入表示。

I0T:朝向零模态差距的嵌入标准化方法

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-18T00:00:00Z
CLIP模型中文本-图像模态差距的原因与意义

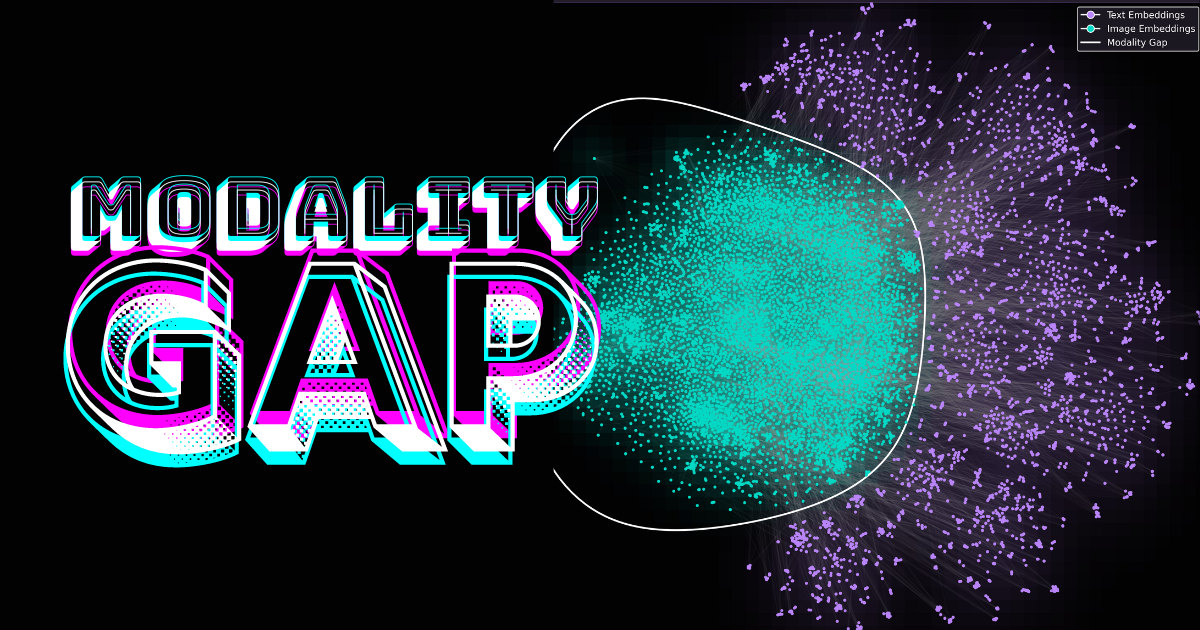
语义嵌入是现代AI模型的核心,嵌入理论有两个部分:AI模型创建向量表示事物,向量之间的空间关系表示事物之间的关系。多模态模型中存在模态差距,即图像和文本在嵌入空间中的位置相距较远。这是结构性问题,可能没有解决方案。训练温度和对比学习也会影响模态差距。解决这个问题可能具有广泛的影响。

CLIP模型中文本-图像模态差距的原因与意义

Jina AI Jina AI · 2024-08-26T13:56:36Z

本文提出了一种新的音视频分割(AVS)策略,构建了经济实惠的基准数据集AVSBench,并引入了音频感知变压器和时间像素级交互模块,显著提高了音频与视觉的分割精度。实验结果显示,这些方法在AVS性能上取得了突破,缩小了音频与视觉模态之间的差距。

渐进培训策略用于音视频语义分割

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-16T00:00:00Z

本文探讨了多模态对比模型中的模态差距及其解决方案。研究人员改进了对比损失函数,使嵌入在表示空间中更均匀分布,从而提升了零样本图像分类和多模态任务的性能。此外,提出了利用CLIP模型进行视觉情感分析和半监督图像标注的方法,显示出在多种任务中优于现有模型的效果。

关于最佳多模态嵌入空间的拓扑视角

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-05-29T00:00:00Z

该文介绍了一种弱监督方法来训练自动音频字幕生成(AAC)模型,只需要文本数据和经过预训练的对比语言音频预训练(CLAP)模型,从而减轻了对配对目标数据的需求。该方法利用 CLAP 中音频和文本嵌入之间的相似性,通过桥接差距的策略减小音频和文本嵌入之间的模态差距。在 Clotho 和 AudioCaps 数据集上评估,相对于使用配对目标数据训练的完全监督方法,该方法可达到高达 83% 的性能水平。

基于文本 - only 训练实现的弱监督自动音频字幕生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-09-21T00:00:00Z
[论文阅读] BLIP2

BLIP-2是一种通用且高效的视觉与语言预训练策略,通过两阶段预训练的轻量Querying Transformer来弥合模态差距。BLIP-2在多个视觉语言任务上取得了SOTA结果,包括图像命名、视觉问答和图像文本检索。模型结构包括图像转换器和文本Transformer。

[论文阅读] BLIP2

MiaoHN's Blog MiaoHN's Blog · 2023-06-26T11:54:59Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码