Amazon S3 注解功能可将分类、保留策略、数据驻留、PII 等治理信息直接附加到对象版本,每版本最多 1000 条、每条最大 1MB,支持 JSON 等格式;注解随复制迁移、可原地更新、在冷存储中仍可读,并可通过 S3 Metadata 表用 SQL 查询。文章还给出事件驱动架构示例,并强调版本化删除、Object Lock 需先注解后锁定、分段复制默认不携带注解、注解删除不可逆、SSE-C 不支持注解及 IAM 读写删权限分离等设计要点。
文章以OpenAI和Anthropic的AI安全评估事件为例,指出配置的隔离边界不等于运行时实际可达范围:智能体可自主选择步骤,将无害事件串联成攻击路径。设计时治理负责设定隔离、权限与策略,运行时治理则需验证实际行为。有效的运行时证据须具备覆盖、关联、及时和可审计四项特性,并将遥测与响应机制连接,才能实现真正的遏制。
r2r-jev 是一个为 Jev 决策模型的判断结果提供持久治理的 Rust 开源项目。其核心是将“判断”转化为带类型的证据,只有通过准入层(接受、暂缓或拒绝)后,才会改变信任、授权等长期状态,避免概率直接转化为权限。项目强调确定性:概率转为整数、不使用浮点数和时钟、相同输入产生相同输出,并支持事件重放对账。准入层包含七步判定与反例,实验显示可缩小误报的影响。此外还提供 MCP 治理控制面,无需 API key 即可运行。
文章主题为AI时代的网络安全防护蓝图。作者认为当前正值“防御者窗口期”,应尽快让防御方获得先进AI能力。蓝图向政府和业界提出三方面建议:一是加强对前沿模型与智能体的安全责任、危险行为检测和可靠关停控制;二是推动网络安全现代化,为防御者提供工具与培训并保护关键服务;三是建设有韧性的公共机构,强化评估、事件报告与协同响应。
企业IT追求确定性,而AI的非确定性给运营带来挑战。文章指出,企业AI落地受阻于数据质量、混合云工具分散及大型机衔接等问题。关键在于将AI代理纳入统一编排与治理,在执行路径中强制身份、权限、审批与审计,实现确定性任务与AI代理的协同编排。治理须跨所有环境统一,并以可解释、可回滚、可审计为标准。BMC据此推出Control-M及大型机相关AI能力,强调可预测性仍是核心。
Fable 5.5 被吹成"世界最强模型",可它还没公开,公司就已经在规划怎么分配它"印出来的钱"了! Anthropic在2026年10月宣布成立公共利益基金。初始注入5%股份,估值9650亿美元。联合创始人此前已承诺捐出80%持股。合计约20%股份锁定公益用途。基金是LLC架构,禁止用于政治游说。但治理细节和触发追加机制的具体规则,要等几个月后才公布。 ## 公益基金不捐利润改押股
MIT调查显示,83%供应链从业者重视可持续发展,但关税与地缘冲突迫使68%企业缩减相关战略。仅51%企业设跨职能团队,33%由董事会监督。AI应用虽广,却未必降低总排放。报告指出,治理与问责缺失是主要障碍。
多数工程团队低估了自建AI知识系统的难度,六个月后往往成为平台团队的长期负担。生产级管道包含捕获、验证、组织、治理、交付五个阶段,每阶段都需持续维护,成本随AI栈复杂度增加。自建向量库虽可行,但构建受治理的可信知识管道极难,多数公司应选择采购而非自建。
Druid AI推出语音、代理互操作、治理与评估新功能,帮助企业将AI代理从实验推向受监管生产流程。新功能包括行业定制语音模型、Druid MCP跨平台编排、Druid Conductor行业代理协调,以及含26项可衡量组件的AI代理参考模型,强调以业务成果而非活动量衡量成功。
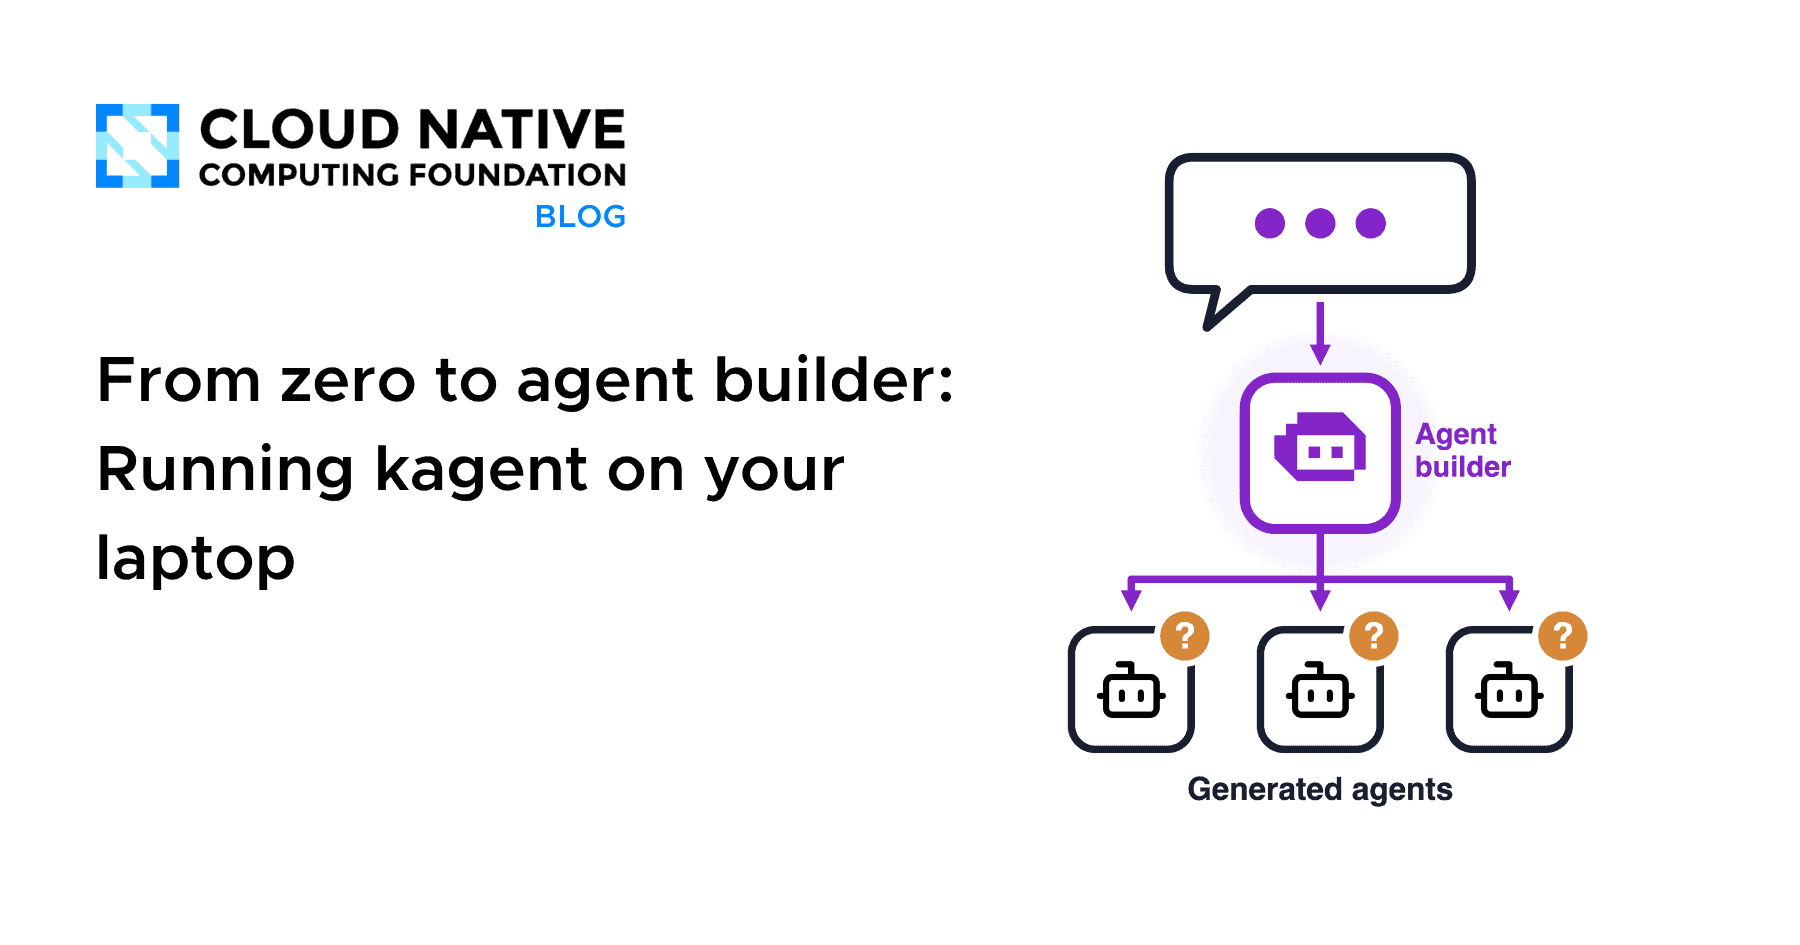
本文介绍用开源项目 kagent 在 Kubernetes 上构建“智能体生成器”:智能体是 YAML 自定义资源,由控制器转为运行 Pod。作者使用本地模型 qwen3-coder:30b,通过工具白名单、人工审批和 RBAC 三重防护,让智能体根据自然语言描述生成并部署新智能体。文末指出身份、成本与治理才是真正难点,需在智能体前加治理层。
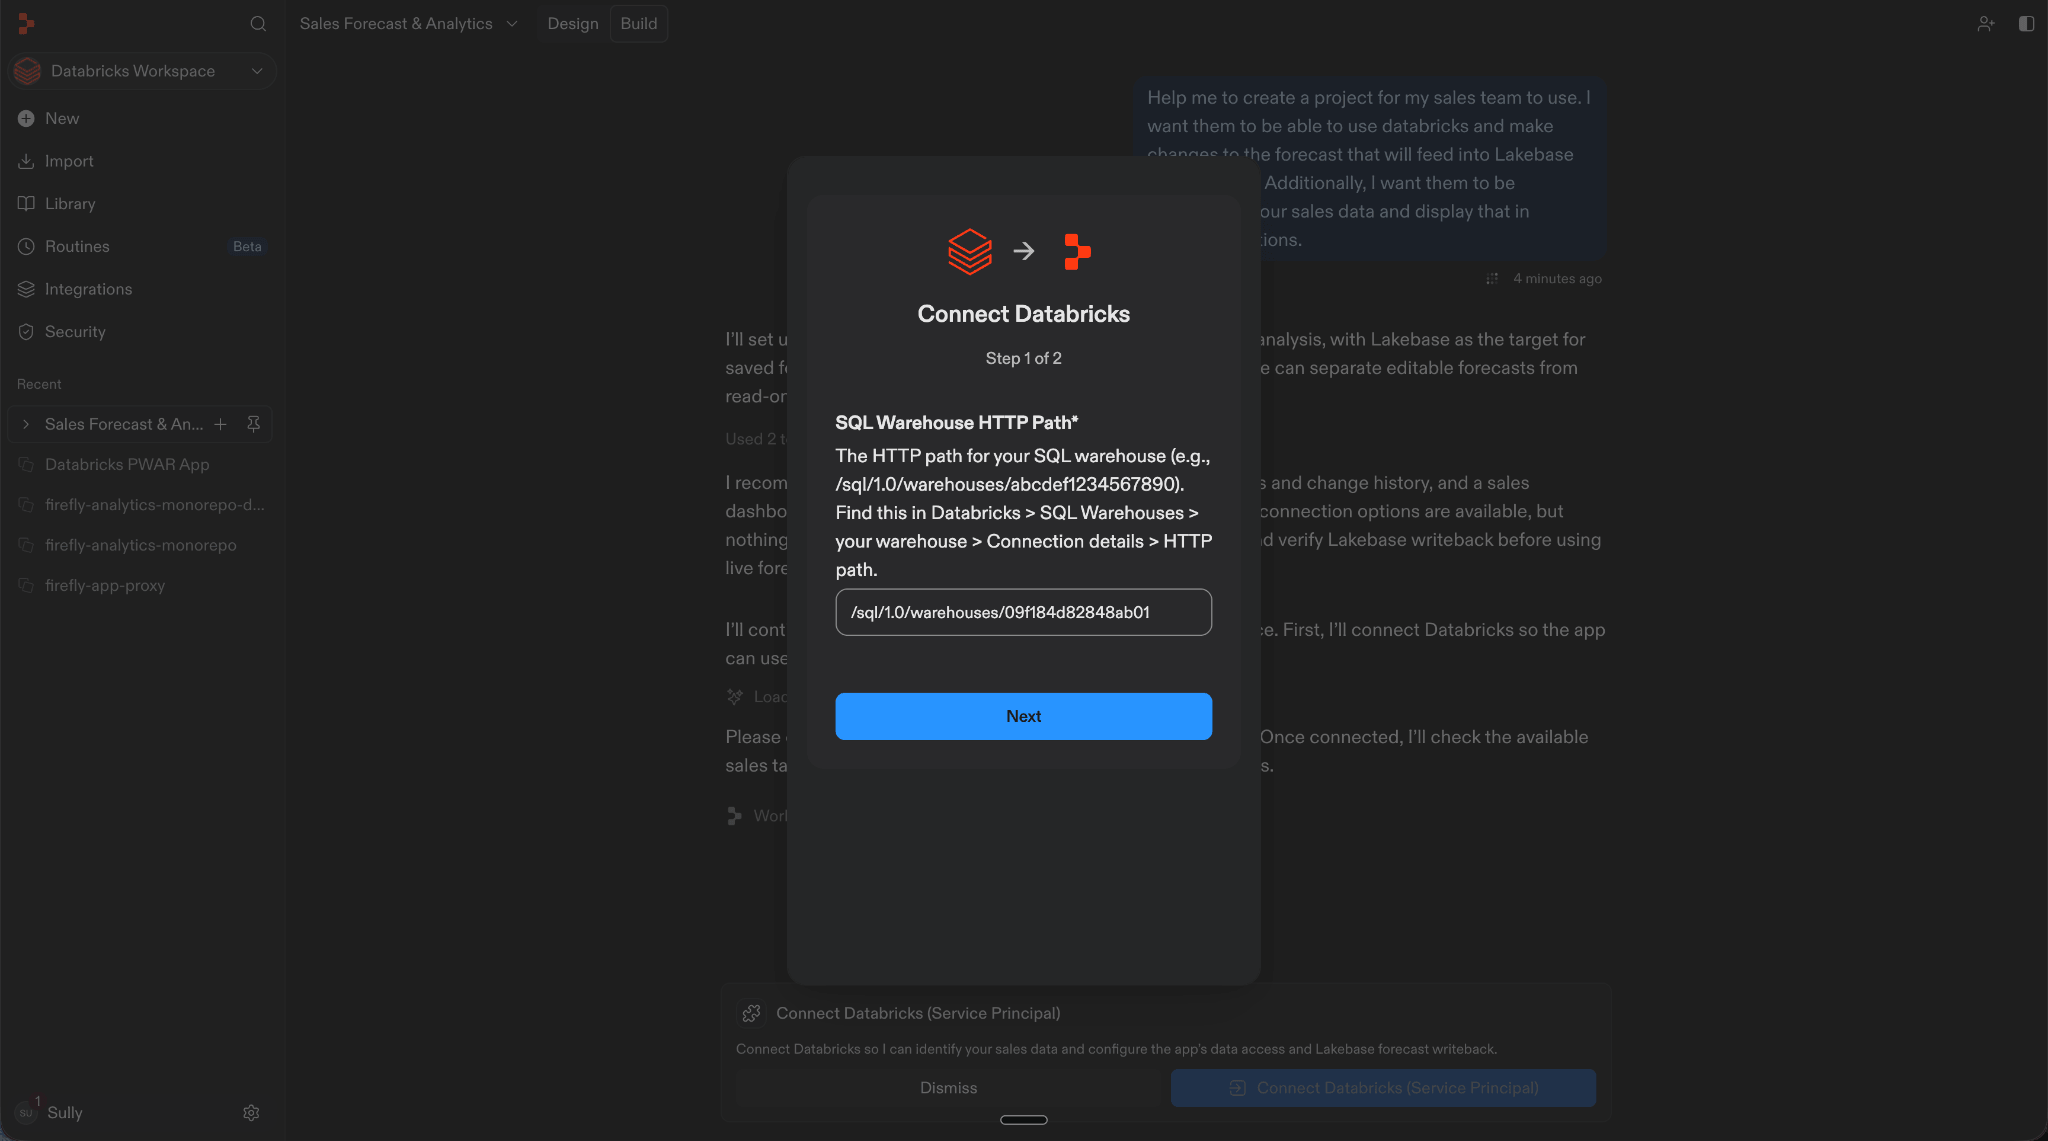
Replit与Databricks集成正式发布,支持Lakebase。企业用户可通过Replit Agent以自然语言构建受治理的应用并部署至Databricks Apps,应用自动继承Unity Catalog权限与身份验证,并自动配置Lakebase Postgres存储运营数据,无需外部数据库。适用于绩效管理、文档处理、工作流自动化等场景。入门需Replit企业版,约15分钟完成四步配置。
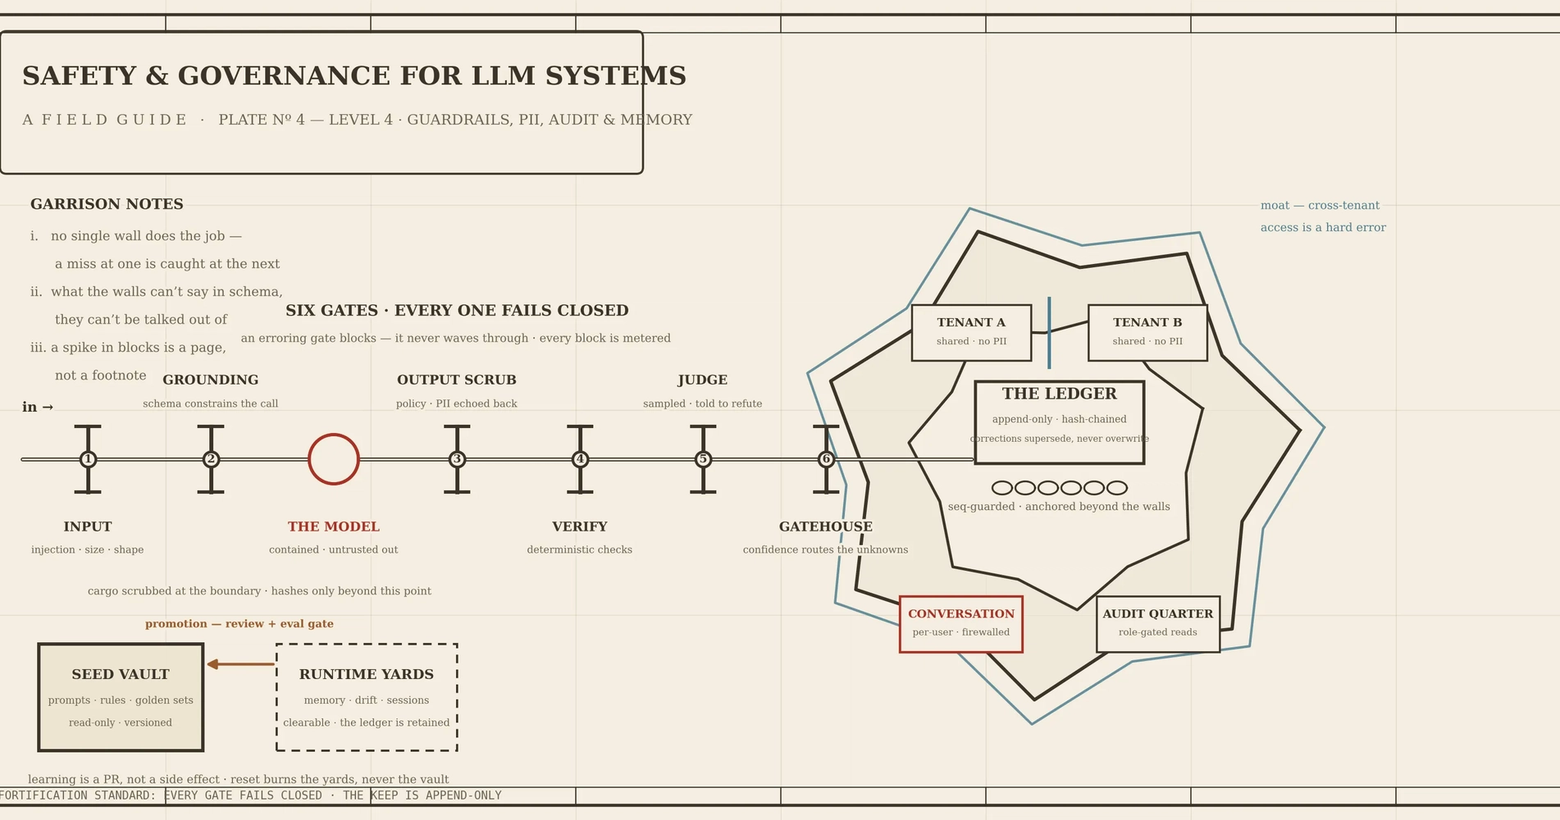
LLM生产系统成熟度模型第四级聚焦安全与治理,核心为四层防护:护栏分层且失败即阻断;输入输出边界处脱敏PII,并用HMAC哈希替代原始存储;审计账本仅追加、哈希链防篡改;记忆按租户和用户分类隔离。同时区分随版本发布的种子配置与运行时积累状态,重置仅清运行时,学习须经评审合并。
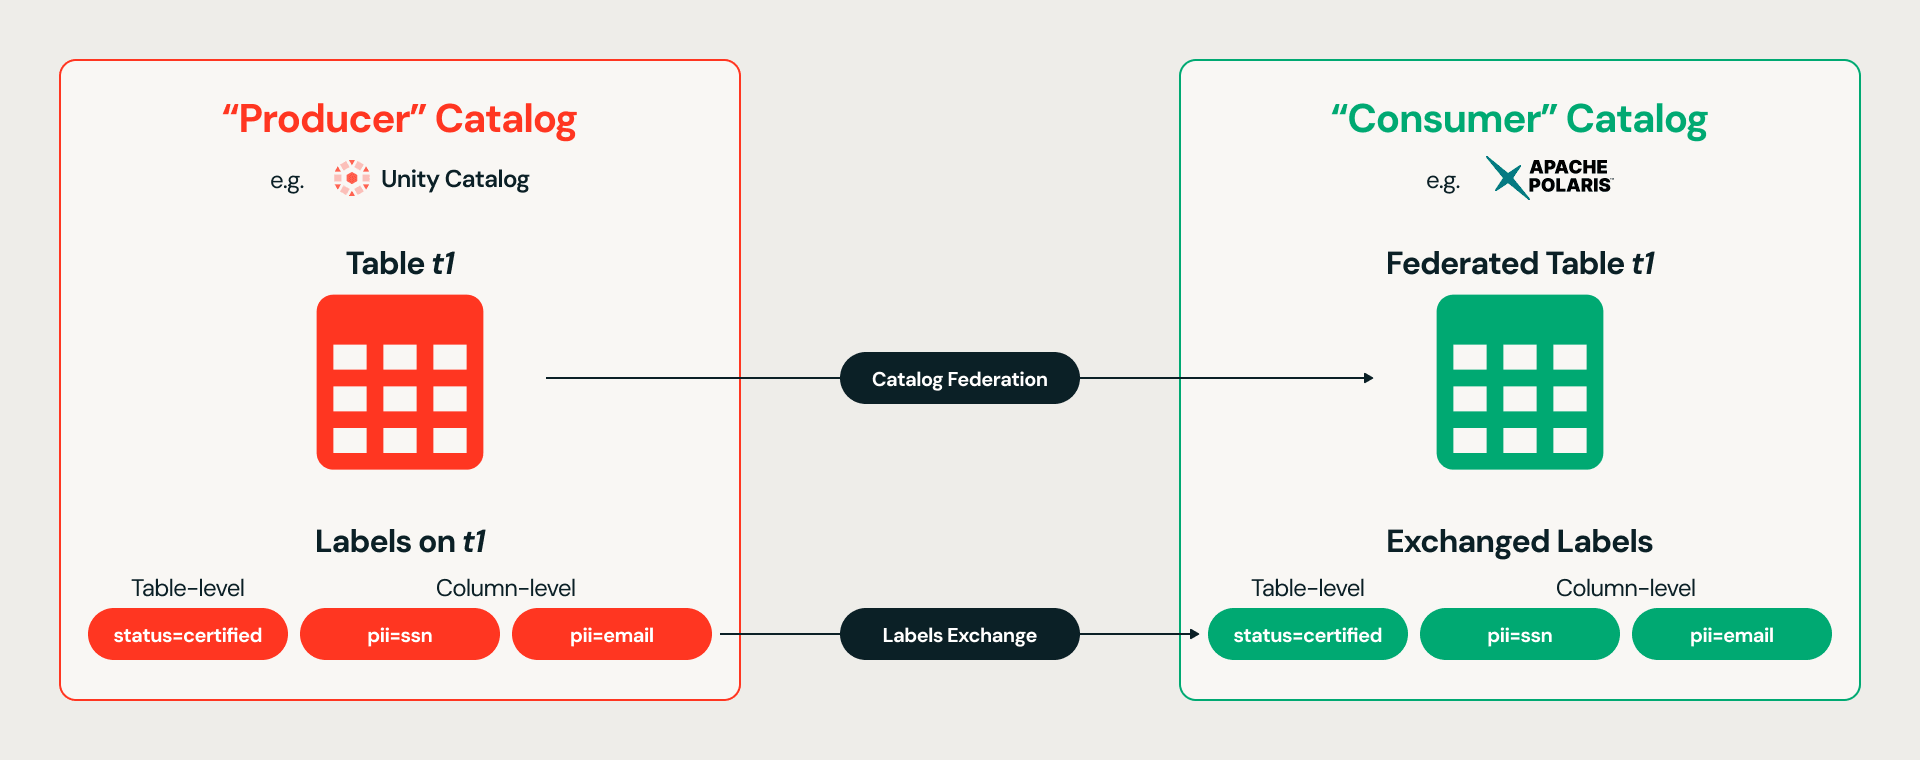
Apache Iceberg社区新增读取限制和目录标签两项REST目录规范。读取限制支持目录向受信任引擎下发过滤和掩码,适用于引擎直连目录;目录标签通过键值元数据在异构目录间传递治理信息,由消费方本地执行,适用于目录联邦。两者与集中式执行共同实现跨引擎、跨目录的统一治理。
Databricks推出AI函数ai_decide,基于决策模型而非LLM,能快速低成本地对文本做分类、评分和选择,适用于模型路由、文档处理、智能体评估等场景。它支持SQL和REST API,可在秒级内返回决策,适合实时应用,目前已开放Beta测试。
微软于9月29日发布WSL Containers正式版,开发者可通过wslc.exe直接构建和运行Linux容器,并接入VS Code、Intune与Defender治理。Compose支持仍在路线图中,网络与文件性能有待优化。建议先以无状态嵌入服务试点,固定镜像摘要,验证健康检查、日志、网络与回滚,再考虑团队迁移。
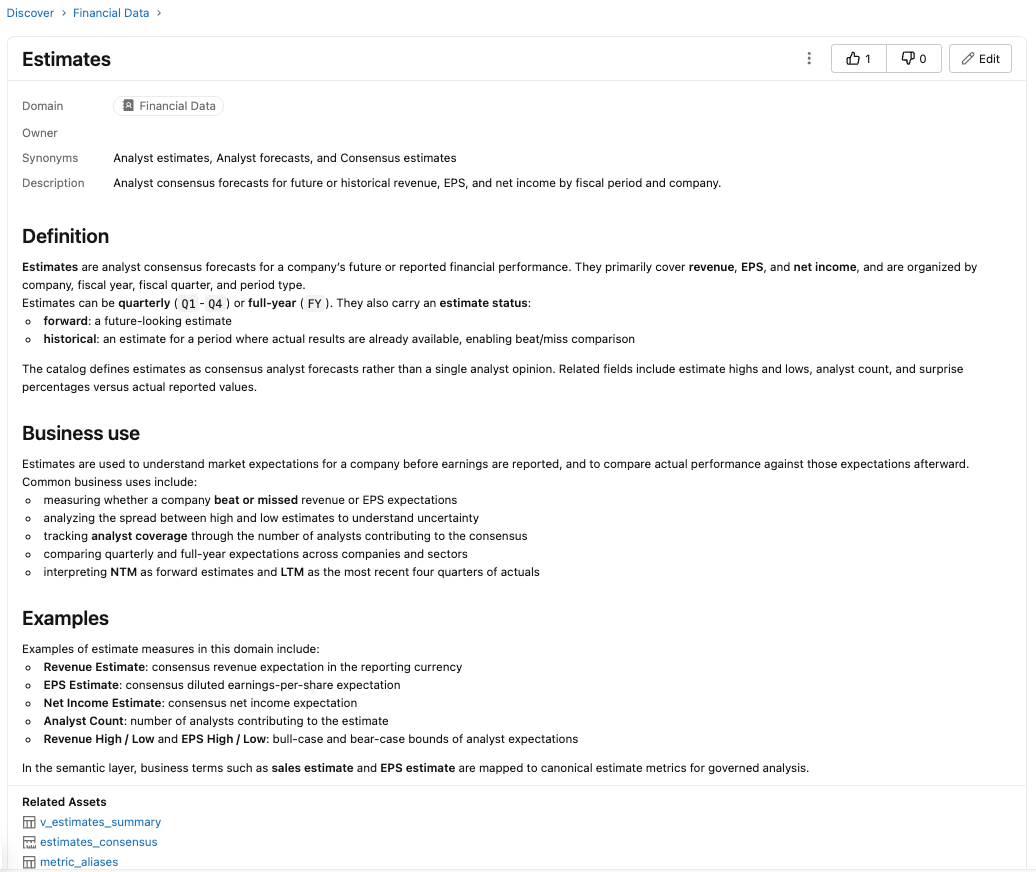
Databricks推出Unity Catalog Pages,作为Genie Ontology的人工策展层,允许数据管理员定义企业术语的权威含义供AI代理使用。Pages结合结构化字段与丰富内容,可关联数据资产,并支持Genie Code从Confluence等来源批量导入生成,确保AI基于可信业务上下文回答。目前处于Beta阶段。
Django社区批准DEP 19,实施新技术治理,旨在简化结构、便于参与。新指导委员会资格标准鼓励更多社区成员参选。下一步更新文档,DEP进入最终状态。
联络中心AI治理应作为现有CX框架的延伸,明确数据使用、模型行为、客户披露与人工监督。核心支柱包括决策权、基于风险的政策和可审计证据。落地需登记AI系统、分级管控、审批数据访问与披露规则,并持续监测模型全生命周期,从而在扩展AI的同时保障客户信任与合规。
资本市场公司正推动交易生命周期现代化,面临数据量增长、结算周期缩短等压力。核心挑战是研究、交易、风控、运营与合规各自为政,数据割裂拖慢决策。AI的价值不在模型本身,而在于打通并治理专有数据。建议从高价值工作流入手,建立可复用数据基础,再逐步扩展。
系统集成商选AI平台应关注多模型接入、应用集成、私有化交付与权限治理闭环,而非模型参数。模力方舟提供Serverless API、私有化部署和智算一体机三种路径,支持Kimi、GLM、DeepSeek等模型。选型需优先验证企业级交付与治理能力,并以PoC实测为准。
完成下面两步后,将自动完成登录并继续当前操作。