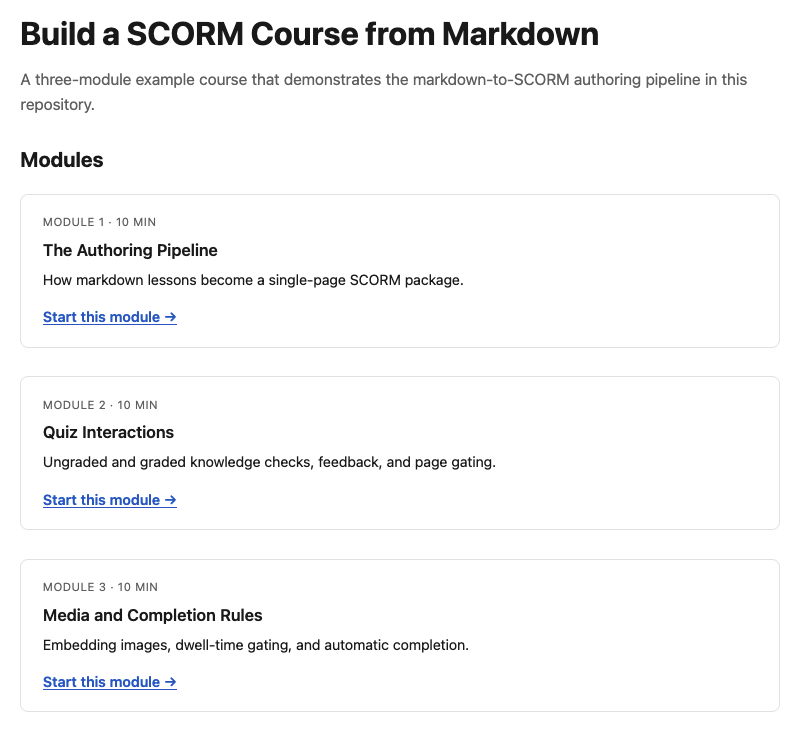
本文介绍如何用Kiro(含IDE和CLI的智能体AI)自动化将原始培训材料转换为符合SCORM 1.2标准的课程包并上传至LMS。流程分为课程开发与构建两阶段:规划并生成course.yaml清单、编写各模块的lesson.md、检查结构问题、渲染打包、验证zip文件。该流程借助Steering(持久上下文)、Specs(规范开发)和Hooks(自动触发检查)实现,用户只需通过对话即可在几分钟内获得可上传的zip包,且相关经验可版本化复用。
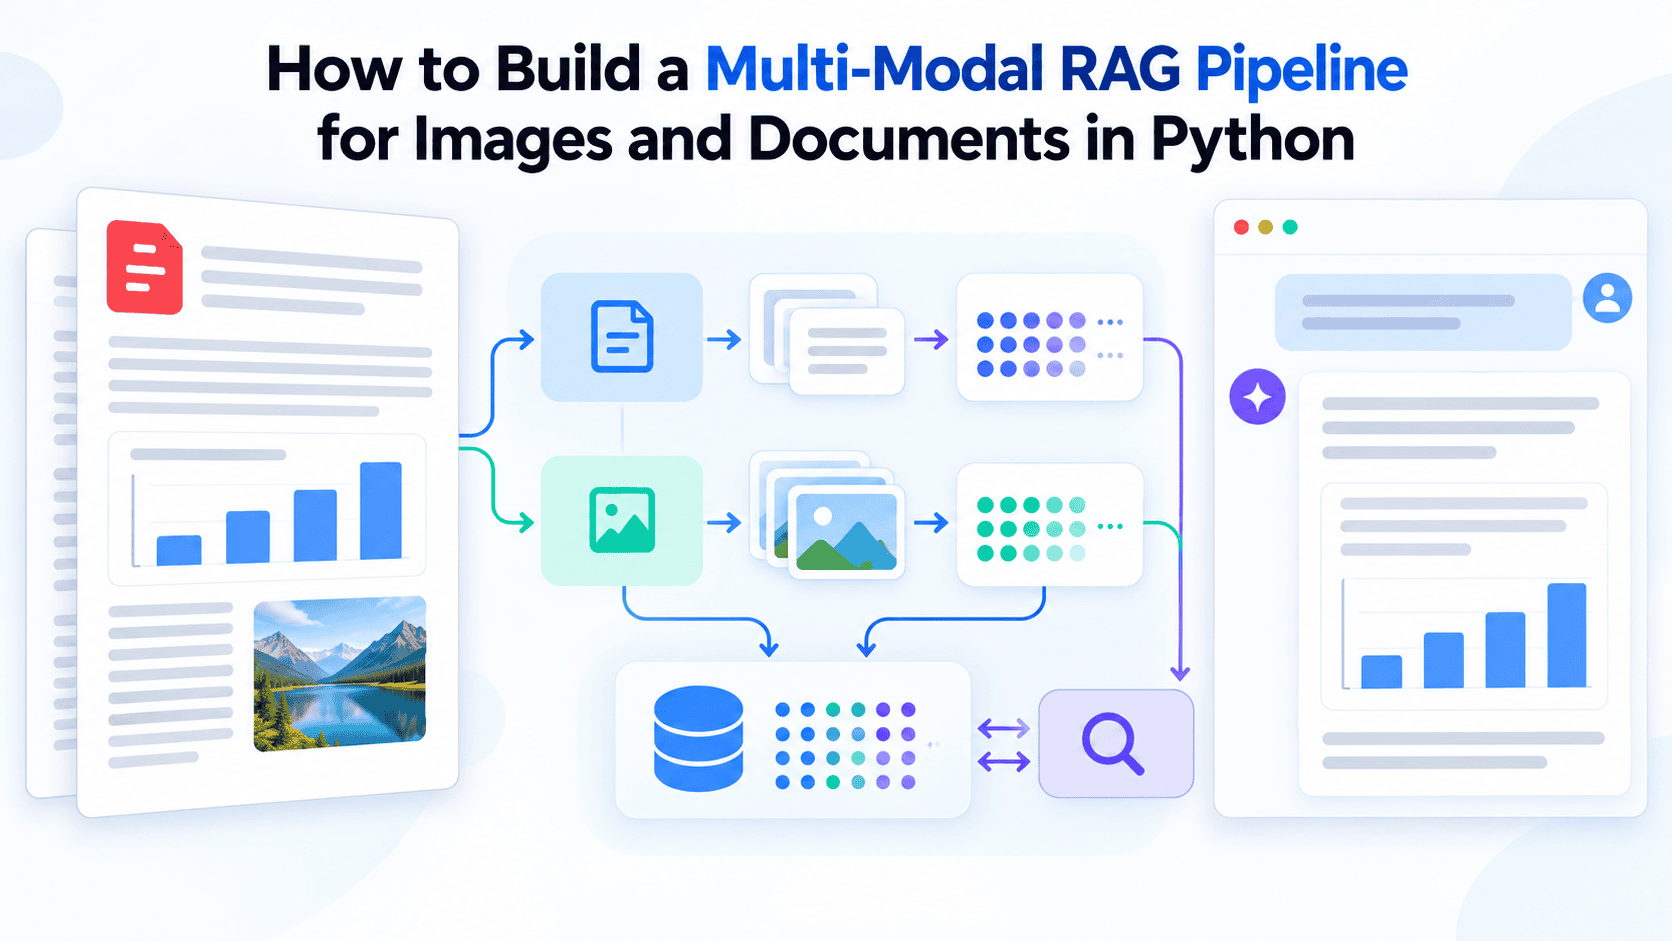
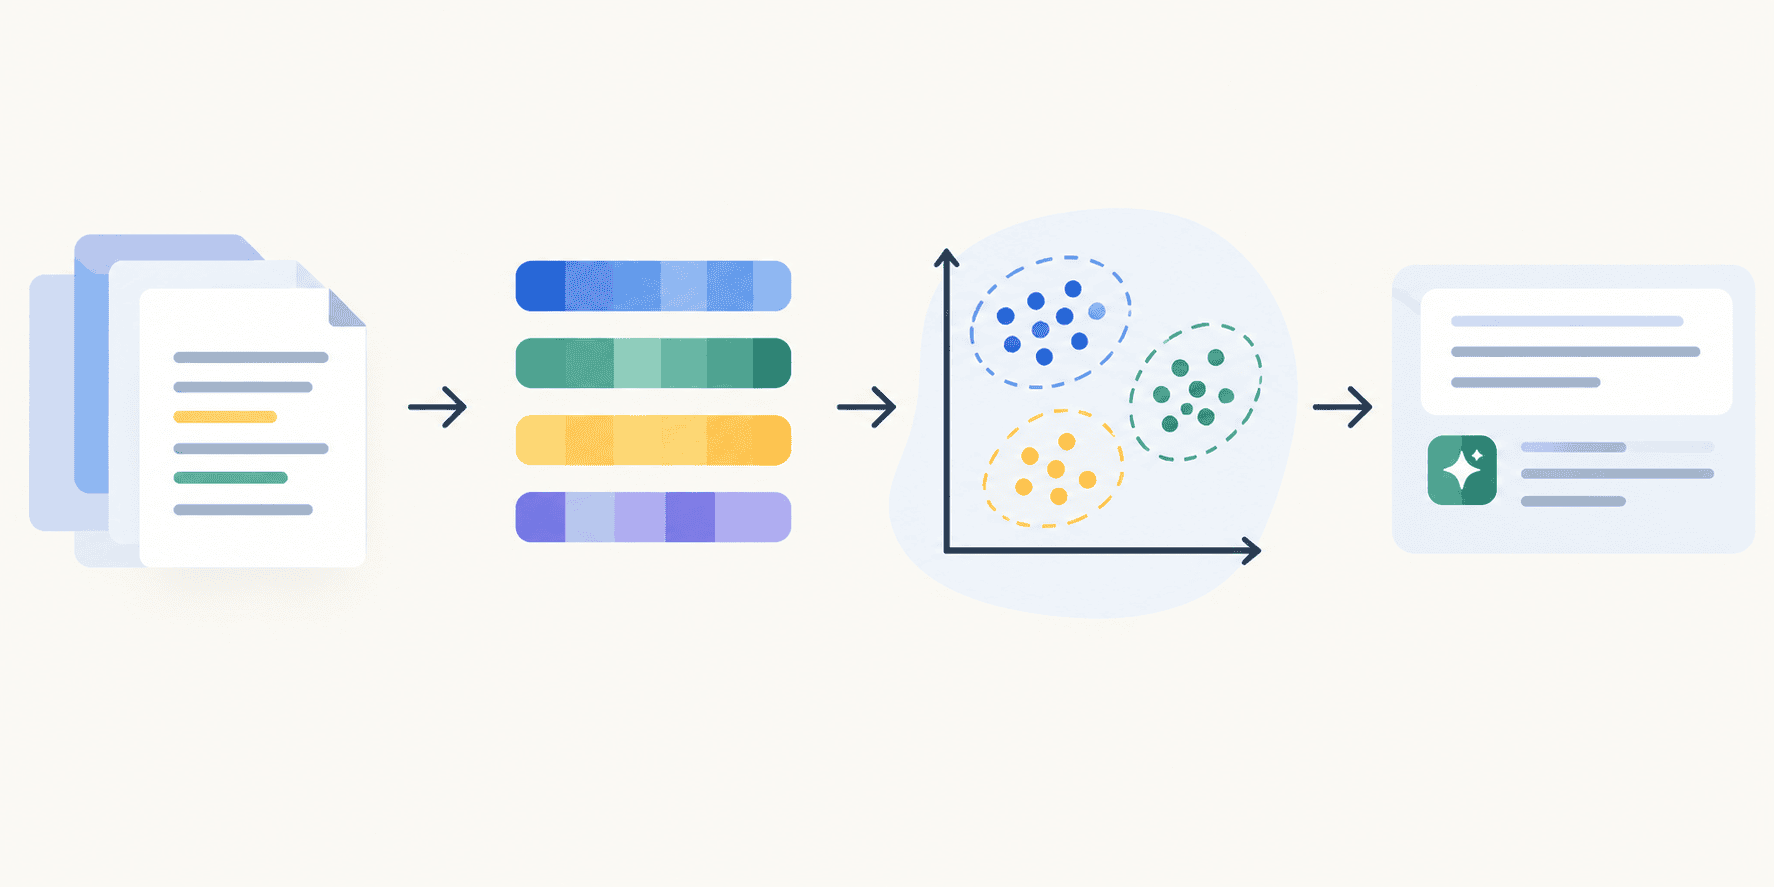
本文介绍用Python构建多模态RAG流水线以处理含图表和图片的复杂PDF,流程分四步:用unstructured库将PDF解析为文本块和图片;用GPT-4o为每张图片生成可检索的文字摘要;用MultiVectorRetriever建立向量库与文档库双存储,以ID关联摘要与原始内容;查询时检索文本和图片摘要,将原始图片与文本一并传给GPT-4o生成有据可依的答案。该方案适用于研究报告、财务文档等图文混排文件。
Qodana将IntelliJ IDEA的代码分析能力集成到CI/CD流程,支持GitHub Actions、GitLab、TeamCity、Jenkins、Azure Pipelines和CircleCI六大平台。通过自动化质量门禁,在每次提交和拉取请求时检查代码质量,实现“左移”策略,帮助团队及早发现问题、统一编码标准,防止问题代码进入生产环境。
CI/CD流水线可观测性通过构建结果、指标、日志和追踪来理解交付流程状态。文章介绍了应关注的指标(如队列时间、成功率、代理利用率),并对比了内置仪表盘、Prometheus/Grafana、日志工具、OpenTelemetry及商业平台等方案,建议从现有问题出发,用真实场景评估工具。
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
AI编程导致CI成为瓶颈:代理并行工作使PR量激增,Anthropic的CI任务半年增25倍。但CI仅验证单个代码库,无法发现分布式系统中跨服务边界的故障。DORA数据显示,AI采用率越高,交付越快但越不稳定。解决之道是在代理循环内、提交PR前,用共享Kubernetes集群上的轻量测试环境对真实系统做验证。
Cloudflare发布开源工具Forge,用于自动生成SDK、CLI和文档。其API拥有超3500个操作且跨多语言,原有工具难以应对。Forge可在CI中运行,每次改动生成预览,支持链式转换,能生成Cap'n Web、MCP等。采用Apache 2.0许可,免费开放,未来将支持多语言SDK及API版本管理。
文章以 OpenVINO 2026.4 等版本发布为引,说明模型权重需经导出、优化、量化、运行时加载与输入输出适配才能在本地运行,并介绍 IR、NNCF、GenAI 等组件的作用,给出 CPU 文本生成的最小实践。文章还指出四大误区:导出成功不等于可用、低精度未必更快、内存不足并非仅由权重导致、依赖需锁定版本,强调应固定版本并建立质量基线。
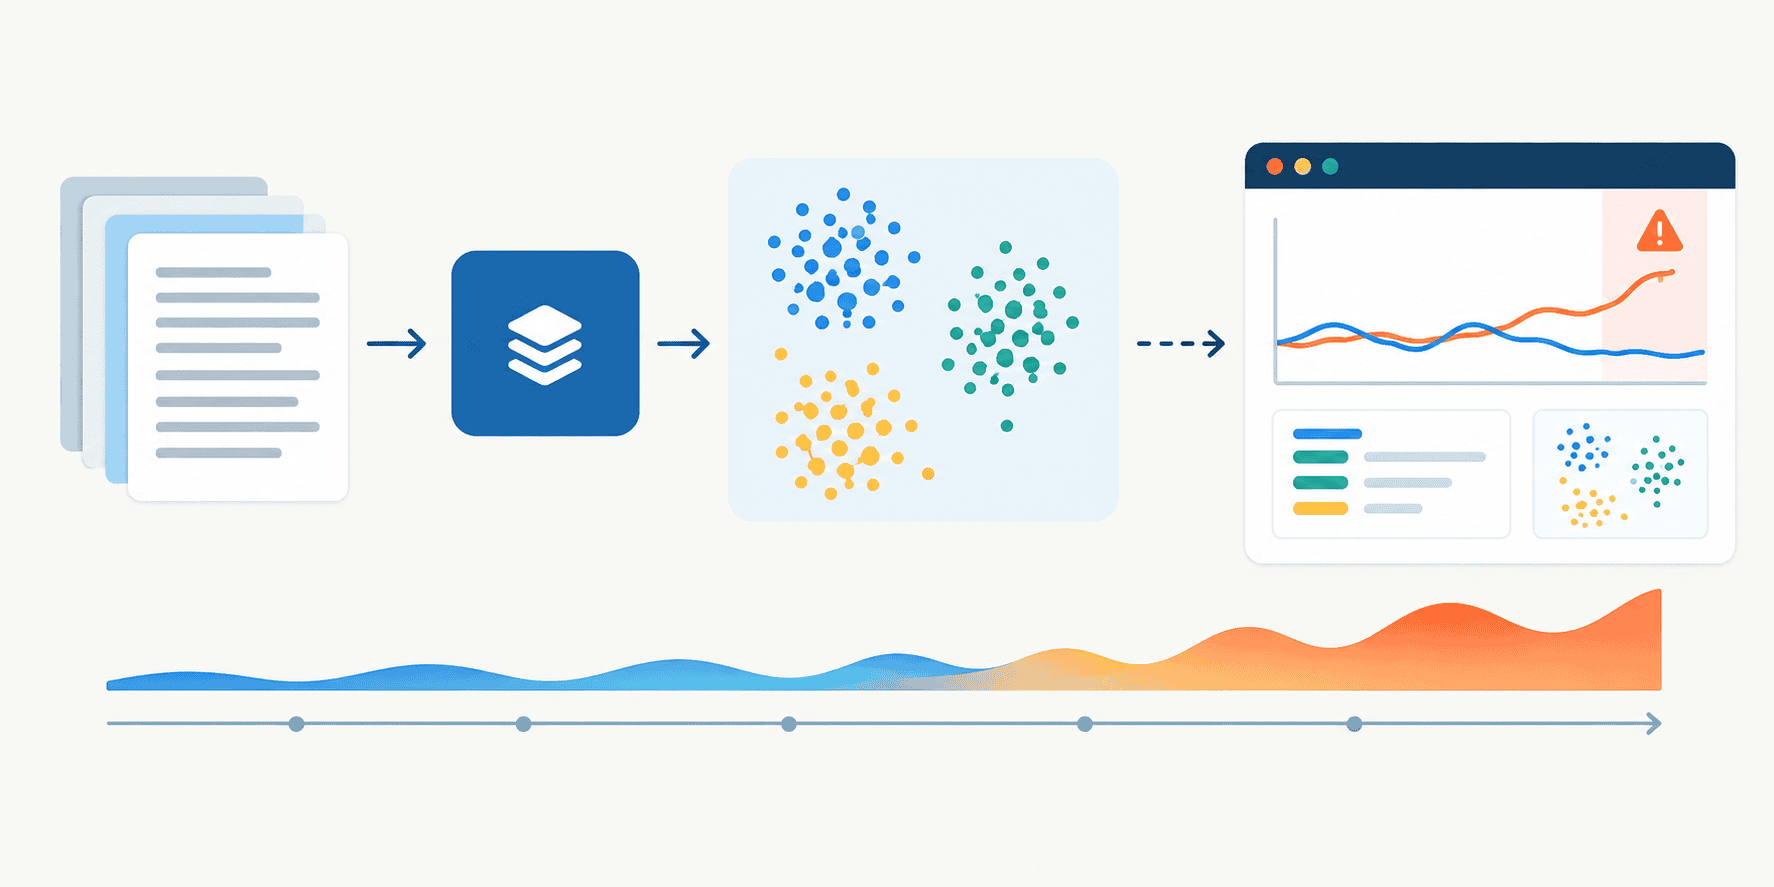
本文介绍生产环境中LLM嵌入漂移的检测方法,重点讲解两种技术:基于模型的检测(训练随机森林分类器区分基线与生产嵌入,ROC-AUC超阈值即告警)和质心距离法(计算两组嵌入质心的余弦距离)。文中用模拟384维嵌入及Scikit-LLM结合SentenceTransformer生成的真实文本嵌入演示,均成功检测到漂移。
Jev 是专攻封闭选项判断的轻量决策模型,采用五要素决策模板和五步流水线,在分类匹配路由任务中大幅降低成本:两万条邮件分类仅需 1.45 美元,而 GPT-4o 需十几美元。其核心是让 Jev 只做选择题,输出 token 压缩至一两个,并明确代码、Jev、大模型、人工四角色边界。但 Jev 标签准确率仍在评估,生产环境长期数据尚缺。
NVIDIA推出BioNeMo推理运行时,通过内核选择、CUDA Graph和Ray流水线优化蛋白结构预测。在8张H100上,Boltz-2吞吐达每GPU小时5.85万残基,较公开实现提升2.9倍。文章强调科学AI吞吐应以成功结构数和完整流程时间衡量,需关注CPU预处理、写盘和失败率等瓶颈。
本文介绍轻量开源CI/CD工具Woodpecker,它源自Drone,用Go编写,包含Server与Agent,并复用Gitea等代码托管平台的认证。文章演示了用docker-compose部署Gitea、Woodpecker Server与Agent,编写Hello World流水线,并以Python项目为例,完整实现提交、测试、构建镜像、SSH自动部署的流程,同时介绍了when触发条件、Secrets、缓存及woodpecker-cli本地试跑等用法。
本文介绍轻量开源 CI/CD 工具 Woodpecker:源自 Drone 分叉,采用 Apache 2.0 协议,用 Go 编写,架构分 Server 与 Agent。文章演示在 Linux 上用 docker-compose 部署 Gitea、Woodpecker Server 和 Agent,配置 OAuth 登录,编写 Hello World 流水线,并以 Python 项目为例实现提交、测试、构建镜像、SSH 自动部署,同时介绍缓存、密钥管理与 woodpecker-cli 的用法。
LLM应用输出不确定、无唯一答案且失败隐蔽,传统测试方法失效。文章提出三层评估体系:确定性检查(格式、长度、幻觉链接)、LLM评审(按评分标准打分)、人工评估(定期校准),并介绍黄金数据集、回归测试和统计显著性检验,建议从简单检查起步,逐步构建完整评估流水线。
Omarchy是一款基于Arch和Hyprland的键盘优先Linux桌面系统,由DHH创建。其生产流水线、构建、PR审查和QA测试现迁移至DigitalOcean运行。DigitalOcean成为Omacom基金会创始企业赞助商,并担任其代理计算提供商。双方计划推出1-click Omarchy Droplet,便于开发者快速部署。
本文介绍流水线并行中气泡的产生与优化。将模型按层切段、批次分微批后,段间等待形成气泡。四代调度各改一点:GPipe先全前向再全反向,显存高;1F1B改交替执行,减少在途激活;Interleaved 1F1B切细段降气泡,但增通信;Zero Bubble拆反向填气泡。气泡占比约(P−1)/m,显存峰值随段数变化。
本文提出一种集成式“扩大-剪枝”流水线,用于生成式语言模型预训练。该方法将扩大模型训练、剪枝和恢复整合到单一余弦退火学习率计划中,并引入迭代结构化剪枝,以缓解知识损失并优化神经元容量分配。实验表明,在将2.8B模型压缩至1.3B(预训练达2T tokens)时,该方法提升了剪枝模型的性能,并揭示了扩大预训练的token效率优势。
本文介绍了一个基于Kairos不可变Linux发行版的Kubernetes管理集群升级流水线。通过Gitea、Renovate、Kyverno、Cosign、ArgoCD和kairos-operator六种工具,实现全自动滚动升级,零人工干预,11分钟内完成三节点升级,无中断。文中还提到修复了并发升级bug和Renovate模板字段问题,并计划扩展至网关集群。
《知识就是力量》杂志社与360科技集团联合发布“知力·纳米”科普科幻AI大片创作平台,结合权威科普内容与AI视频技术,面向学校、科研机构等,提供从剧本到成片的完整创作链路,推动科普内容生产专业化、生态化,助力科学知识更生动传播。
本文比较了Redis与专用向量数据库(如Pinecone、Milvus、Qdrant)及pgvector的优劣。Redis作为统一实时平台,整合向量搜索、语义缓存、会话管理等功能,可降低基础设施复杂性和LLM成本,适合混合工作负载。专用数据库在超大规模或特殊调优时更优,pgvector适合小规模场景。选择取决于架构需求、运维能力和成本考量。
完成下面两步后,将自动完成登录并继续当前操作。