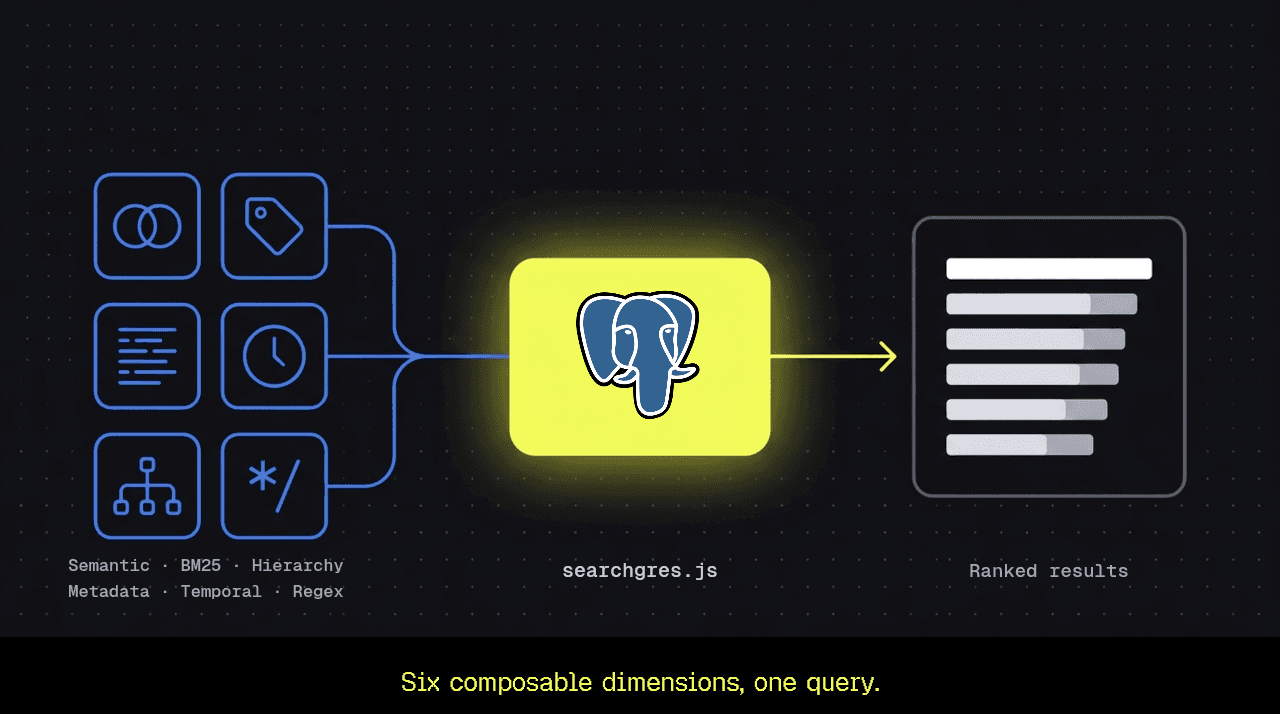
searchgres.js 是一个采用 Apache-2.0 许可的开源 TypeScript 库,用于在 PostgreSQL 中实现可组合搜索。它支持在单条 Postgres 查询中组合 BM25 关键词检索、语义排序,以及按层级、元数据和时间过滤,从而简化混合搜索的实现。
该课程介绍如何在 PostgreSQL 内构建生产级混合搜索,无需 Elasticsearch 等外部集群。它结合关键词匹配与向量语义检索,用 RRF 在 SQL 中合并排序结果,并以 24 万篇维基百科文章为例,演示 BM25 排序、pgvector 存储 384 维嵌入、查询计划分析,以及 Python、FastAPI 和 Psycopg 后端实现。
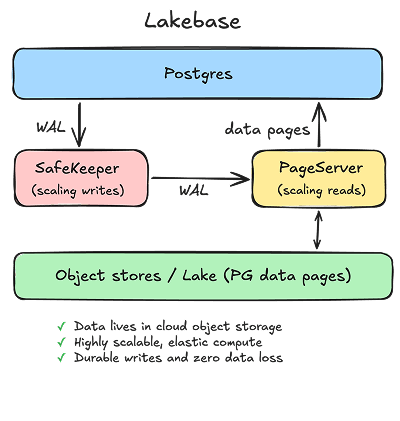
Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
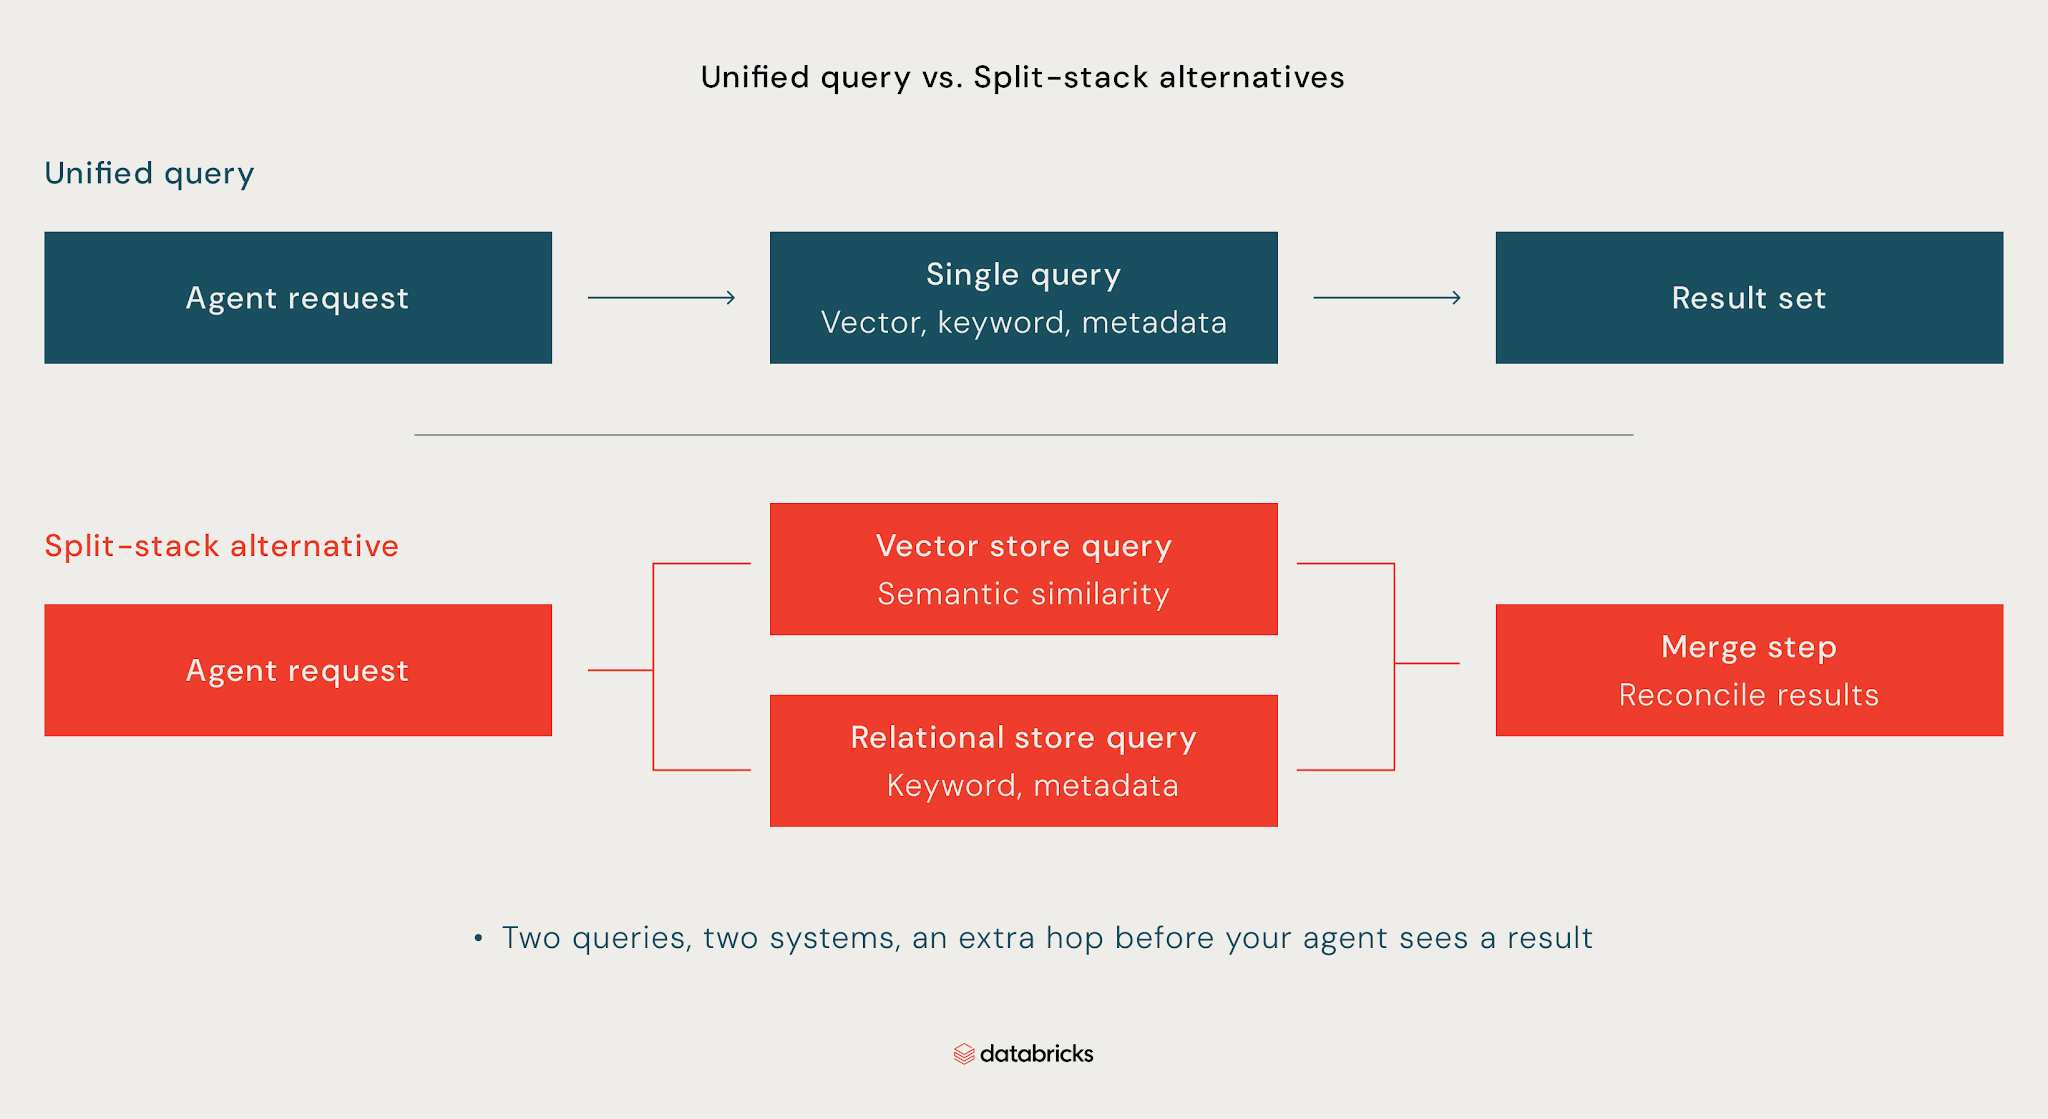
评估AI代理数据库的五大标准:分支隔离、无服务器扩展、混合搜索、ACID保证和统一平台访问。代理需跨会话持久化状态与记忆,支持并发读写;传统数据库易致记忆过时、写入冲突和高延迟。混合搜索结合向量、关键词与元数据过滤,检索需低于100毫秒。多代理共享数据时,事务隔离与原子提交至关重要。统一平台让运维与分析共用同一数据,避免ETL延迟。
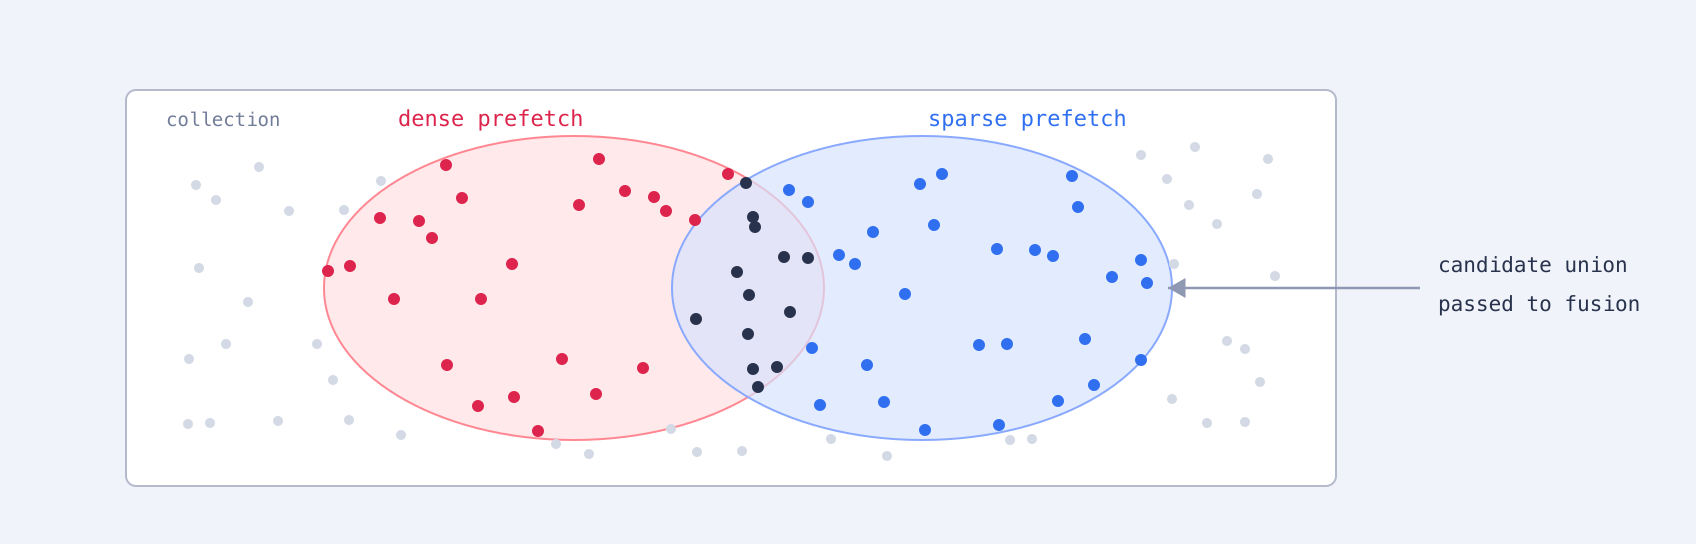
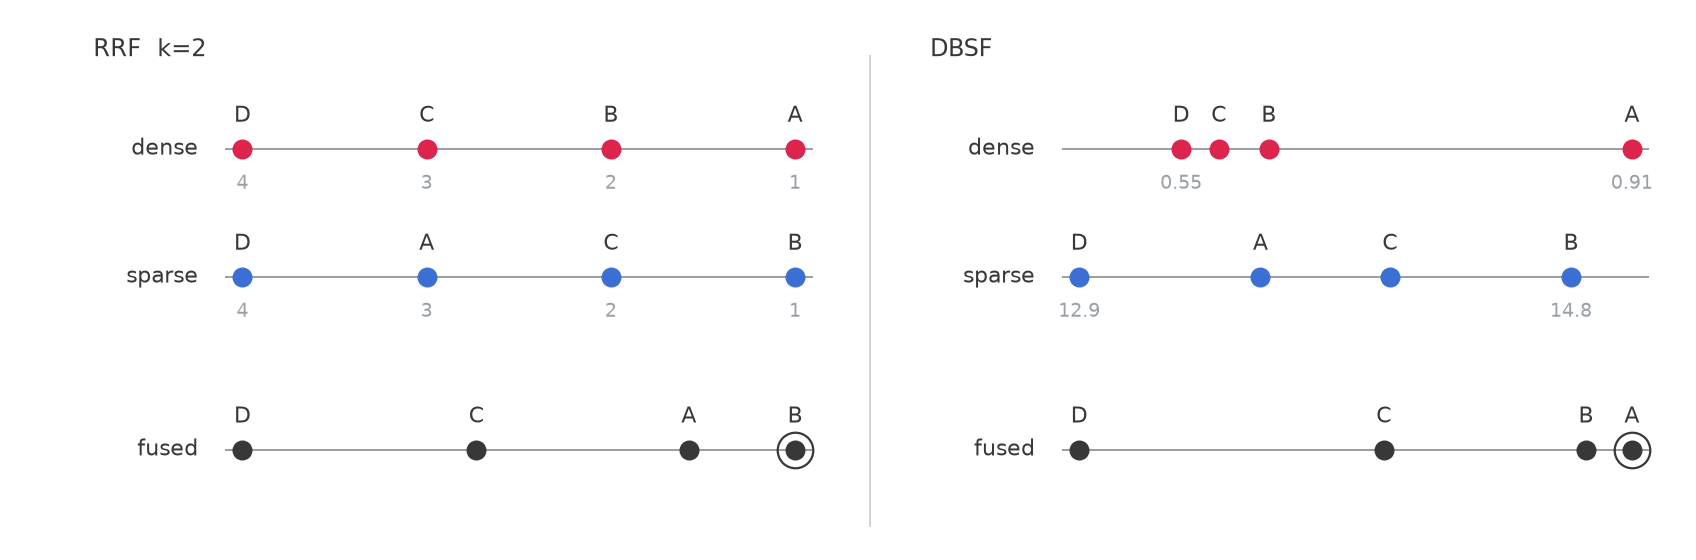
混合搜索结合稠密与稀疏检索,兼顾语义相似与精确词匹配。稠密检索擅长同义改写,稀疏检索(如BM25)擅长标识符和专有词。融合方法中,RRF按排名合并以避免分数尺度差异,DBSF则归一化分数。在五个公开数据集上,默认RRF在四个上优于单一检索器。但混合搜索增加存储、索引和查询延迟,需实测收益是否值得成本。
本文介绍Qdrant中混合搜索的调优方法。混合搜索结合稠密与稀疏检索,通过融合算法排序。调优前需确认融合优于单一检索,并比较RRF与DBSF融合方法。根据查询相关文档数量选择k值,最后调整权重。需在保留查询集上验证配置,确保效果稳定。调优顺序:确认融合优势、选择融合方法、设定k值、调整权重、验证结果。
本文介绍Qdrant混合搜索的调优方法:混合搜索融合稠密与稀疏检索结果,需先用nDCG@10验证融合是否优于单一检索;RRF仅用排名,DBSF利用分数分布,二者需在标注数据上对比;k值决定排名权重衰减,应按每查询相关文档数选择;权重最后调,并在留出查询上验证以避免过拟合。
调整Qdrant集合前,需明确检索目标(如排名、延迟或内存),并确保向量和负载索引正确。检查稀疏向量IDF修饰符和BM25平均长度等设置,避免无效结果。根据症状选择调整方向,如混合搜索或重排序。使用带标签的查询集和合适指标(如nDCG@10)评估,确保标签能检测改进,并在新查询上验证结果。
Redis 通过向量嵌入实现语义记忆搜索,存储和检索事实,使AI代理能跨会话记住用户偏好,避免重复提问。相比关键词搜索,它更擅长处理同义表达,但需结合混合搜索弥补盲区。快速检索和新鲜度至关重要,Redis 提供低延迟和更新机制,减少推理成本,提升用户体验。
本文介绍Postgres与pgvector实现混合搜索(向量相似度+标量过滤)的模式。核心问题是向量索引返回近似排序结果,无法直接与WHERE过滤结合。pgvector 0.8提供迭代索引扫描,但需权衡召回率与性能。其他方案包括:部分HNSW索引(适合低基数稳定过滤)、过采样后过滤(适合高基数)、缓存响应(适合重复查询)。文章还提供EXPLAIN诊断方法和选择指南。
pgEdge ColdFront新增混合搜索功能,在PostgreSQL内结合密集向量与BM25稀疏向量,通过RRF融合结果。支持精确术语匹配和概念查询,可调p_alpha平衡权重。在pgEdge集群中,嵌入自动复制,实现高可用搜索,降低存储成本。
文章讨论了“语义过载”对智能代理性能的影响,指出过多的语义内容会导致信息检索不准确。传统向量搜索无法有效处理事实之间的关系,影响代理在多轮对话中的记忆和推理能力。为此,提出了混合搜索、重排序、图检索和结构化记忆等方法,以提高信息检索的准确性和效率。Redis Iris被推荐为解决方案,集成了检索、记忆和新鲜度层,提升代理表现。
向量搜索是一种基于语义的搜索技术,通过比较文本和图像的嵌入表示来找到相关结果。它包括创建嵌入、构建索引和匹配查询三个阶段,适用于现代AI助手和语义搜索系统。与传统关键词搜索相比,向量搜索更能理解概念关系,支持多种格式和语言。混合搜索结合了向量和关键词搜索的优点,提升了信息检索的效率和准确性。Databricks平台支持这种搜索方式。
文章讨论了大型语言模型在信息检索中的发展历程。从最初效果不佳的向量数据库方法,到结合人类信息检索经验的混合搜索和机器学习排名,检索效果显著提升。当前,随着Perplexity推出“代码搜索”,搜索方式正在向更高阶段演进。文章强调,智能代理应具备更复杂的搜索能力,以提高检索结果的质量。
本文介绍了在RAG系统中实现混合语义-词汇搜索的方法,结合BM25词汇搜索与语义搜索,通过互惠排名融合(RRF)进行整合。混合搜索策略有效提升了检索效果,提供了Python实现的详细步骤,包括库的安装、数据集加载、BM25和语义搜索的独立执行及结果融合。通过示例查询,展示了混合搜索的优势。
视频内容的搜索和管理日益重要。视频管理系统能高效提取信息,适用于教育、电子商务和保险等领域。处理视频数据时,需优化预处理流程以分离视觉和音频信息。混合搜索方法结合图像嵌入和文本描述,提高检索效率。Vespa平台提供统一基础设施,支持多信号和多模态数据检索,增强视频搜索的灵活性和可扩展性。
文章讨论了在Postgres中应用混合搜索,结合传统全文搜索和向量搜索的优缺点,用户可以在同一数据库中高效检索信息,简化了使用多个数据库的复杂性。Postgres的pg_textsearch和pgvectorscale实现了这种混合搜索,提升了搜索体验和开发效率。
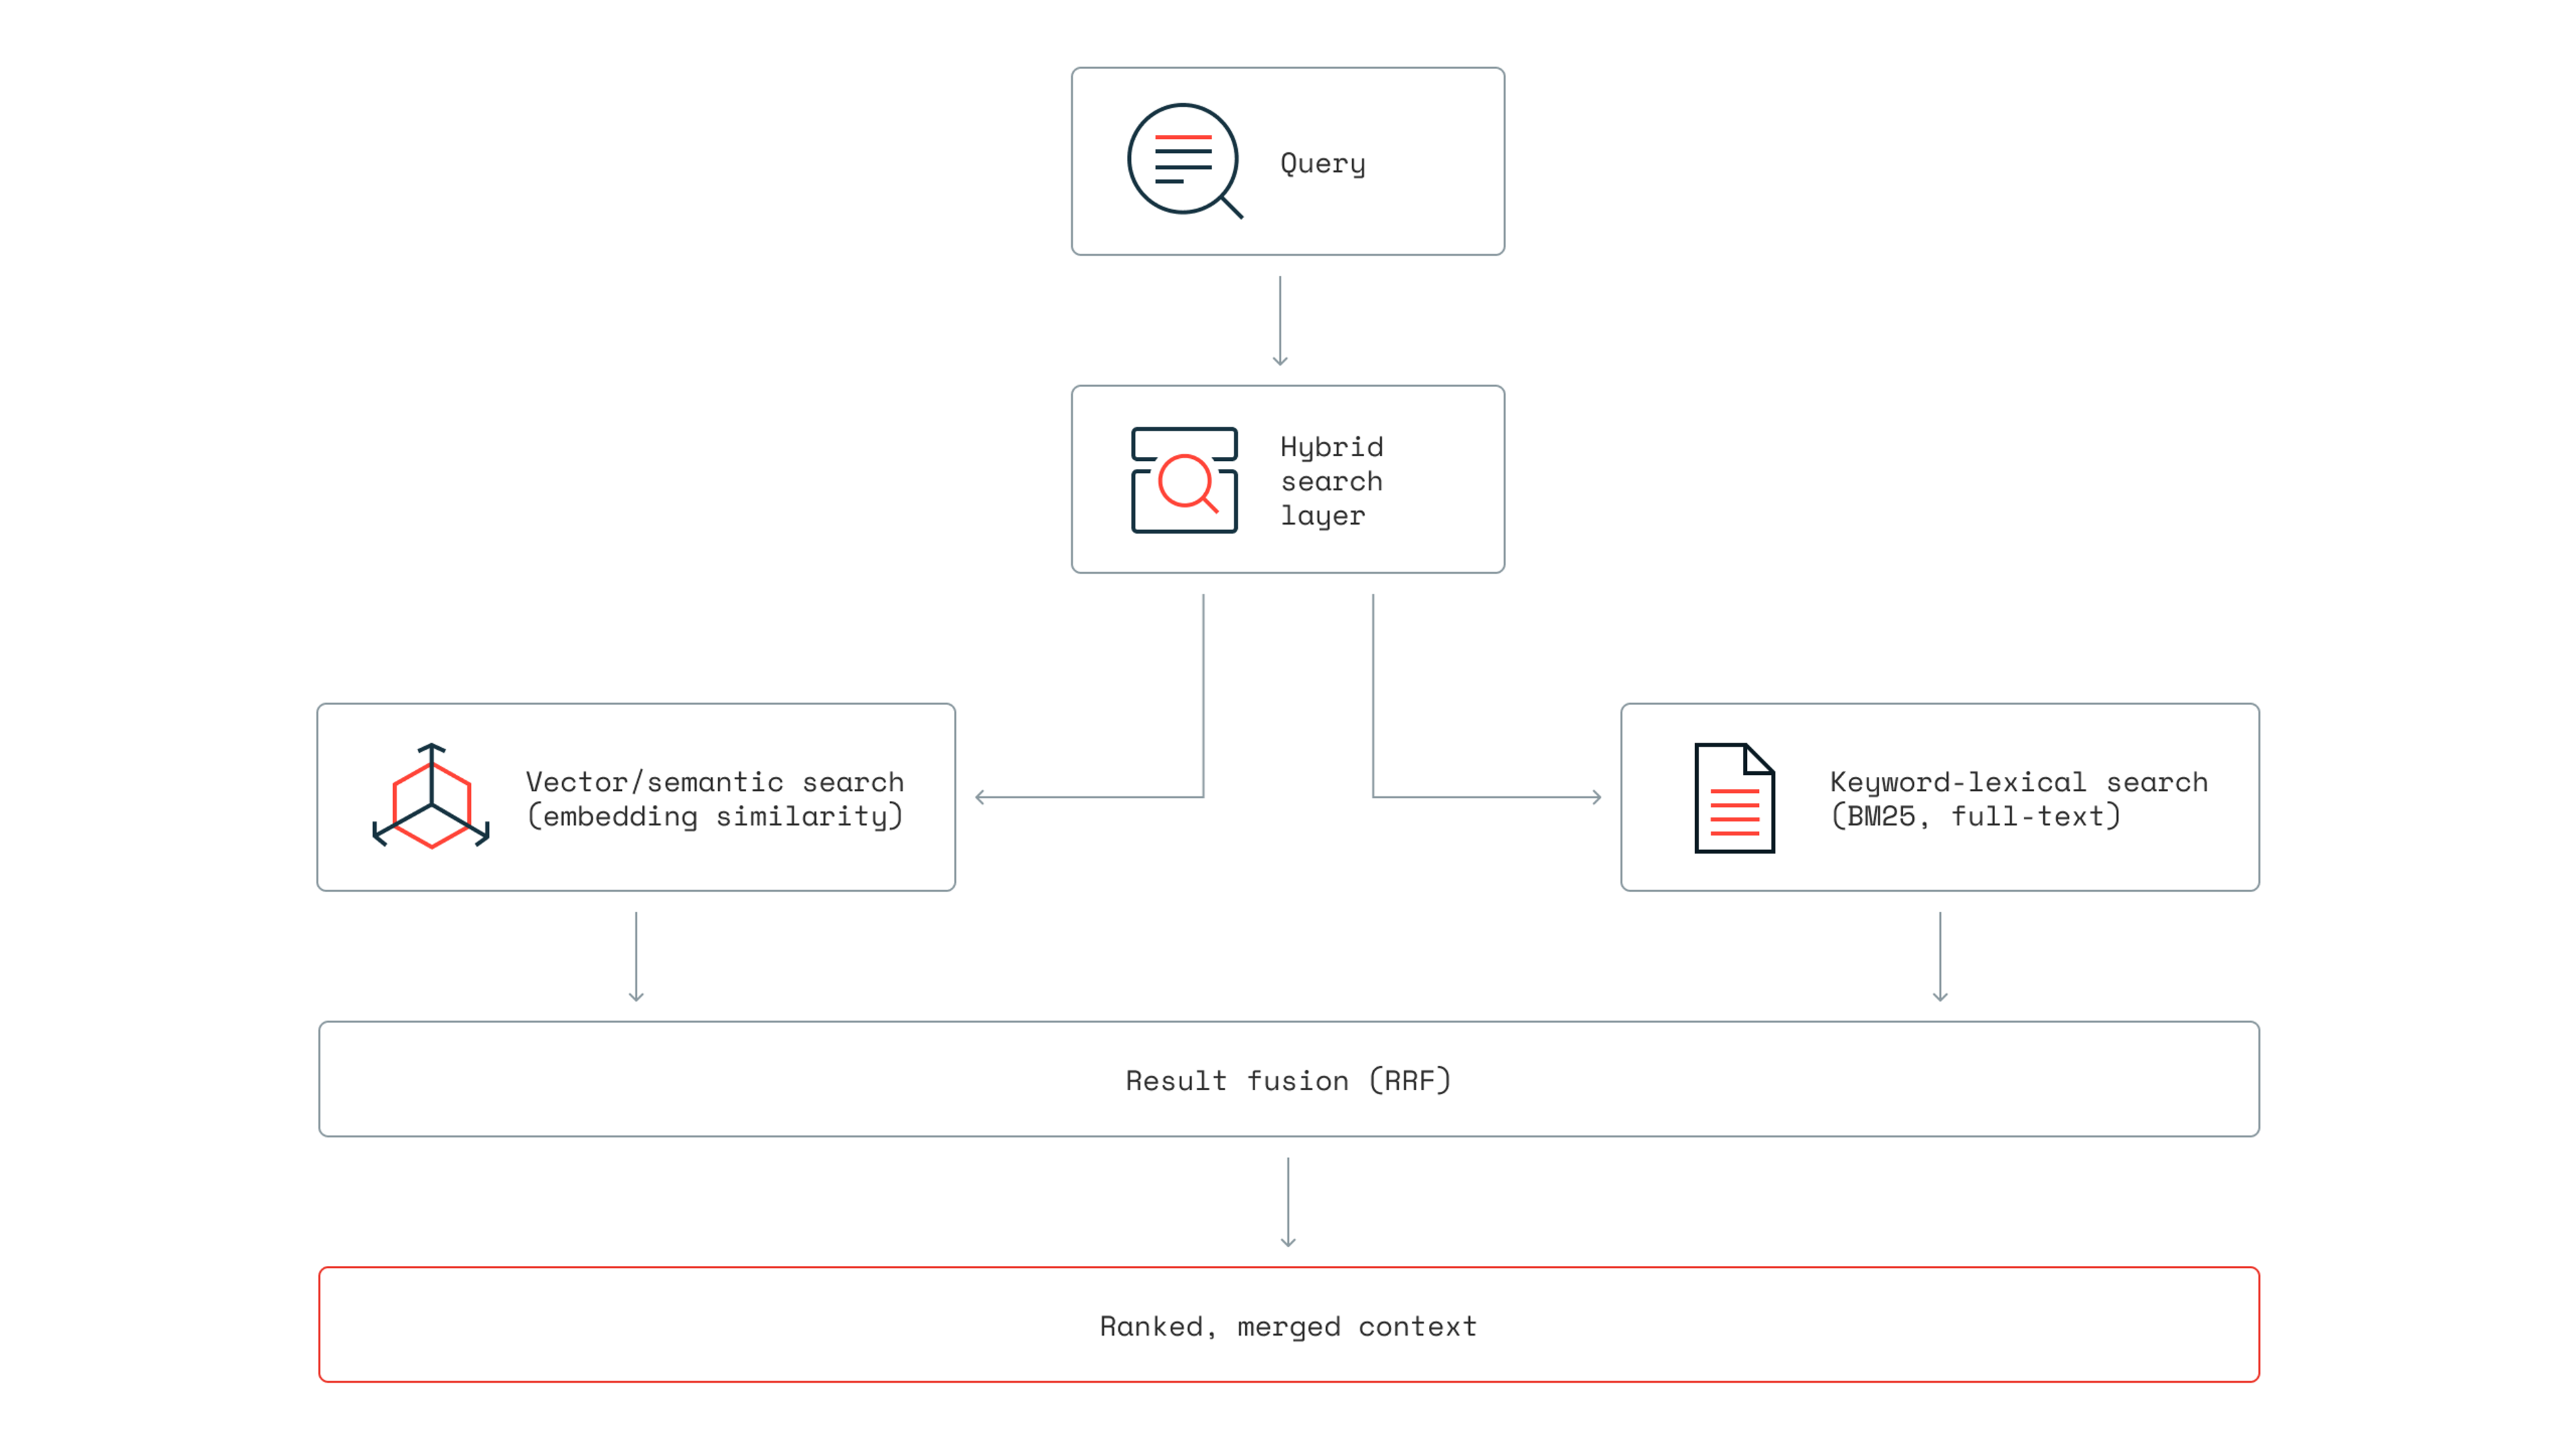
混合搜索结合了BM25和向量检索,克服了纯向量和关键词搜索的不足,提升了检索准确性,适用于技术文档及法律医疗领域。通过双路径处理,优化查询结果,降低LLM成本,提高上下文质量。Redis支持混合搜索,简化操作,适合构建RAG系统和智能代理。
向量数据库提升了语义搜索能力,但仅解决了检索问题的一部分。尽管向量嵌入能理解用户意图,但仍面临关键词精确度和时间相关性挑战。混合搜索结合了向量和文本搜索,但可能导致错误答案。时间过滤可确保获取最新信息,设计合适的架构和索引对高效混合搜索至关重要。
完成下面两步后,将自动完成登录并继续当前操作。