本文提出基于AWS托管服务的GraphRAG汽车售后知识助手方案,融合知识图谱与向量检索,解决维修手册多语言、多模态、难关联查询等痛点。方案涵盖文档解析、实体抽取、混合检索与可溯源问答,可缩短手册启用周期、降低技师依赖,并可推广至其他知识密集型领域。
MoteDB v0.12.1 发布,这是一款用 Rust 编写的 AI 原生嵌入式多模态数据库,面向具身智能。单库文件集成列存、ACID 事务、向量检索、BM25 全文与空间索引,无外部依赖。新版支持混合检索 RRF 融合和 Python 列式互操作,并优化了排序、TopK、DiskANN 等性能。已知限制包括事务内 MATCH 可见性,API 尚未冻结。
企业AI中,单纯RAG系统存在查询歧义、检索遗漏和无法表达不确定性等问题。解决方案分三代演进:混合检索结合向量与关键词搜索;知识图谱增强实体关联;代理式AI实现动态推理、安全边界、消歧、并行检索和保守置信度评分。核心原则是确定性优先、低延迟、强制置信度评估和隐私硬约束,未来趋势是多代理编排。
随着组织从聊天机器人转向能调查、推理并代表用户行动的AI系统,检索成为应用质量的基础。传统搜索和RAG应用可容忍不完美检索,但智能体不能。检索工程需结合混合检索、实时信号、排序和机器学习推理,确保在服务时提供最佳决策。竞争优势转向决策,即决定智能体应看到什么及顺序,这将成为核心工程学科。
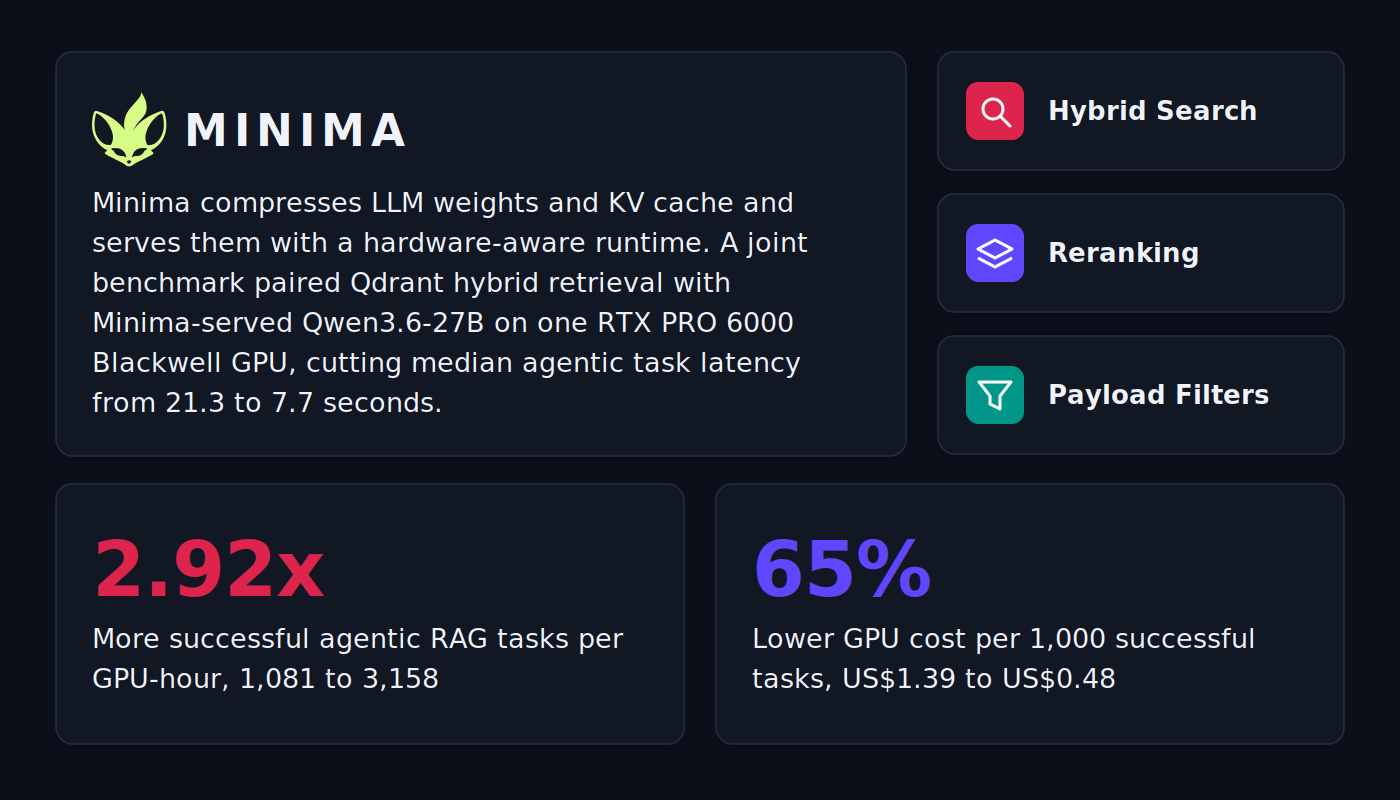
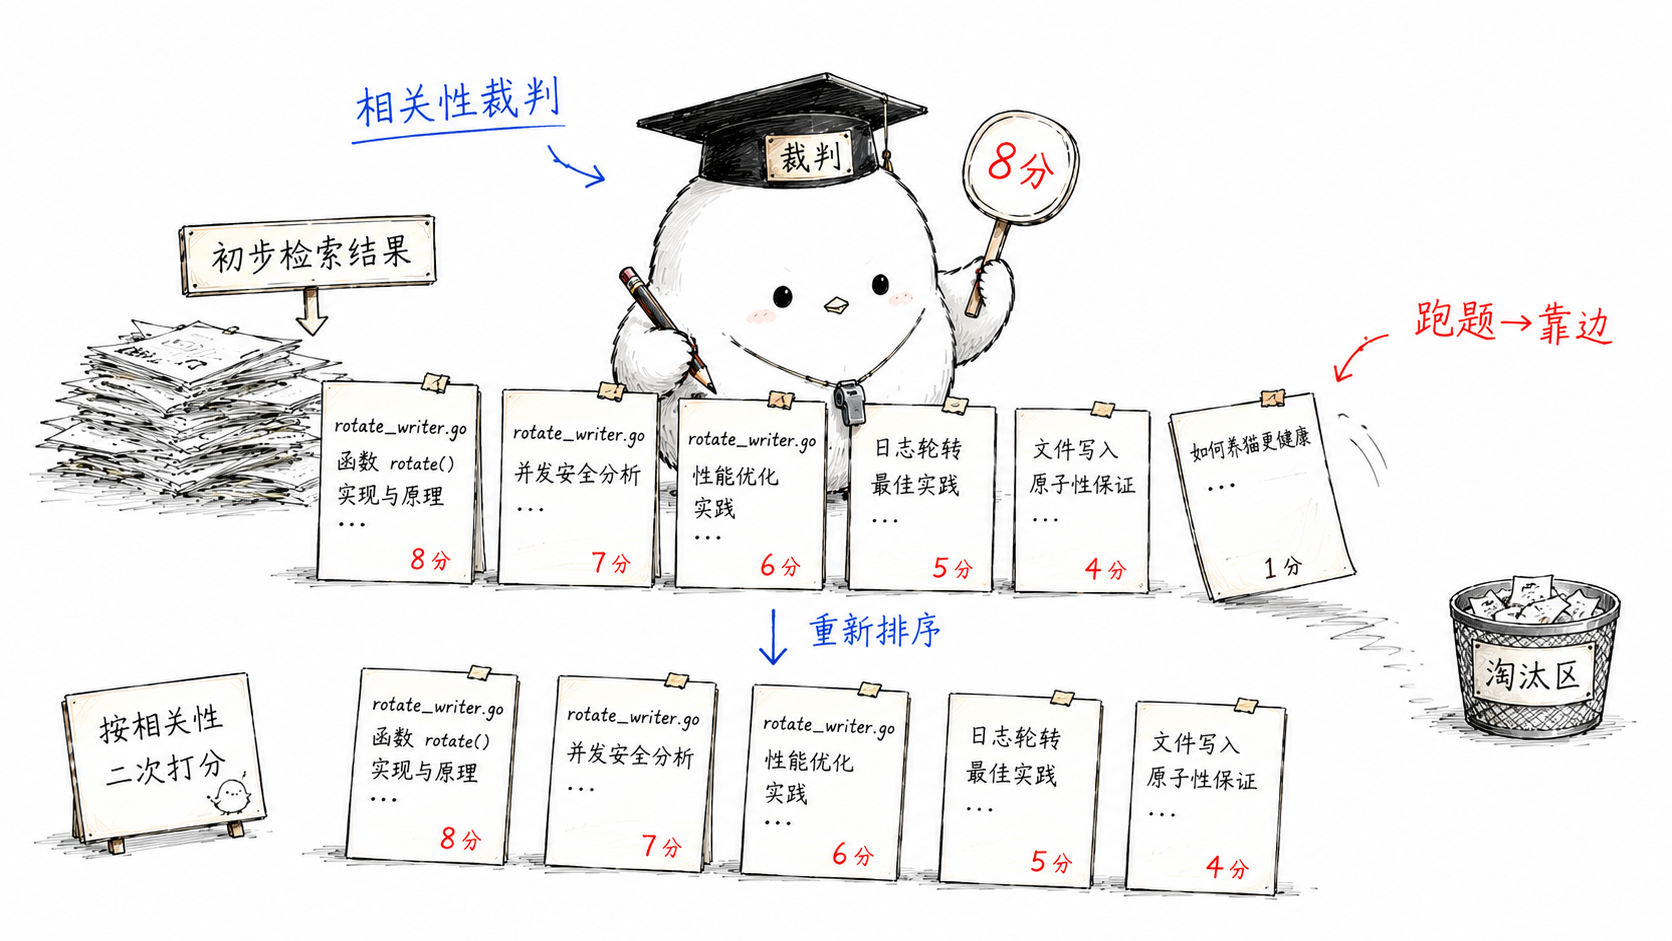
Qdrant与Minima联合优化智能体RAG,通过混合检索、重排序和模型压缩,将每GPU小时成功任务数从1081提升至3158,提升2.92倍。首轮检索成功率增至87%,上下文减少56%,延迟从21.3秒降至7.7秒,同时保持任务质量,显著降低推理成本。
本文介绍倒排融合(RRF)算法,用于合并关键词搜索和向量搜索的排名结果。RRF仅基于文档在各列表中的位置,而非原始分数,避免不同检索器分数尺度不匹配的问题。它无需训练数据,能有效提升混合检索质量,常用于RAG系统。实际应用中,检索速度比融合计算更关键,Redis Search支持在内存中快速执行此类混合查询。
本文介绍Neo4j图数据库中全文索引与向量索引的边界:两者均由Lucene驱动,不自动被Cypher规划器选用,需显式调用过程或SEARCH查询。全文索引用于分词匹配与打分,向量索引用于嵌入近邻搜索。内存上依赖OS缓存而非page cache,分数不可跨源比较,可与图拓扑扩展结合实现混合检索。
Cerebras知识库通过混合检索系统解决企业知识管理难题,结合向量搜索、全文匹配、时间衰减和RRF融合,直接索引Slack、代码仓库等原始数据,无需员工改变习惯。按项目范围过滤噪音,支持增量更新和MCP轻量工具,日均处理15000次提问,强调精准而非全面,实用至上。
构建电商搜索时,混合检索(密集向量+BM25)优于单一方法;过滤应在查询内进行,避免结果稀疏。嵌入文本比模型大小更关键,量化内存可省去重排序。个性化应作用于排序而非检索,商品运营用权重调整。评估需多指标互补,注意分片融合陷阱。
Cerebras构建企业知识库,融合Slack、代码库等多源数据,采用混合检索(向量、全文、词频加权)与LLM提炼线程卡片,提升搜索准确率。系统通过项目机制收敛范围,MCP接口解耦检索与推理,支持灵活调用。核心原则是不改变用户习惯,数据就地接入,实现可扩展的语义搜索。
Cerebras构建企业知识库,整合Slack、代码库等多源数据,采用混合检索(向量、全文、词频加权)与LLM提炼线程,提升搜索准确率。系统通过项目机制收敛范围,MCP接口解耦检索与推理,支持灵活调用。核心原则是不改变用户习惯,数据就地提取,实现可扩展的语义搜索。
选择memory-lancedb-pro的原因包括:混合检索提高精度,智能提取和遗忘机制优化记忆管理,以及便捷的数据导入与迁移。Pro版支持更精准的语义检索和自动分类,适合需要高效记忆管理的用户。
本文讨论了在Elasticsearch和Lucene中结合稀疏BM25与稠密kNN进行混合检索的策略,重点分析了两种索引的共存、查询策略及其对性能的影响。混合检索需同时利用BM25和kNN信号,以确保候选文档的一致性和可比性。文章还探讨了写入路径、代价模型及与专用向量引擎的边界问题,强调了统一Segment生命周期的重要性。
本文讨论了在Milvus中将过滤结果转化为bitset的方法,以及选择度对Top-k合并的影响。混合检索流程包括表达式求值、bitset过滤、Knowhere搜索和多级归并。选择度是影响查询效率和结果准确性的关键因素。文章还提到工程中的挑战和未来研究方向。
文章介绍了chao-rag-wiki技能,该技能通过将775篇文章存入4MB的向量库,实现快速检索和知识管理。与Karpathy的llm-wiki不同,chao-rag-wiki直接对原文进行语义索引,支持混合检索,能更全面地召回信息。两者各有优缺点,前者适合查找整理好的知识,后者适合快速检索原始资料。
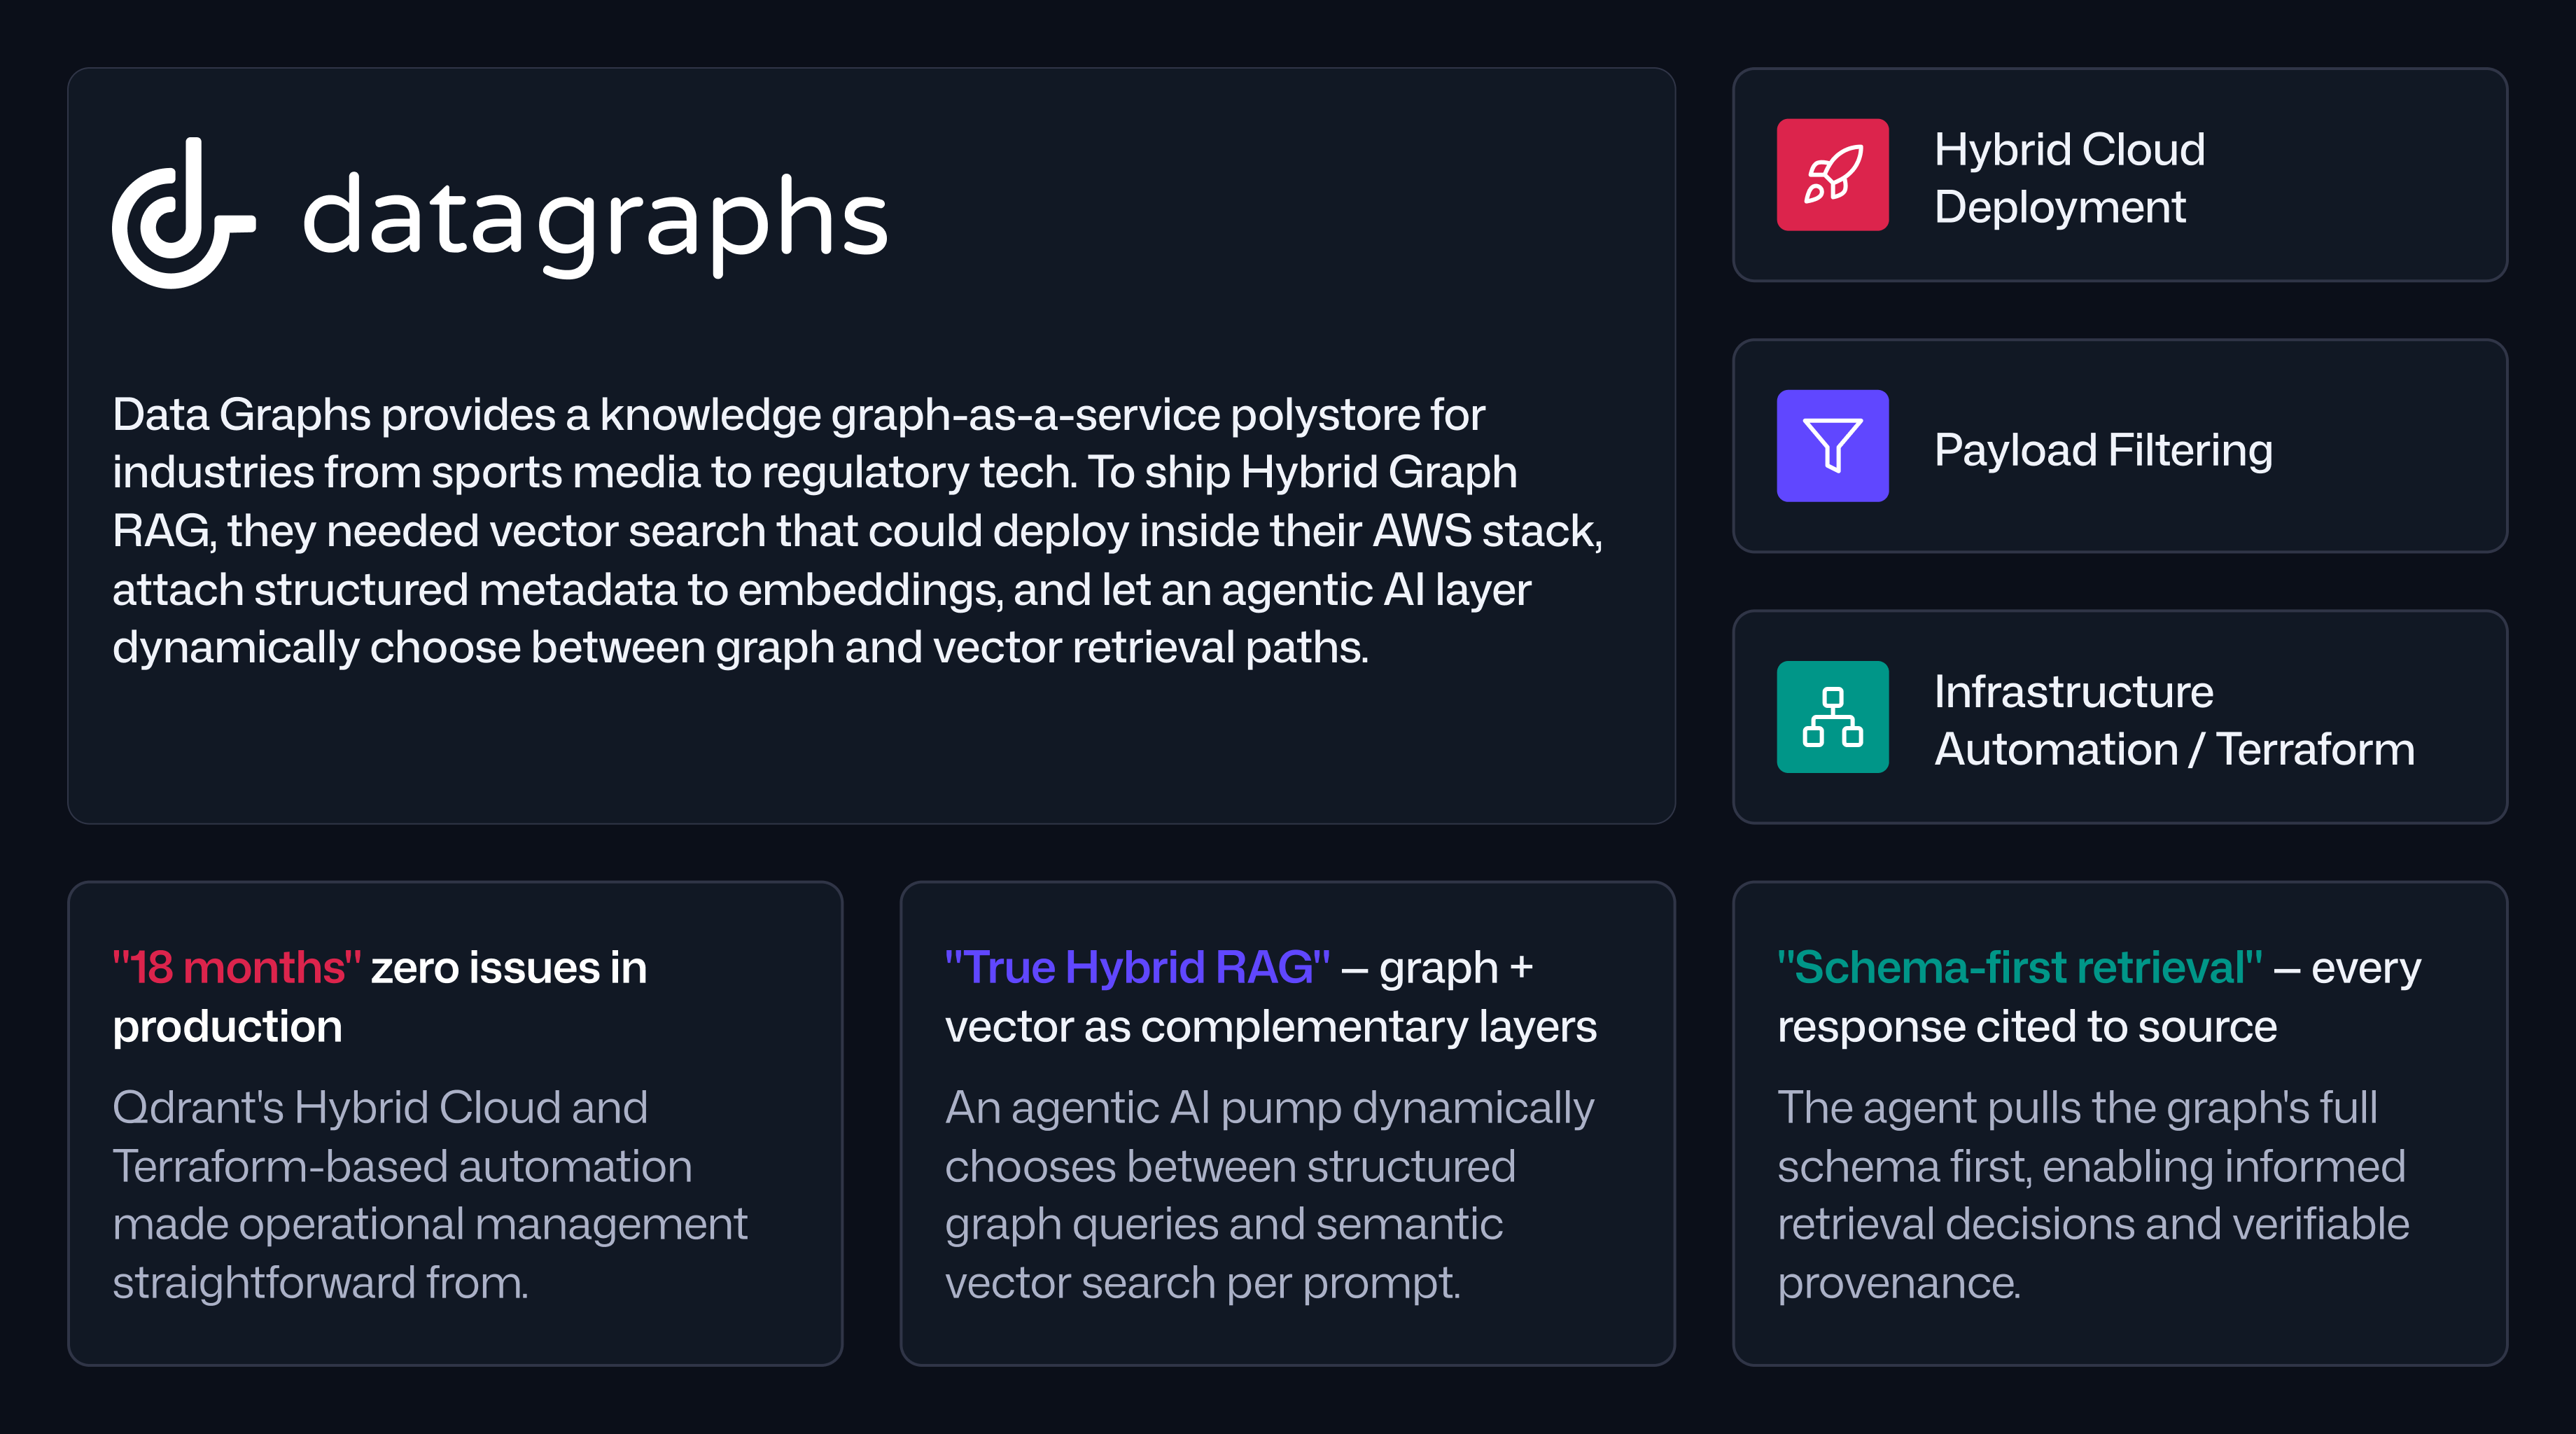
Data Graphs是一家英国公司,提供结合图数据库、全文搜索和向量嵌入的知识图谱服务。其平台通过Qdrant实现混合检索,克服了仅依赖向量检索的局限性,支持复杂数据的高效检索。经过18个月的生产运行,Qdrant表现稳定,未来将向机器优先的方向发展。
Facebook对群组搜索进行了重大改进,采用混合检索架构,提升了用户发现和验证社区内容的能力。新系统通过并行检索策略和多任务模型优化,解决了用户在搜索时的发现、消费和验证难题,提高了搜索的相关性和用户参与度。未来将进一步整合先进模型,提升搜索体验。
向量搜索在人工智能中受到关注,但在检索增强生成(RAG)应用中,全文搜索提供更高精度。BM25算法通过词频、文档长度归一化和逆文档频率优化搜索结果。混合检索系统结合全文搜索与向量搜索,实现关键词精确匹配和语义回忆,提升检索质量。
上下文窗口管理对LLM应用性能至关重要。过多的token会导致延迟和质量下降,尤其在长文本中信息易被忽视。有效管理需优化token使用,采用智能文档分块和混合检索策略,并监测性能以降低成本。
RAG系统从原型到生产需要不同架构,如双管道、混合检索和语义缓存,以提升性能和降低成本。在生产环境中,需增加数据存储层,保持索引同步,处理文档删除和缓存命中率。同时,有效的代理记忆架构对用户体验至关重要。
完成下面两步后,将自动完成登录并继续当前操作。