小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
SGLang 与 Miles 为 DeepSeek-V4.1 提供首日支持

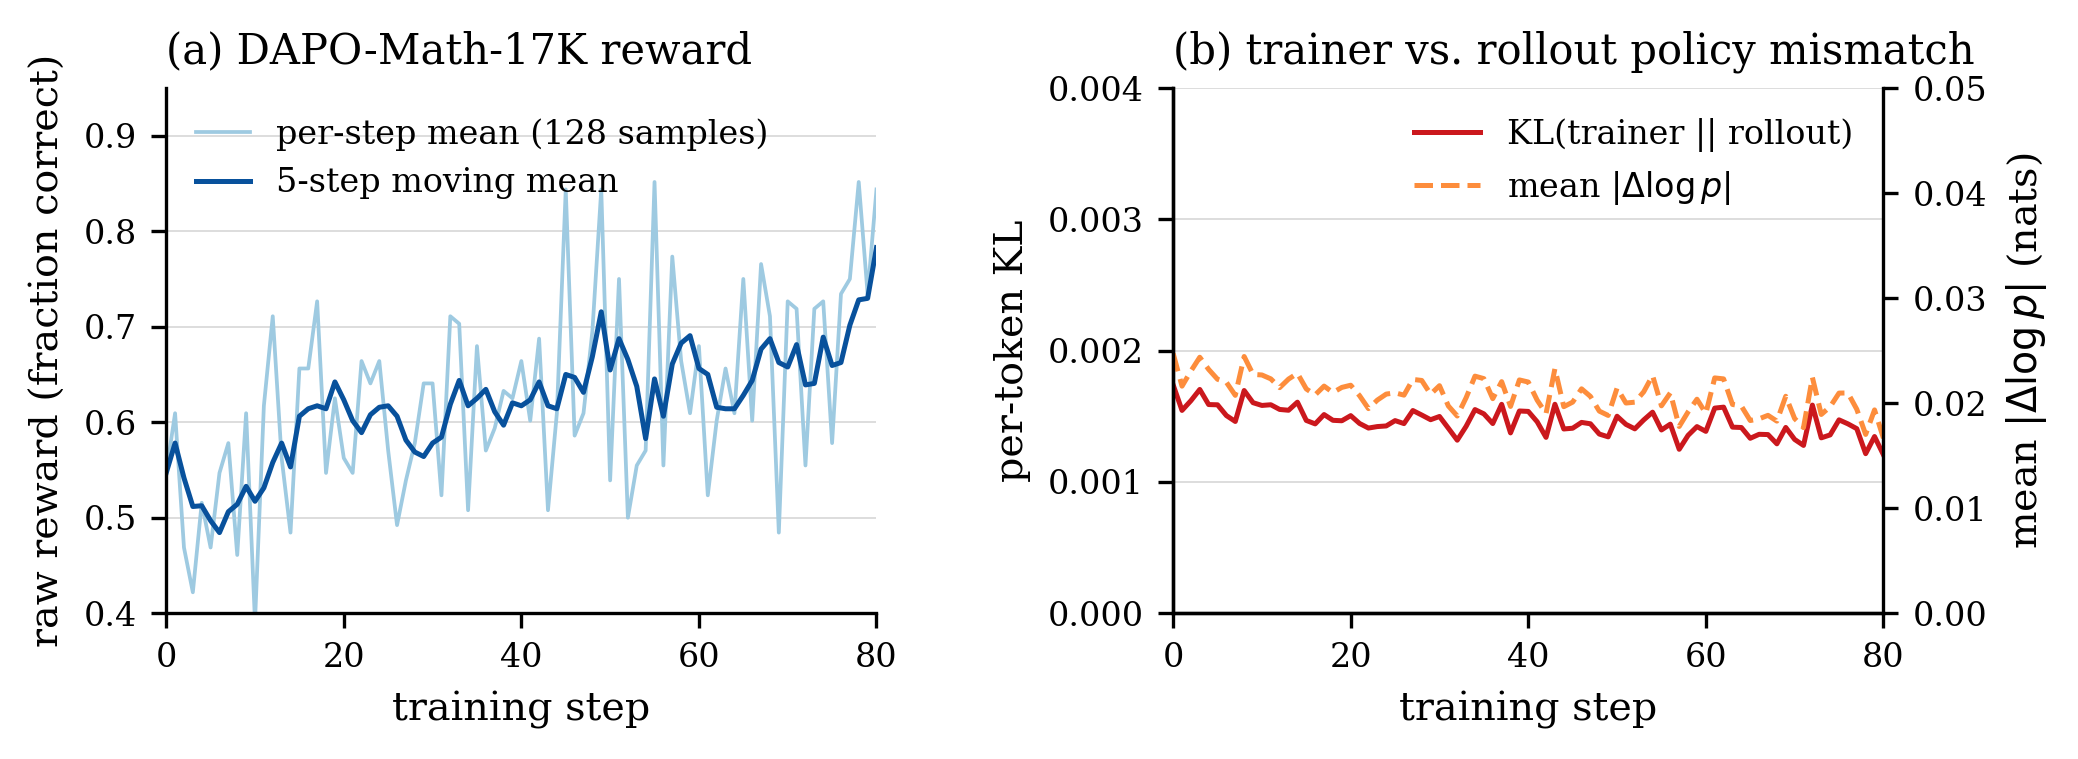
DeepSeek-V4.1 的 SGLang 服务栈优化包括:采用低比率压缩与滑动窗口注意力,跨层共享压缩 KV 和索引选择;Engram 表可卸载至主机内存,KV 缓存容量提升 36% 且吞吐相当;SWA 有界重放以有限重算换取缓存节省,解码端预填吞吐在 H200 上提升 1.56 倍;内核融合与 FP4 索引优化执行效率;Miles 训练后端支持量化感知训练与路由重放,训练与推理的对数概率差距小且稳定。

SGLang 与 Miles 为 DeepSeek-V4.1 提供首日支持

LMSYS Org LMSYS Org · 2026-09-10T00:00:00Z
一次吃下一本书!百度开源新OCR,作者疑似前DeepSeek研究员

百度推出的Unlimited OCR模型在长文档处理上刷新了SOTA,采用参考滑动窗口注意力机制,模拟人类阅读方式,解决了传统OCR的显存膨胀问题。该模型在OmniDocBench上表现优异,推理效率提升35%,并计划扩展到语音识别和机器翻译等任务。

一次吃下一本书!百度开源新OCR,作者疑似前DeepSeek研究员

量子位 量子位 · 2026-06-28T06:04:17Z
适用于推理的MixAttention模型

Transformer模型是现代语言AI的基础,使用注意力机制处理上下文生成输出。Character.AI提出了MixAttention架构,通过滑动窗口注意力和KV缓存共享来减少缓存大小,提高推理速度和降低成本。实验证明,MixAttention模型在保持模型质量的同时,提高了推理速度和内存占用。

适用于推理的MixAttention模型

Databricks Databricks · 2024-09-18T17:19:09Z

Mistral 7B 是 70 亿参数模型,采用 GQA 和滑动窗口注意力提升推理效率,其 Instruct 版性能超过 Llama 2 13B Chat。相关研究还涉及医学翻译微调、分散式推理系统 Petals(吞吐量比离线快 10 倍)、消费级 GPU 隐私保护训练、可扩展评判模型及小样本指令微调,发现 1k-6k 样本即可取得良好性能。

Birbal: 使用精选数据集进行高效的 7B 指令模型微调

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-03-04T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码