
本文批判静态用户画像的局限,主张用动态行为特征提升预测模型。核心方法包括:测量行为速度与加速度、评估功能使用深度、计算决策摩擦,并借鉴线下购物心理学映射线上信号。针对稀疏数据,采用零膨胀嵌入和频繁子轨迹挖掘。最后以零售需求预测为例,展示从数据采集到特征工程的实践路线,强调动态特征优于静态快照。
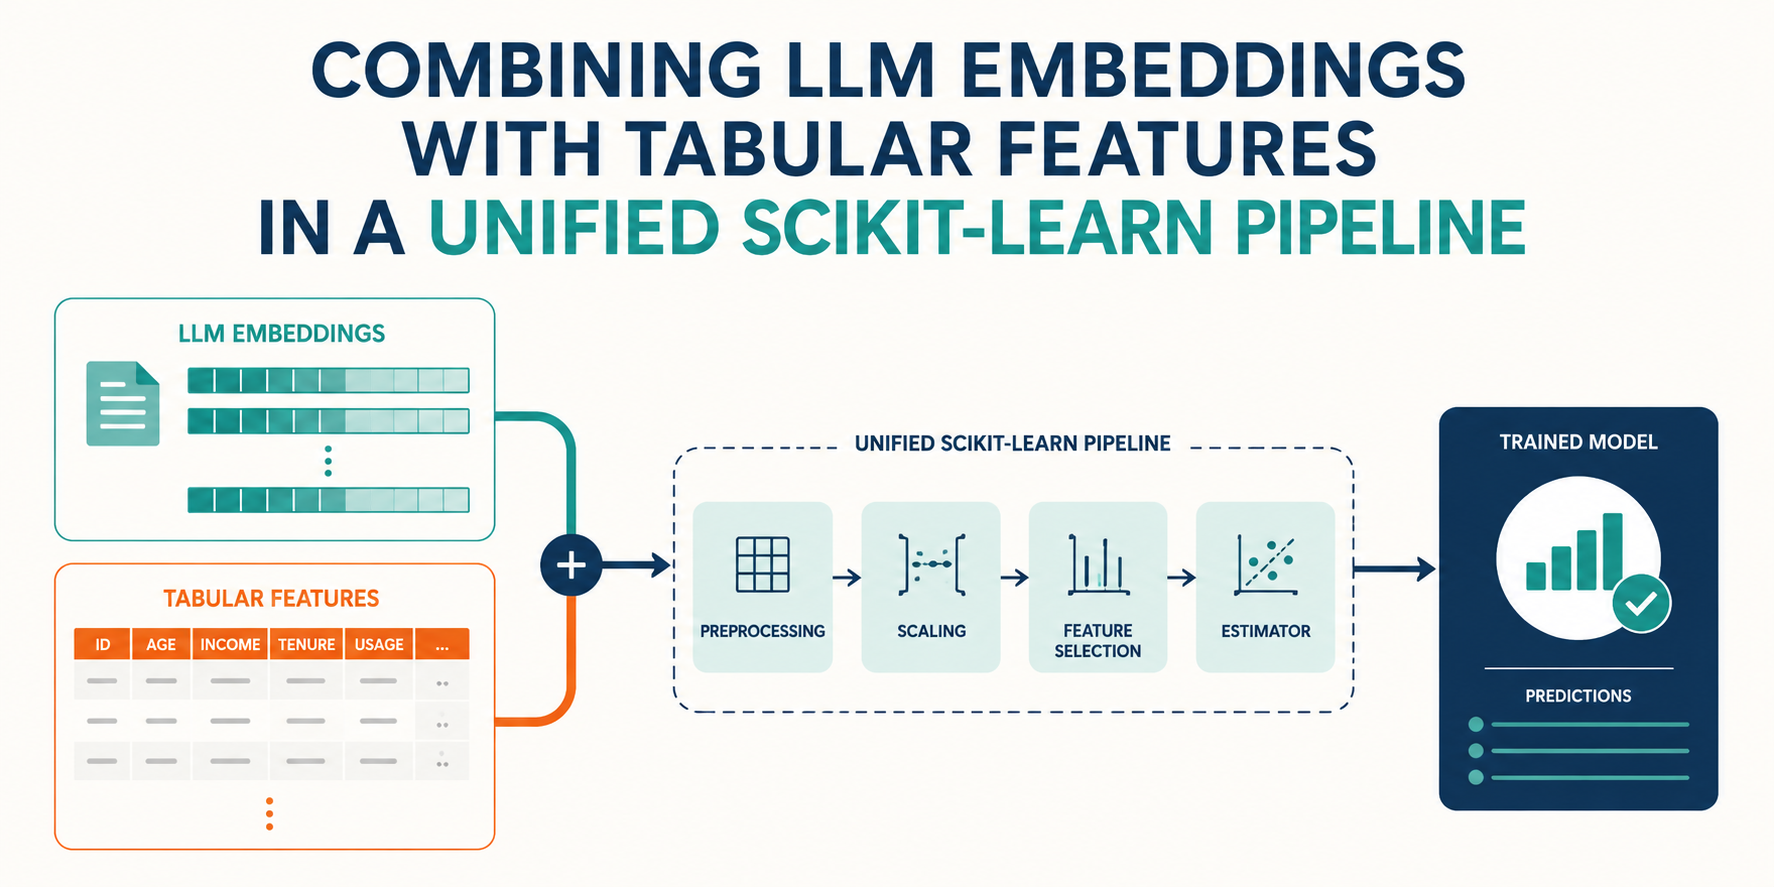
本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。
可穿戴设备难以区分压力与兴奋,因两者生理反应相似,仅能测量交感神经激活,缺乏情绪效价信息,可能导致误判。行业正通过情境叠加、面部声音线索或用户自报等方式改进,但尚无完美方案。用户应结合自身情境解读数据,避免被标签误导。
DONUT是一种物理感知的无监督深度学习框架,用于快速分析扫描式X射线纳米衍射数据。它无需标注数据,通过将可微分衍射模型嵌入自编码器,实时提取晶格应变和取向信息,分析速度比传统方法快超200倍,精度更高,并成功应用于SrIrO₃薄膜分析。
先进公共云具备全面普惠、集约高效、融合赋能、智能泛在、安全可控、国际引领六大特征,旨在降低智能技术门槛、提升算力效率、推动产业智能化。克拉玛依城市超级智能体采用“1+N”架构,升级城市AI云,实现政务高效办理,验证了这些特征的价值。
本文讨论了随机A/B测试中的回归分析,强调随机化的重要性。通过随机分配用户,回归模型能够提供无偏的因果估计。文章介绍了使用OLS回归分析任务完成率变化的方法,包括添加协变量、聚类稳健标准误差和交互效应模型。同时指出在实验不干净时需采用其他方法处理潜在的混杂因素。
Databricks推出了Feature Views框架,简化了机器学习特征的构建和管理。用户只需定义一次特征,平台便可处理实验和实时服务,确保训练和推理的一致性。该框架支持批处理和流处理,减少代码维护,提高生产效率。通过集成MLflow和Genie Code,数据科学家能够快速开发和部署机器学习模型,提升数据质量和可靠性。
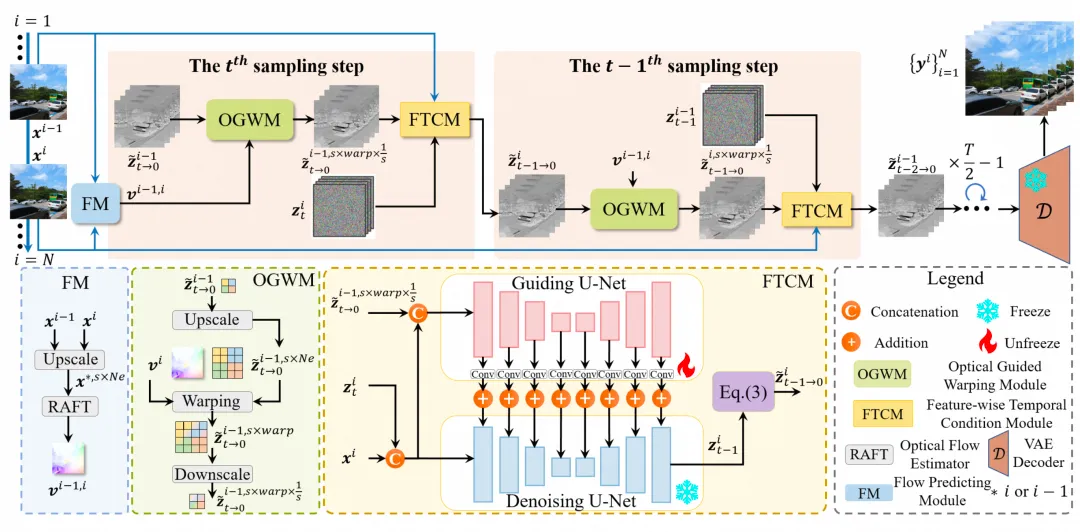
本文介绍了DGAF-VSR,一种基于扩散模型的视频超分辨率方法。该方法通过光流引导变形模块和特征级时序条件模块,显著提升了视频的感知质量、重建保真度和时序一致性。实验结果表明,DGAF-VSR在多个数据集上表现优异,为短视频和直播等应用提供了重要突破。
文章介绍了Fortress框架,该框架通过识别和去除导致预测不稳定的特征,提升搜索推荐系统的稳定性和准确性。利用历史快照数据,经过四个步骤处理不稳定预测,最终在大型应用市场的模型中验证了其有效性,显著提高了预测稳定性和分类性能。
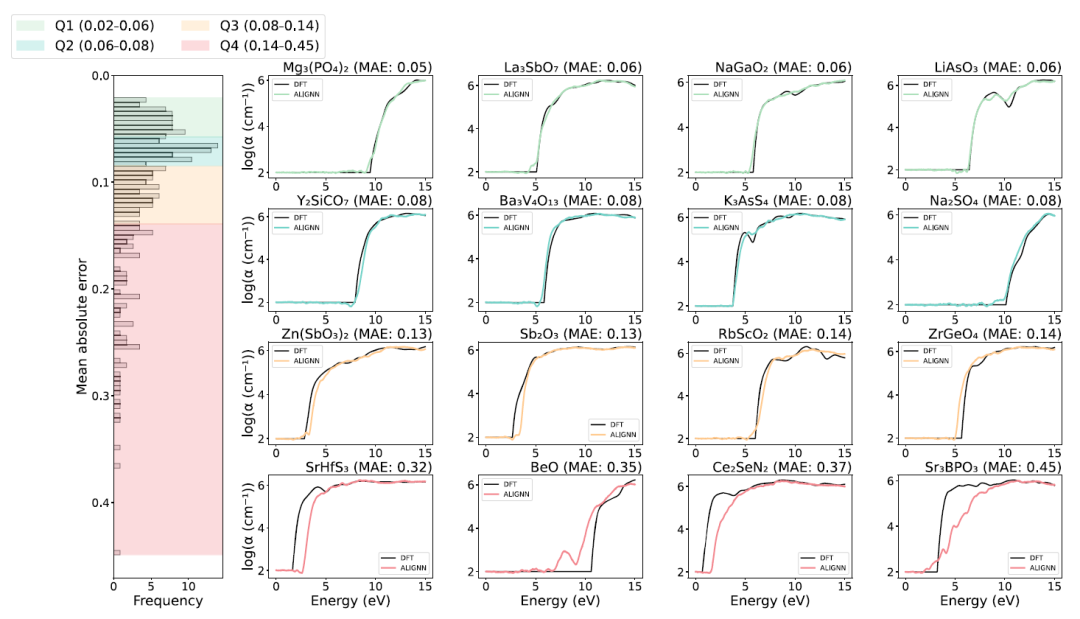
近年来,机器学习在材料科学中的应用逐渐深入,特别是在高维光谱数据的预测与解析方面。日本东京科学研究所的研究团队提出了一种新方法,利用深度学习模型ALIGNN处理光吸收光谱数据,显著提高了预测精度。研究构建了包含2681种材料的数据库,并通过特征提取与聚类分析,成功识别出影响光谱特征的关键元素及其配位环境,为材料设计提供了新的思路和工具。
Medium通过改进数据模型,优化了推荐系统的性能,采用列表特征简化数据存储和查询,提升操作效率。与DynamoDB相比,ScyllaDB在延迟和性能上表现更佳,Medium计划在更多工作负载中使用ScyllaDB。
2026年,独立创始人占C类公司的63%,创下新高。成功的独立创始人通常专注于构建AI原生产品,全球销售和B2B业务,并在早期保持客户。尽管多创始人团队在收入上领先,但顶尖独立创始人逐渐缩小差距。
本文讨论了量化特征仓库的构建,强调时间正确性(PIT)和版本管理的重要性。特征存储需解决复用、版本化和训练-服务一致性的问题,避免数据修订导致的回测失效。采用双时间维度模型,确保在任意历史时刻能准确还原特征值。文章还介绍了特征存储的技术选型及工程实现,强调监控和回填机制的重要性,以确保数据的可靠性和一致性。
文章讨论了在基于大型语言模型(LLM)的产品中,用户选择新功能(如AI助手)时的偏差问题。重度用户更倾向于尝试新功能,导致比较结果失真。为解决这一问题,文章介绍了倾向评分方法,通过统计工具消除选择偏差,准确评估功能效果,并提供具体步骤和代码示例,帮助数据科学家在产品实验中应用这些方法。
本文介绍了基于ONNX的图像特征提取模型dinov3_vitl16的实现,用户可以加载图像并提取特征,同时生成相似度热力图。文章详细阐述了模型的输入输出、特征提取过程及相关图像处理方法。
本文介绍挑选斗鸡的技巧,包括观察体型、眼睛、喙、翅膀、站姿、羽毛颜色、叫声及打斗方式等特征,以评估斗鸡强弱。优质斗鸡通常眼睛灵活、喙短宽、翅膀宽厚、站姿挺拔、羽毛颜色鲜艳(如红色)。旨在帮助读者掌握选鸡要领,提升比赛胜率。
本文介绍挑选斗鸡的技巧,包括观察眼睛、喙、翅膀、站姿、肌肉、羽毛颜色、叫声及打斗方式等特征,以评估斗鸡的强弱。例如,眼睛灵活、喙短宽、翅膀宽厚、站姿挺拔、羽毛颜色鲜艳(如红色)等通常代表更优秀的战斗能力。
风控是支付系统的核心,确保资金安全。文章探讨构建风控引擎的六个子系统,包括规则引擎、名单、用户画像、图分析和模型推理。强调实时性和延迟预算,介绍决策编排和Champion-Challenger策略,以确保风控决策的有效性与合规性,并展示行业案例和技术选型,突显风控在金融科技中的重要性。
本文介绍了SafetyPairs框架,生成仅在安全特征上不同的图像对,以区分安全与不安全的图像。通过图像编辑模型进行针对性修改,构建了一个包含3020个图像的安全基准,提升了视觉语言模型的评估能力,并改善了轻量级模型的训练效率。
本文介绍了如何使用Textstat Python库提取七种文本可读性和复杂性特征,包括Flesch可读性、Flesch-Kincaid年级水平、SMOG指数、Gunning Fog指数、自动可读性指数、Dale-Chall可读性评分和共识评分。这些指标有助于分析文本的可读性,支持机器学习模型的分类或回归任务。
完成下面两步后,将自动完成登录并继续当前操作。