GigaBrain-0.7 是具身基础模型,采用三系统架构:系统1基于 VLM 主干与动作专家生成连续动作;系统2负责理解与长程任务规划;系统3用世界模型预测未来视觉状态并评估进展。模型在超 3.7 万小时、16 种机器人形态的轨迹及约 2.7 亿视觉语言样本上单阶段联合预训练,并通过软知识隔离保持视觉语言能力,实现理解、预测、行动与经验改进的统一。
文章以小螃蟹与机器人的故事说明:AI的“理解”是指弄清意思、意图和约束,不能只看回答是否流畅。NLU专指理解自然语言,涵盖意图识别、实体抽取、指代消解等,只是“理解”的一部分,视觉与多模态理解不宜全归为NLU。NLP范围更广,NLU侧重分析,NLG侧重生成。上下文有助理解也可能带偏,判断理解是否正确须核对关键条件与任务结果。
中国电信星辰实验室发布并开源意图理解专用模型Xing4.0-29B-Intent,同步开放275万条训练语料、模型权重与推理镜像。该模型结合意图识别与参数抽取,将用户语句转为结构化JSON信息,支持多意图、多参数场景,响应时延百毫秒级,成本低且稳定。评测中综合表现优于多款通用模型,已应用于电信客服、智能家居等场景。
你手机上那个偶尔犯傻的聊天机器人,跟实验室里正在改写数学论文的智能体,用的是同一套技术底座! Andrej Karpathy在2026年4月的一条推文戳破了这层窗户纸,他说两群人正在“互相擦肩而过”,一群人看到的是免费聊天机器人犯傻,另一群人看到的是付费智能体在代码和数学里横冲直撞,而这两群人说的“AI”根本不是同一个东西! 到了10月,他把这条推文翻了出来,理由只有一句:这个理解差距
阶跃星辰 Step 5 Preview 上线 OpenRouter,100万 token 上下文窗口直接把 AI Agent 的天花板掀开了! 阶跃星辰 Step 5 Preview 现已登陆 OpenRouter,支持 OpenCode、Cline、Nous Research、Kilocode 等平台一周免费体
文章介绍用 Java 17 的 HttpClient 调用 Gemini 图像理解接口,从发票图片中提取发票号和金额。做法是让模型只返回单行 JSON 候选字段,再由 Java 校验格式、金额上限和必填项,避免把模型输出直接当财务事实。文中给出完整示例代码,并提醒密钥用环境变量、金额用 BigDecimal、HTTP 200 不等于识别成功,仅适合低风险预填和人工审核场景。
GitHub 动态工作流采用“确定性骨架+概率性节点”模式:用代码固定步骤、依赖、数据格式与审批点,仅将需判断的局部交给 Agent。该模式可重复执行、可观测、可控成本,并支持版本对比与测试。设计时需区分确定性工具、概率性判断和副作用节点,分别处理重试、超时与审批,适用于发布检查、事故研判等重复且失败代价高的任务。
NVIDIA发布NeMo Relay教程,介绍Agent轨迹可观测格式ATOF等三类轨迹,主张将结果验证与过程证据分开。轨迹是按时间排序、带关联标识的执行事件,通过开始/结束事件配对还原工具调用,可定位错误、重试与成本问题。文章给出解析JSONL的最小实践,并提醒避免混淆请求与执行成功、忽视脱敏等误区。
ProvenanceGuard面向多工具Agent,在生成答案后读取工具轨迹,将回答拆分为声明并逐条验证来源,可允许、阻断或修复。医学测试中,系统拦截了139条应拦声明中的138条,但相似来源精确匹配率仅50.3%。文章强调多源RAG应保留来源ID,区分事实正确与出处正确,并提供Python示例检查声明是否由声称来源支持。
Percona Server for MySQL 9.7 新增向量相似度函数 DISTANCE() 与 VECTOR_DISTANCE(),并涉及 MySQL 组复制跨集群 DC-DR 方案及数据目录中 GCache 页面文件过多的问题。
VLX-Seek是OmAI Lab推出的细粒度视觉语言模型,面向机器人、无人机等边缘具身视觉场景,结合语言理解与区域级视觉感知,支持目标定位、指代理解、区域OCR、描述与计数,并引入目标缺失拒识机制,为具身智能连接环境感知与行动决策提供基础能力。
OpenAI宣称证明纳维-斯托克斯方程有限时间爆破,引发AI在数学中作用的讨论。作者认为,证明不仅需正确,更需增进理解。在气候预测、飞机设计等领域,预测须先于验证被信任,因此需可审计的因果链。应将AI嵌入物理守恒律等可审计框架,用于学习可单独检验的闭合模型,而非端到端黑箱,从而让理解与预测相互促进。
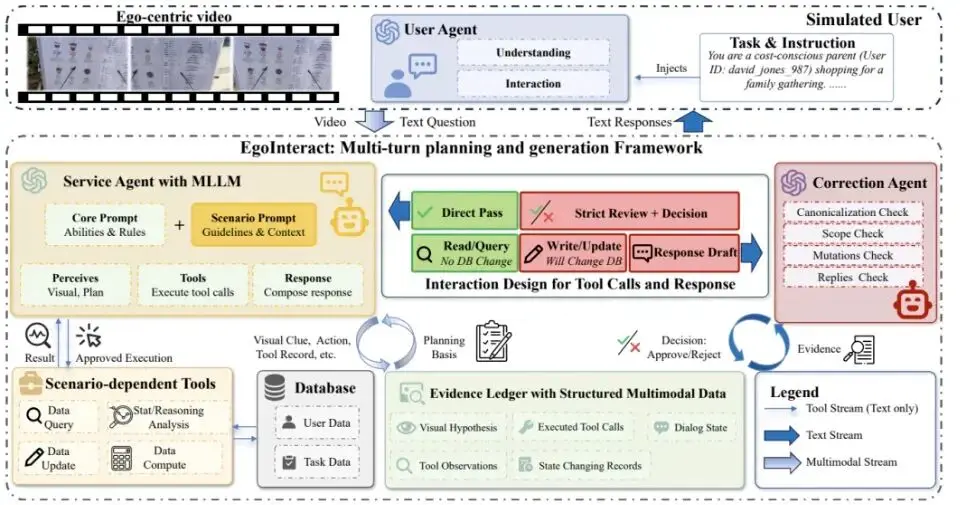
上海交大团队提出EgoInteract系统,用于EgoLink挑战赛Track 2的第一人称社会场景交互任务。该系统包含场景感知服务Agent与范围受限自纠正Agent,通过证据账本统一视觉假设、工具观测与对话状态,防止无依据的状态变更。官方评测中排名第一,联合成功率0.844,微平均准确率0.916。消融实验显示场景规则贡献最大,纠正机制提供针对性防护。
数学家陶哲轩博客的客座文章(Henry Cohn 撰)讨论 AI 生成数学解答的问题。文章指出,数学的核心在于理解而非答案,理解需要主动钻研,且解答必须能被学界消化。AI 常产出晦涩杂乱的“数学垃圾”,虽可能正确却制造技术债,增加他人负担。作者呼吁使用 AI 者应负责任地帮助社区理解成果,而非丢下解答便宣称胜利。
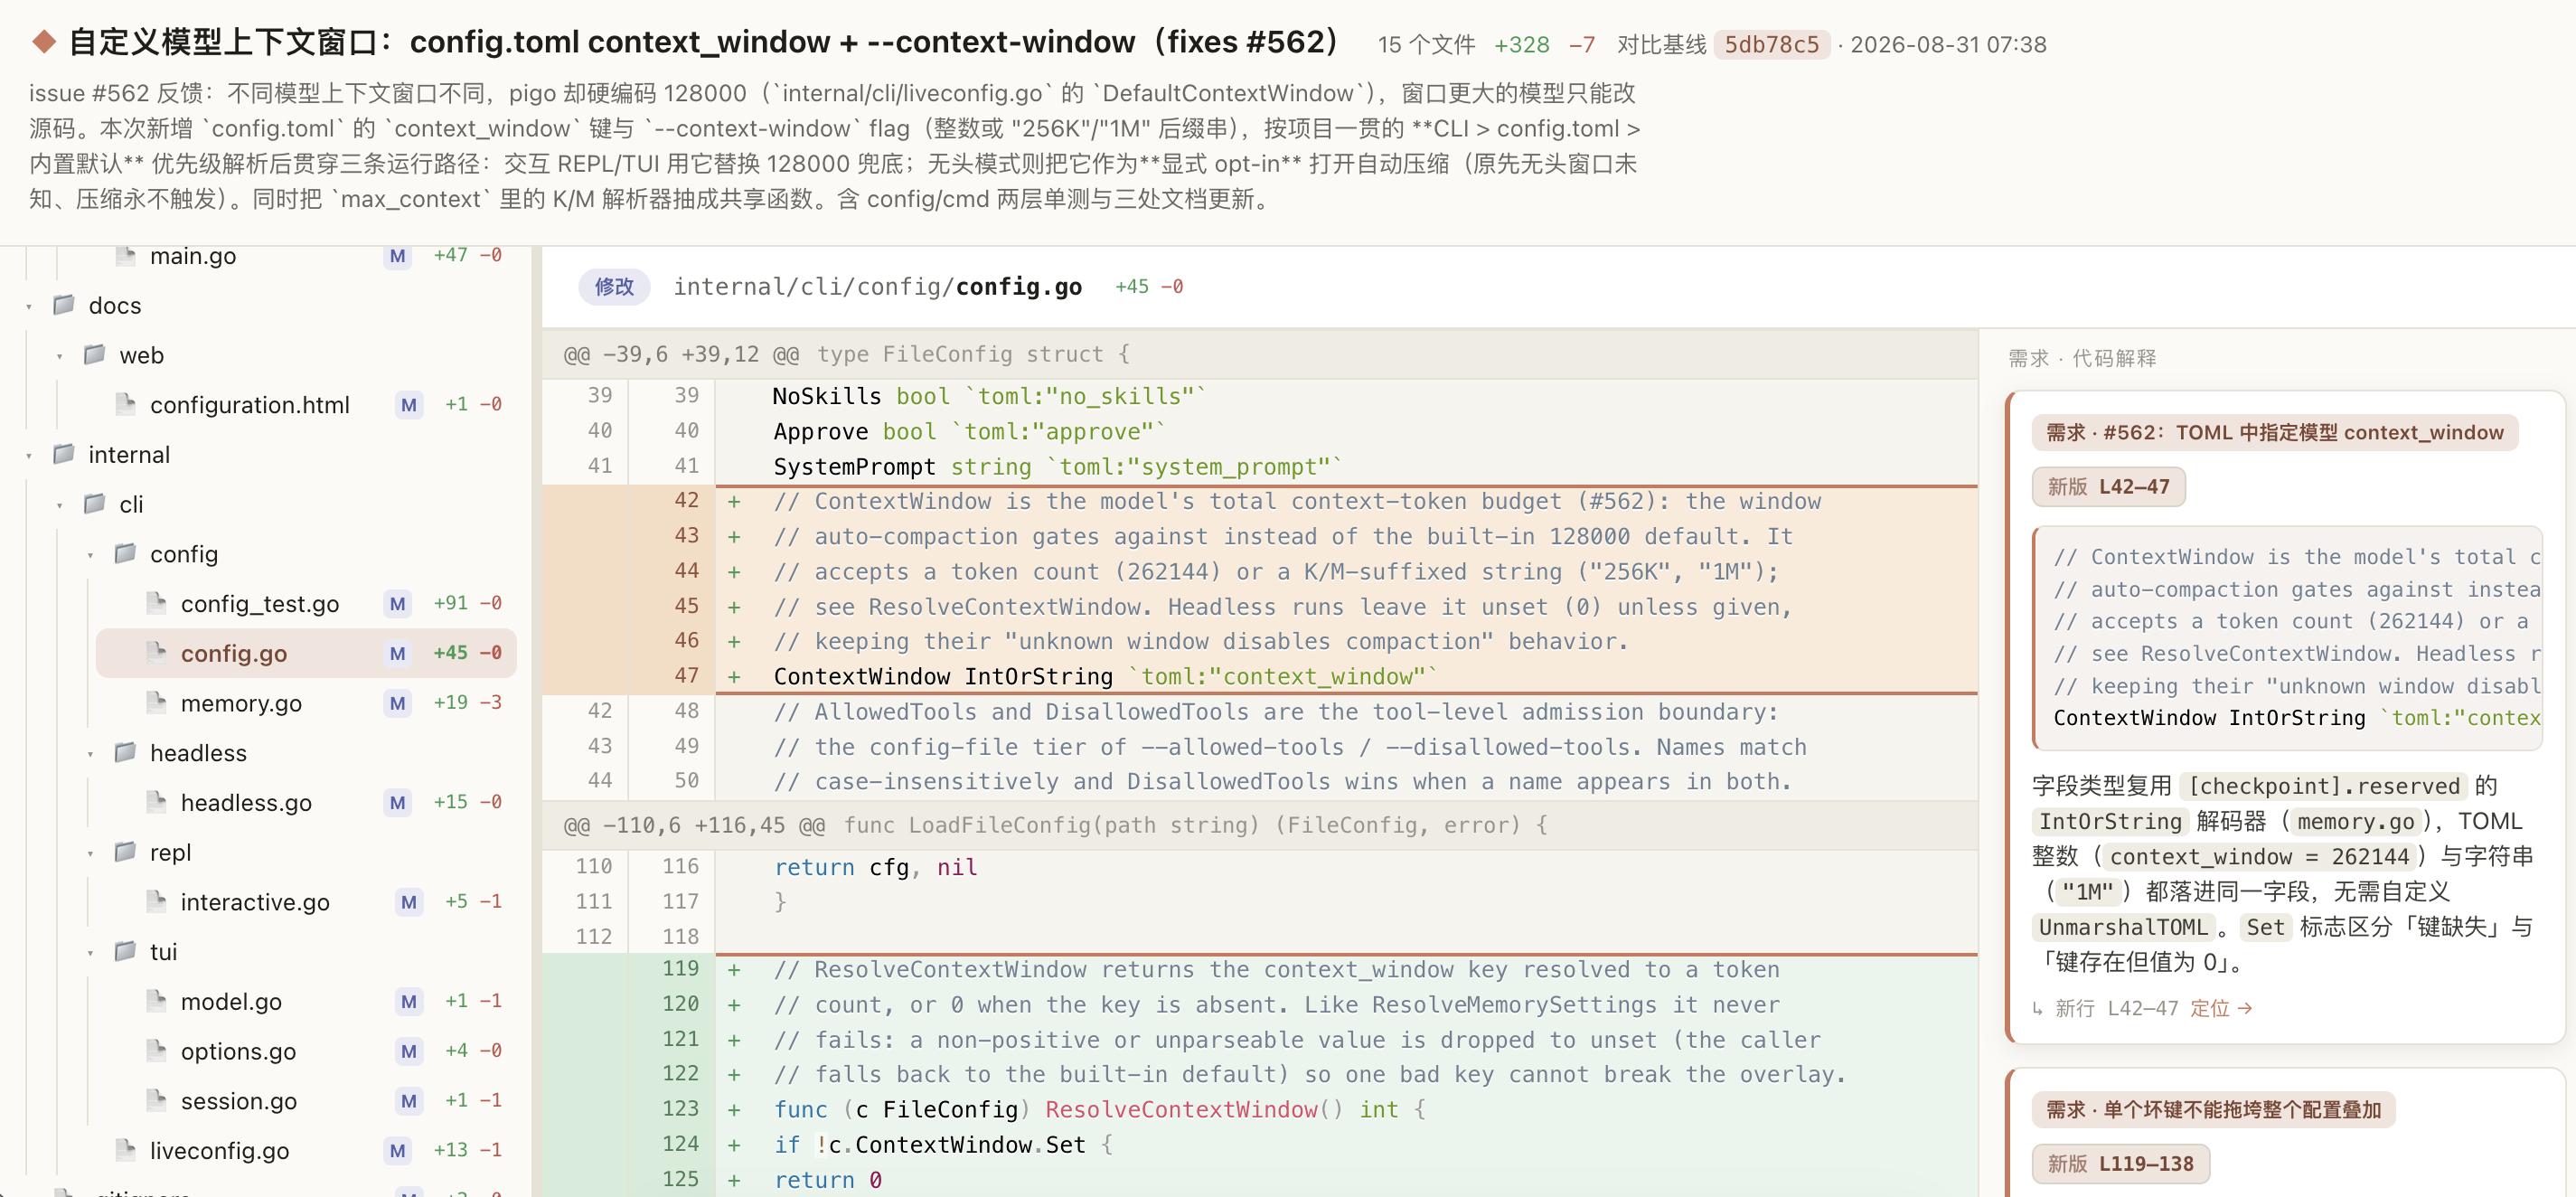
AI生成代码速度远超人的理解速度,导致代码库难以维护。作者认为理解无法外包或压缩,只能降低理解成本,于是开发了/understand技能:扫描变更,让AI逐段写注释,标注需求出处与推测意图,并渲染成可点击跳转的审阅网页,帮助开发者吃透AI生成的代码。
商汤科技发布SenseNova-U1.5-8B-MoT统一多模态模型,支持图像生成、编辑与理解,提升4K画质和文字渲染。HyperAI官网更新数据集、教程及百科词条,涵盖语音、地震数据及多模态模型部署,并预告9月截稿顶会。
谷歌推出Gemini 3.7 Flash等模型的智能体视频理解功能,通过动态扫描视频片段,将令牌消耗降低88%,成本降低66%,准确率提升7%。该功能支持子秒级检索、异常检测和精确计数,适用于长视频分析,现已通过Gemini API提供。
谷歌推出Gemini模型的智能体视频理解功能,支持3.7 Flash等版本,通过动态搜索和工具调用,将分析成本降低66%、令牌消耗减少88%,准确率提升7%。该功能适用于长视频检索、异常检测和动作计数,已通过API提供,并计划推广至Gemini应用和YouTube。
Agent Seer利用工具规范(如MCP)自动合成AI代理评估场景,无需人工或实时执行。它从单一规范生成多轮对话和模拟输出,在七个领域测试中表现良好,覆盖小中型工具集。研究发现参数复杂度影响质量,参数值准确性是主要失败点。
一个以动量为状态变量的优化器,基本形式如下:\begin{equation}\begin{aligned}\boldsymbol{M}_t =&\, \beta \boldsymbol{M}_{...
完成下面两步后,将自动完成登录并继续当前操作。