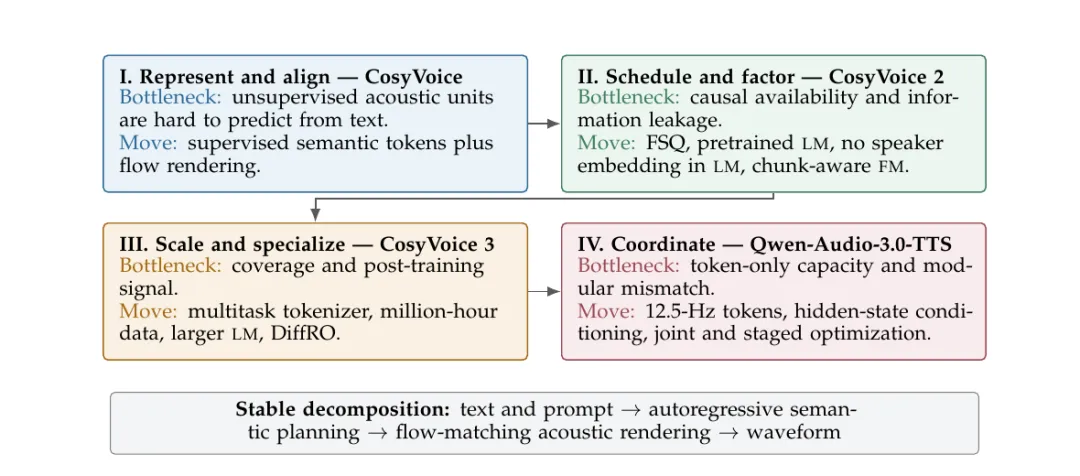
文章回顾了从CosyVoice到Qwen-Audio-3.0-TTS四代语音系统的演进,主线是在“LM语义规划+FM声学渲染”框架下接口的持续升级:CosyVoice用有监督语义码本解决表征问题;CosyVoice 2以FSQ和职责重划支持流式;CosyVoice 3扩大数据与模型规模并引入后训练;Qwen-Audio-3.0-TTS降低帧率、扩大容量,以连续隐状态作为渲染条件。作者据此提出表征、归属、可用时序、梯度可达四维接口框架。
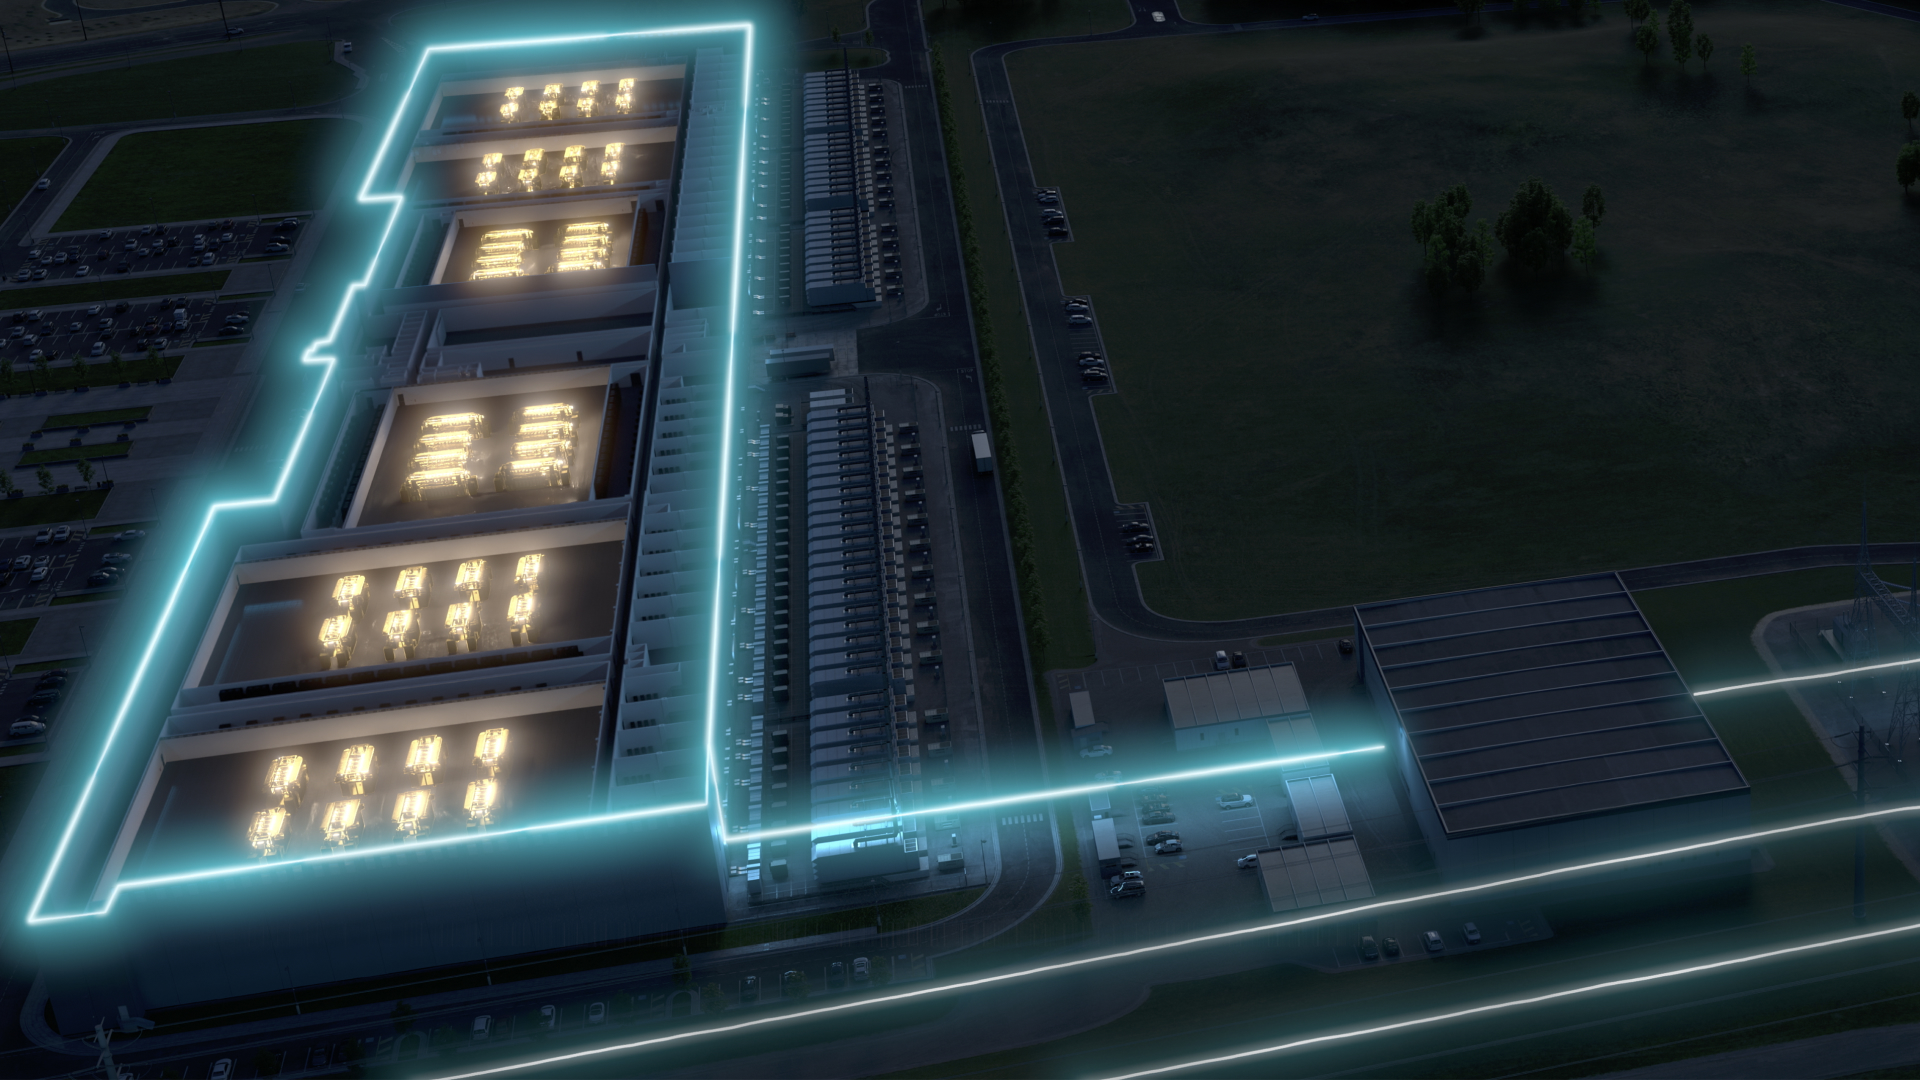
英伟达推出DSX AI工厂平台,将电网、设施与算力统一规划、模拟和运行,以破解电力瓶颈。美国目前逾200吉瓦项目排队并网、超3000亿美元设备积压,根源在于系统各自为政。DSX Sim支持动工前联合仿真,DSX Flex让AI工厂成为灵活电网资产,MaxLPS提升每瓦算力。GE Vernova、日立能源、施耐德电气、西门子能源及Phaidra、Emerald AI等已采用,可提升约10%算力并释放电网容量。
谷歌量子AI团队在Willow处理器上实现魔法态培育,将量子计算错误率降低约40倍,T态逻辑保真度达99.99%。该突破解决了长期资源瓶颈,首次在真实硬件上验证高效生成魔法态的可行性,为可扩展容错量子计算迈出关键一步。
Anthropic因AI写代码速度激增导致Git不堪重负,遂自研版本控制系统Scion。其核心设计为服务端承担计算、客户端极瘦、内容寻址、无锁提交,使基础设施需求缩小200倍,检出速度提升两个数量级。Scion多由Claude编写,7人团队5个月完成迁移。文章指出,当写代码成本趋近于零,版本控制、CI等为人类速度设计的环节将依次成为瓶颈。
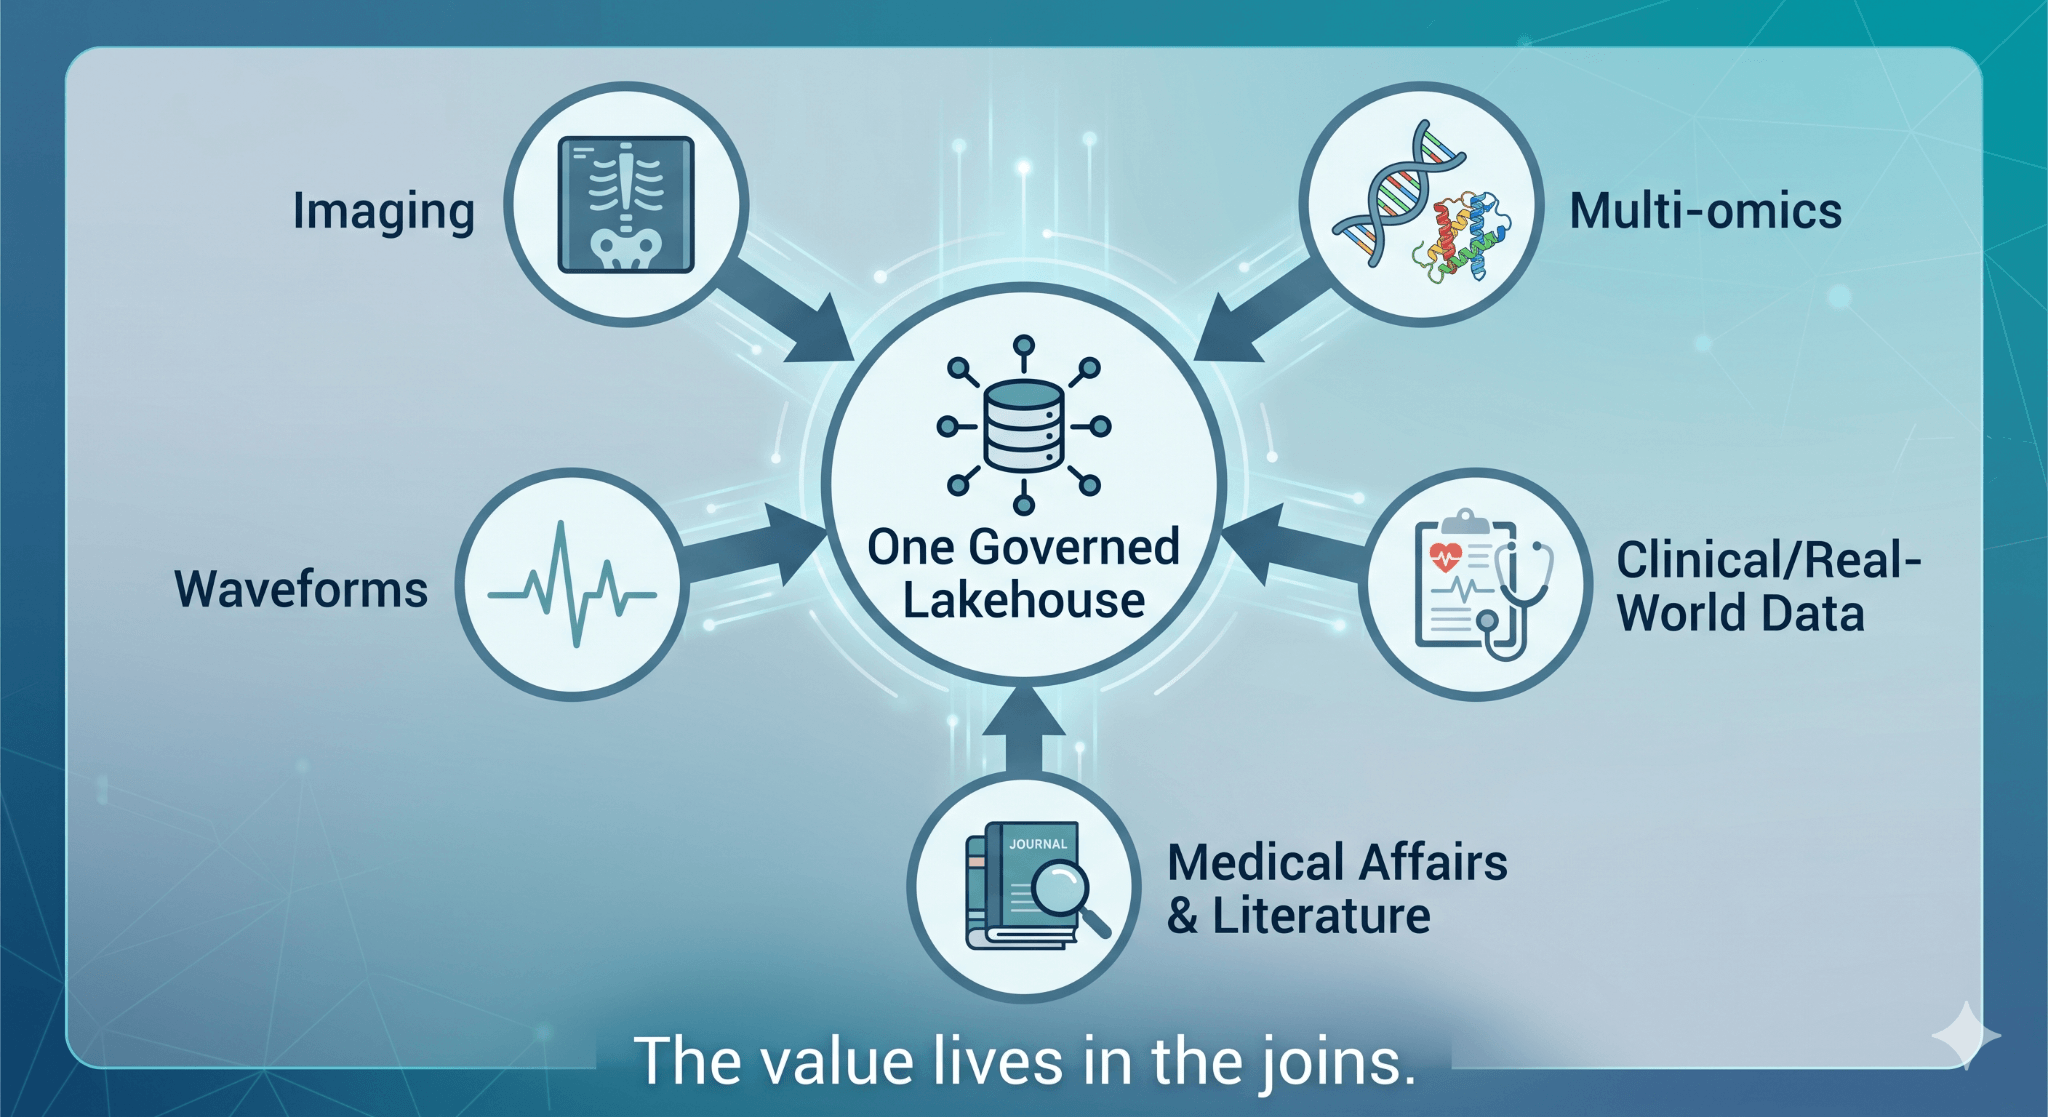
医学影像AI的瓶颈在于数据而非模型。数据困于PACS,格式繁杂、难以去标识化和跨机构共享,导致研究可复现性差。联邦学习与数据湖仓可整合影像、基因组、电子病历等多模态数据,实现统一治理与关联查询。核心结论:数据基础是医学AI的真正瓶颈,先做好数据,模型自然水到渠成。
AI编程导致CI成为瓶颈:代理并行工作使PR量激增,Anthropic的CI任务半年增25倍。但CI仅验证单个代码库,无法发现分布式系统中跨服务边界的故障。DORA数据显示,AI采用率越高,交付越快但越不稳定。解决之道是在代理循环内、提交PR前,用共享Kubernetes集群上的轻量测试环境对真实系统做验证。
研究测试语言模型通过自然语言传递树状表达式时的信息损耗:一模型生成应用题,另一模型提取表达式,以符号等价判定。结果显示通道有损且不对称,角色互换后准确率差达60.4个百分点;至少73.6%的失败源于生成端,难度取决于树结构;约3600条微调样本即可提升所有开源模型。
瓶颈常被视为效率障碍,但作者认为它并非坏事。瓶颈如同瓶口,设计目的就是限制流量,防止液体失控。人类消费能力有限,真正的瓶颈是人自身。因此面对信息或资源洪流,问题不在于如何改造自己适应,而在于为何要对着消防水管喝水。瓶颈或许不是问题,而是解决方案。
作者将在PG Summit 2026演讲,主题是用Postgres做硬件基准测试。他指出,测磁盘或CPU应使用fio等专用工具,而Postgres基准测试目标不同:涉及内存、并发、缓存、WAL、检查点和自动清理等复杂因素,短时测试无法反映真实生产表现。关键问题不是硬件多快,而是特定工作负载能否稳定运行、何时停止扩展、首先遇到什么瓶颈。可信测试需足够长、可重复,并记录配置、数据集和验收标准。
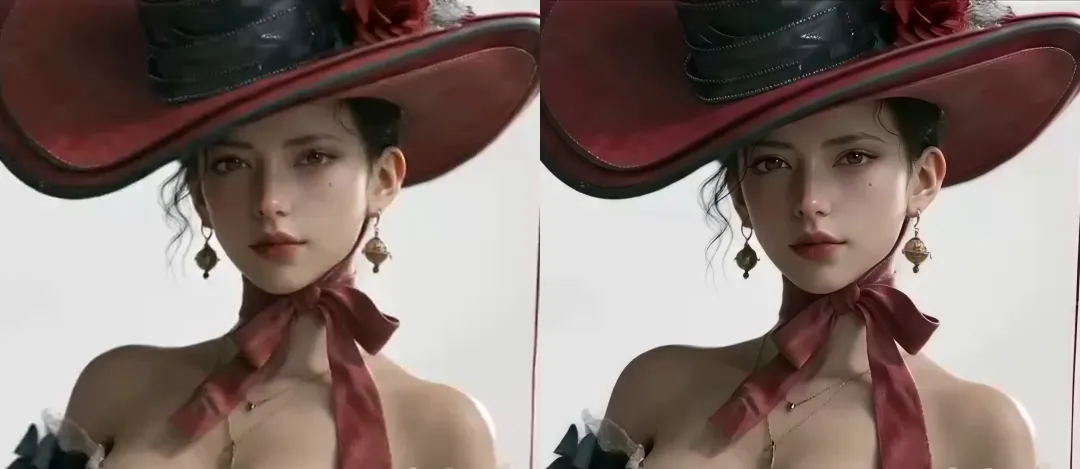
蔚领时代发布ArkLin DetailX视频超清引擎,专为AI大模型成片设计,通过后处理与画质重建,将低规格素材提升至720p至4K,降低算力成本。引擎提供专业版与标准版,已用于云游戏验证,某客户计费规模增长近15倍,助力AI短剧、广告等内容高效量产。
Hugging Face与Earthmover发布开源天气模型教程,以Aurora为例,展示从ERA5提取初始条件、执行24小时预测并计算误差的完整流程。文章指出模型权重易得,但数据管线是瓶颈:初始条件约1GB,全年回测需约360GB磁盘,且依赖特定GPU。开发者需处理Zarr数据、坐标与单位,并防止数据穿越。
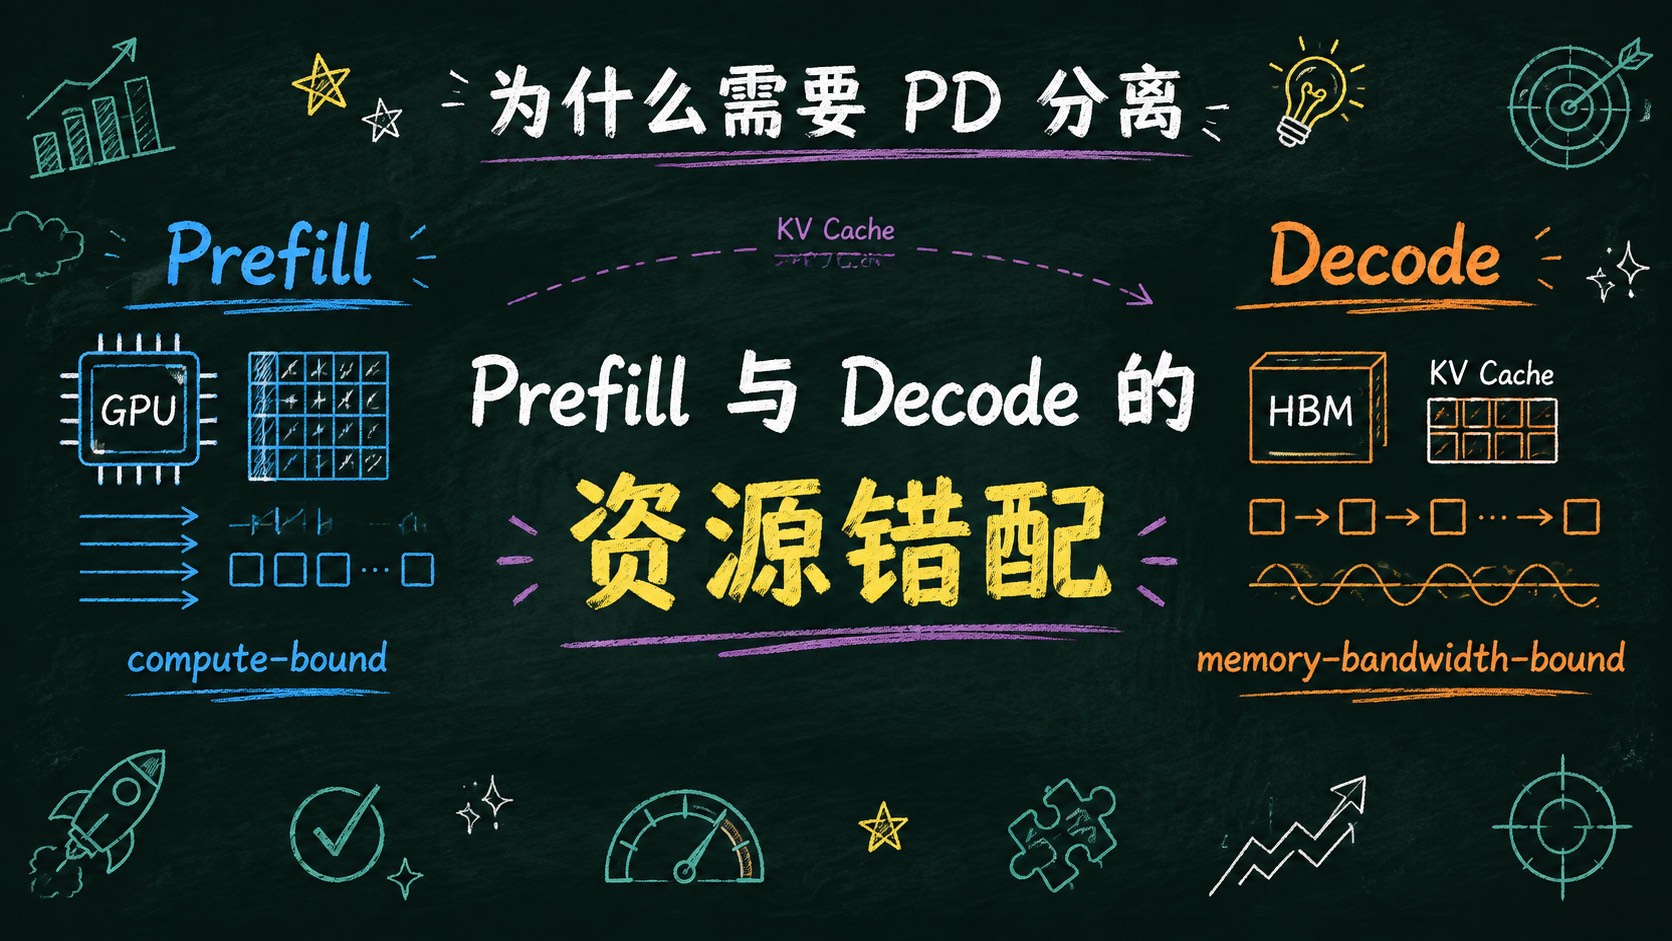
PD分离将LLM推理的Prefill(计算密集)与Decode(显存带宽密集)阶段拆分至独立资源池,以隔离干扰、优化TTFT和ITL,并允许按需配置硬件。它通过KV Cache传输衔接两阶段,但增加调度、网络和资源开销。仅当共置优化(如Chunked Prefill)无法满足SLO或资源需求不对称时,才值得采用。
该论文首次在开放生成任务上对比五种测试时扩展方法,发现瓶颈不在生成候选(探索有效),而在选择最终答案(利用失效)。奖励模型相关性低,BoN近乎随机,Fusion仅回收约40%增益。树搜索多样性坍缩,自我修正多无效。结论:候选池非瓶颈,选择才是,Fusion是目前唯一一致有效方法。
边缘计算已成为主流,66%的组织在Kubernetes上运行生成式AI,但分散的集群导致运维瓶颈。解决方案是舰队管理,通过Cluster API和黄金镜像标准化生命周期,用GitOps处理断连,并集中化可观测性和策略。Nutanix Kubernetes Platform(NKP)基于此理念,提供开放、合规的堆栈,支持离线操作,旨在减少运维负担,让团队专注创新。
AI编程时代,人类理解代码的速度跟不上AI生成速度,导致开发者沦为验证者。文章提出三个方法重建理解力:生成解释文档(先讲背景再讲代码)、创建微型交互世界(通过操作建立直觉)、共享团队认知空间(对齐心智模型)。核心观点是理解比验证更重要,只有保持理解力,人类才能从旁观者回归创造者角色。
CodeRabbit推出Agentic Change Management控制层,应对AI生成代码激增导致传统SDLC失效的现状。该服务将拉取请求作为关键决策点,通过代码图谱技术、自动审查、分诊和变更堆栈,帮助团队优先处理高风险变更,并扩展至生产环境安全监控,使人类专注于评估意图和架构而非逐行审查。
Transformer是过去十年最成功的深度学习架构,但其核心限制在于标准attention的O(n²)计算复杂度已被证明是理论下界,无法通过工程优化突破。此外,KV Cache线性增长、自回归串行性、长上下文不等于长期记忆、位置外推失效及数据供给上限等问题,共同构成架构瓶颈。新架构需在质量、成本、稳定性、生态四条战线同时超越Transformer,才能实现替代。
UniFi 网关设备(如 UDM Pro/SE/Pro Max)搭载的 CPU 性能出了名的孱弱、还缺乏 PPPoE 和 NAT 硬件加速的支持,在搭配 PPPoE 拨号的宽带时,UniFi 网关的性能更是捉襟见肘。那么,为什么不把 PPPoE 拨号的任务交给一个单独的设备来处理、让 UniFi 网关专注于路由、IDS/IPS 和 NAT 呢?
2026年Thoughtworks峰会指出,AI代码生成已过剩,验证成为新瓶颈。核心发现包括:Harness Engineering成独立学科,初级工程师面临学徒制危机,管理层与工程师认知鸿沟大,遗留系统现代化是AI最佳落地场景,治理滞后于自主性扩张。结论是,人类判断力、审美和克制是AI时代最后的护城河,需刻意保护“人味儿”作为战略资产。
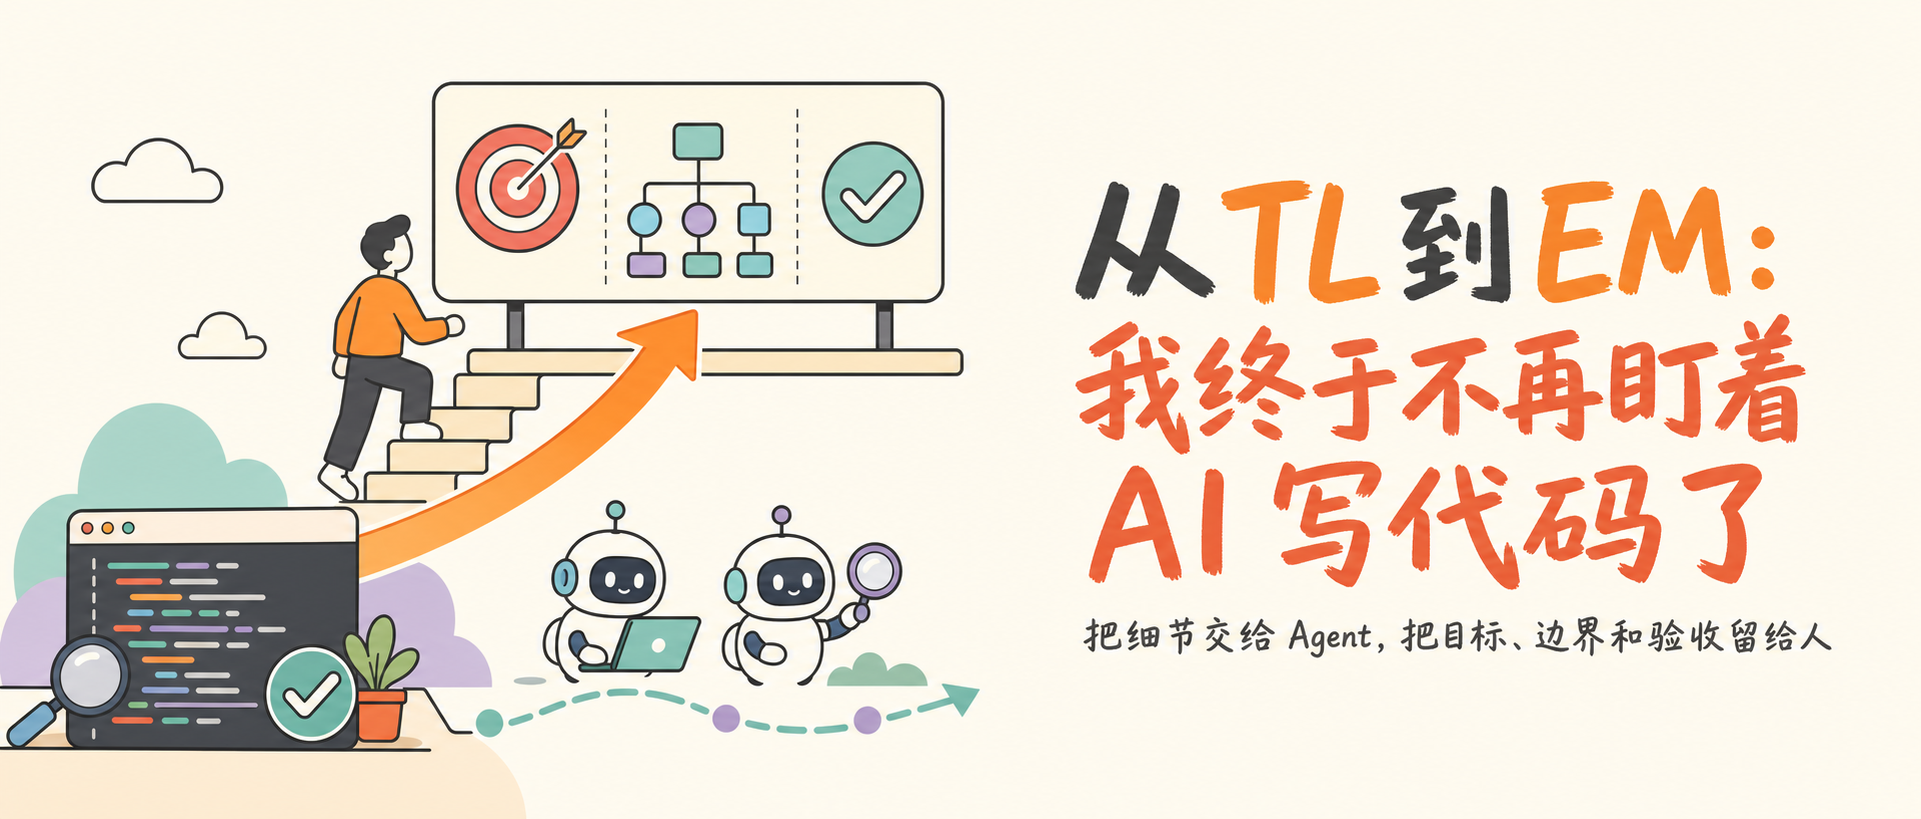
作者从TL转向EM角色后,不再紧盯AI写代码,而是关注全局和结果。AI代码质量提升,只需验证功能,Bug交给AI修复。技术选型不再局限于个人擅长,如用Rust开发跨平台应用。真正瓶颈从写代码变为想清楚做什么,人需明确方向,Agent才能高效执行。
完成下面两步后,将自动完成登录并继续当前操作。