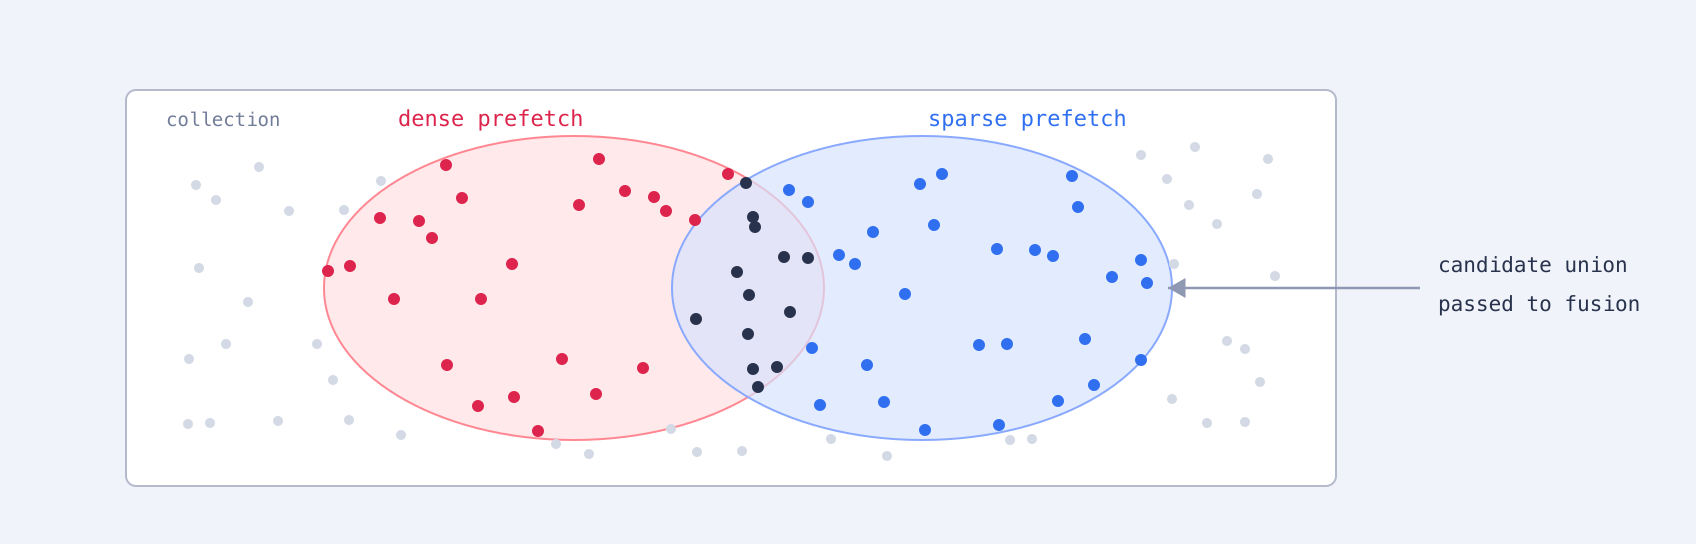
混合搜索结合稠密与稀疏检索,兼顾语义相似与精确词匹配。稠密检索擅长同义改写,稀疏检索(如BM25)擅长标识符和专有词。融合方法中,RRF按排名合并以避免分数尺度差异,DBSF则归一化分数。在五个公开数据集上,默认RRF在四个上优于单一检索器。但混合搜索增加存储、索引和查询延迟,需实测收益是否值得成本。
RAG框架的检索机制分为稀疏检索和密集检索。稀疏检索依赖关键词匹配,速度快但缺乏语义理解;密集检索通过高维向量捕捉语义,准确性高但计算复杂。混合检索结合两者优点,提高了效率和准确性,是信息检索的重要进展。
本文介绍了如何构建工程化的稀疏检索系统,重点分析了Milvus V2.4的实现。Milvus利用Knowhere作为底层引擎,支持稀疏向量检索。文章详细阐述了稀疏向量的存储结构、索引构建过程,以及暴力检索与WAND优化检索的实现,最后提供了Golang版本的稀疏检索示例。
在处理大规模文本数据时,结合传统的BM25检索方法与基于神经网络的稀疏检索,可以提高检索的准确性和效率。BAAI的BGE-M3模型通过改进的预训练方式生成稀疏向量,测试结果显示其召回率优于BM25。
该文综述稀疏检索与多模态检索进展,包括改进SDM用于学习稀疏检索(SoftSDM无额外优势)、SPLADE等提升效率与效果、稀疏语言模型加速推理,以及KD-SPD多语言检索、SWIM-IR合成数据、LHRS-Bot遥感多模态模型和RetriKT知识迁移压缩方法。
本文提出了信息检索和自然语言处理的概念框架,整合了稠密和稀疏检索方法,分成逻辑评分模型和物理检索模型。作者提出了度量器和比较函数,计算查询-文档分数,并分析了密集与稀疏表征和监督与无监督方法的影响。提供了一个研究路线图,为未来工作提供方向。
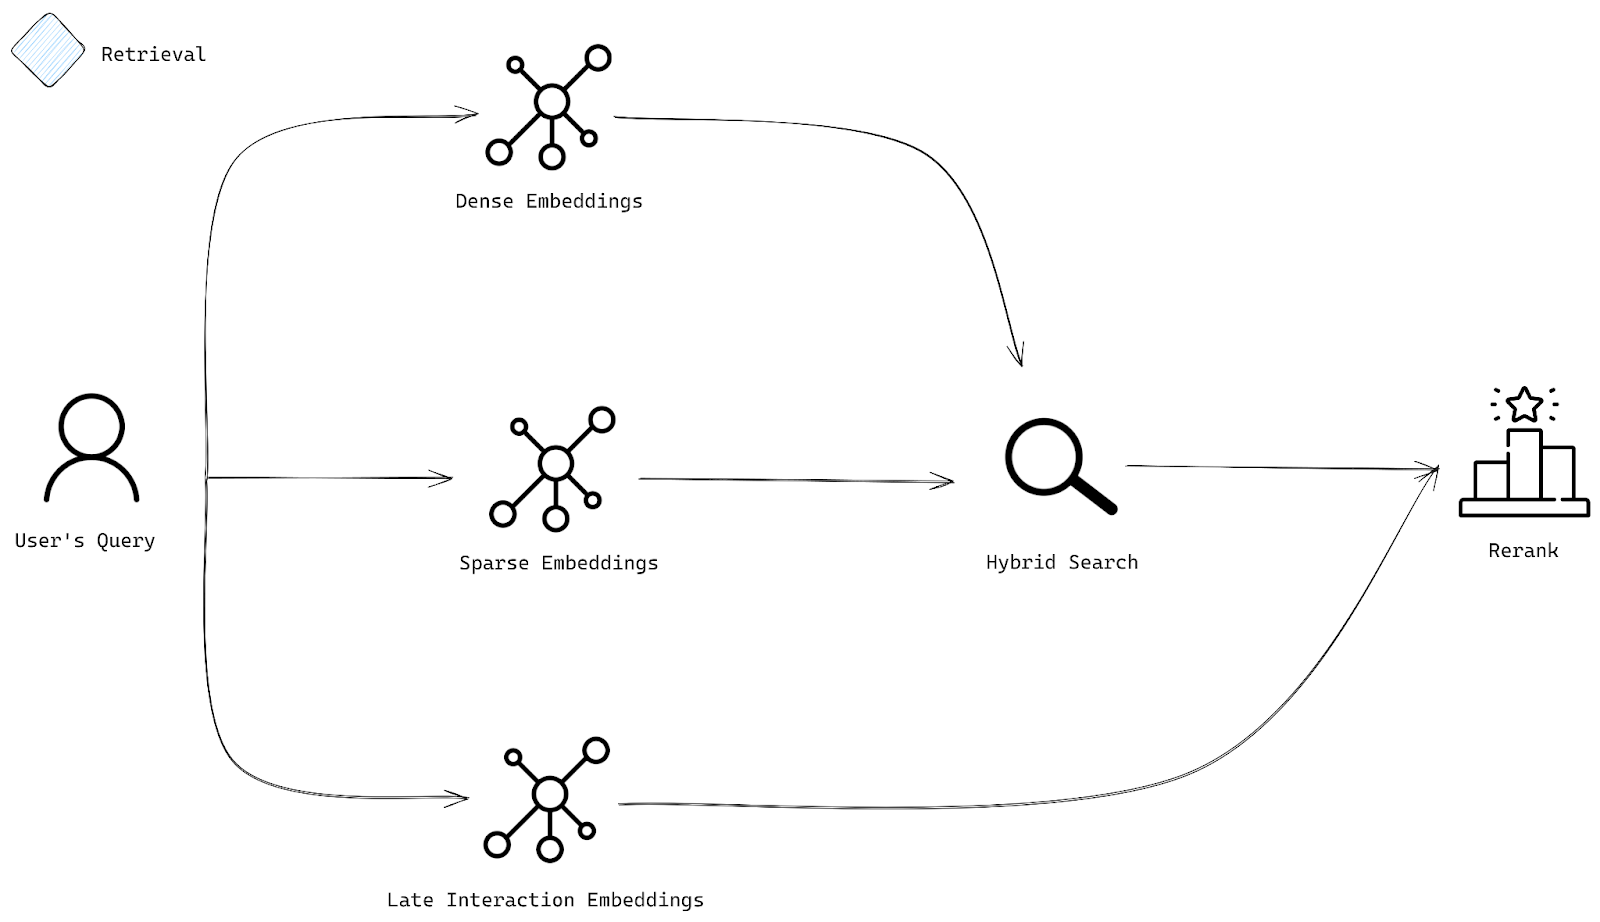
Qdrant混合搜索结合稠密和稀疏检索,通过ColBERT重排序提升搜索结果相关性。本文介绍如何在Qdrant中实现混合搜索,利用不同类型的嵌入创建高效搜索系统,确保最终结果符合用户意图,提升搜索体验。
完成下面两步后,将自动完成登录并继续当前操作。