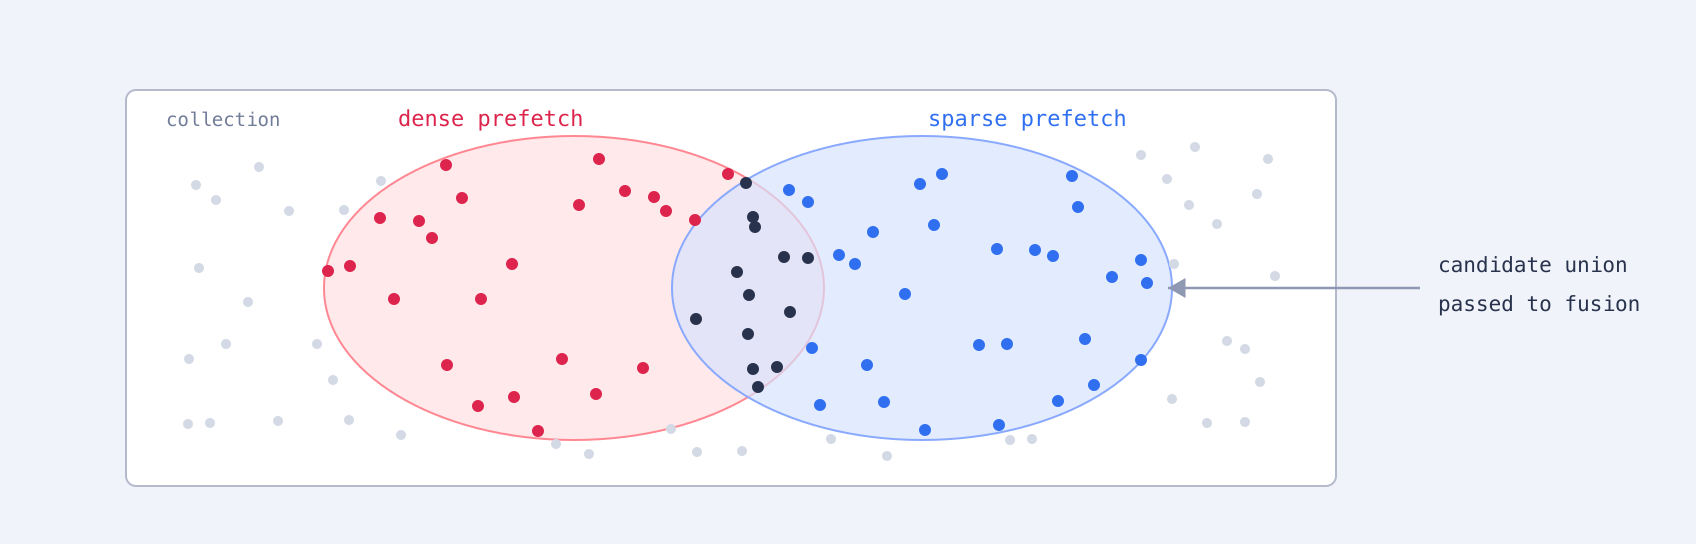
混合搜索结合稠密与稀疏检索,兼顾语义相似与精确词匹配。稠密检索擅长同义改写,稀疏检索(如BM25)擅长标识符和专有词。融合方法中,RRF按排名合并以避免分数尺度差异,DBSF则归一化分数。在五个公开数据集上,默认RRF在四个上优于单一检索器。但混合搜索增加存储、索引和查询延迟,需实测收益是否值得成本。
随着数据集规模的增大,训练大型人工智能模型面临不同社群价值观的风险。研究表明,使用过滤后的网络数据也能训练出性能良好的语言模型。文章探讨了稠密检索模型的缩放规律,提出了对比对数似然作为评估指标,并通过实验验证了其性能与模型大小和注释数量的关系。此外,研究还提出了在数据稀缺情况下优化模型的方法,强调高质量数据的重要性。
本文综述信息检索中的稠密检索技术,涵盖Learning To Retrieve、生成检索、深度提示调整、SPTAR、RA-DIT、零样本DR、DDR等模型,并探讨低资源情境下基于预训练语言模型的稠密检索方法,按资源需求分类总结各技术算法、优缺点及未来方向。
该文汇总了信息检索与推荐系统的多项研究,包括:结合深度神经网络与词汇模型提升检索效果;在LinkedIn招聘场景中融合文本、语义与位置信息构建检索系统;利用数据挖掘推断搜索意图并实现个性化;提出LTRe训练技术优化稠密检索;结合知识库增强简历匹配;以及基于实体建模的候选实体检索框架。
该文综述课程学习研究,提出动态课程学习框架,在线调整采样策略与损失学习,在CelebA、RAP等数据集上达到最优;CL-DRD优化稠密检索;自适应自我学习曲线SPDCL应对不平衡数据;DDaCLAE通过能力估计选择数据;课程学习还应用于低资源机器翻译、人群计数等任务,证明其能提升性能与收敛。
本文提出了信息检索和自然语言处理的概念框架,整合了稠密和稀疏检索方法,分成逻辑评分模型和物理检索模型。作者提出了度量器和比较函数,计算查询-文档分数,并分析了密集与稀疏表征和监督与无监督方法的影响。提供了一个研究路线图,为未来工作提供方向。
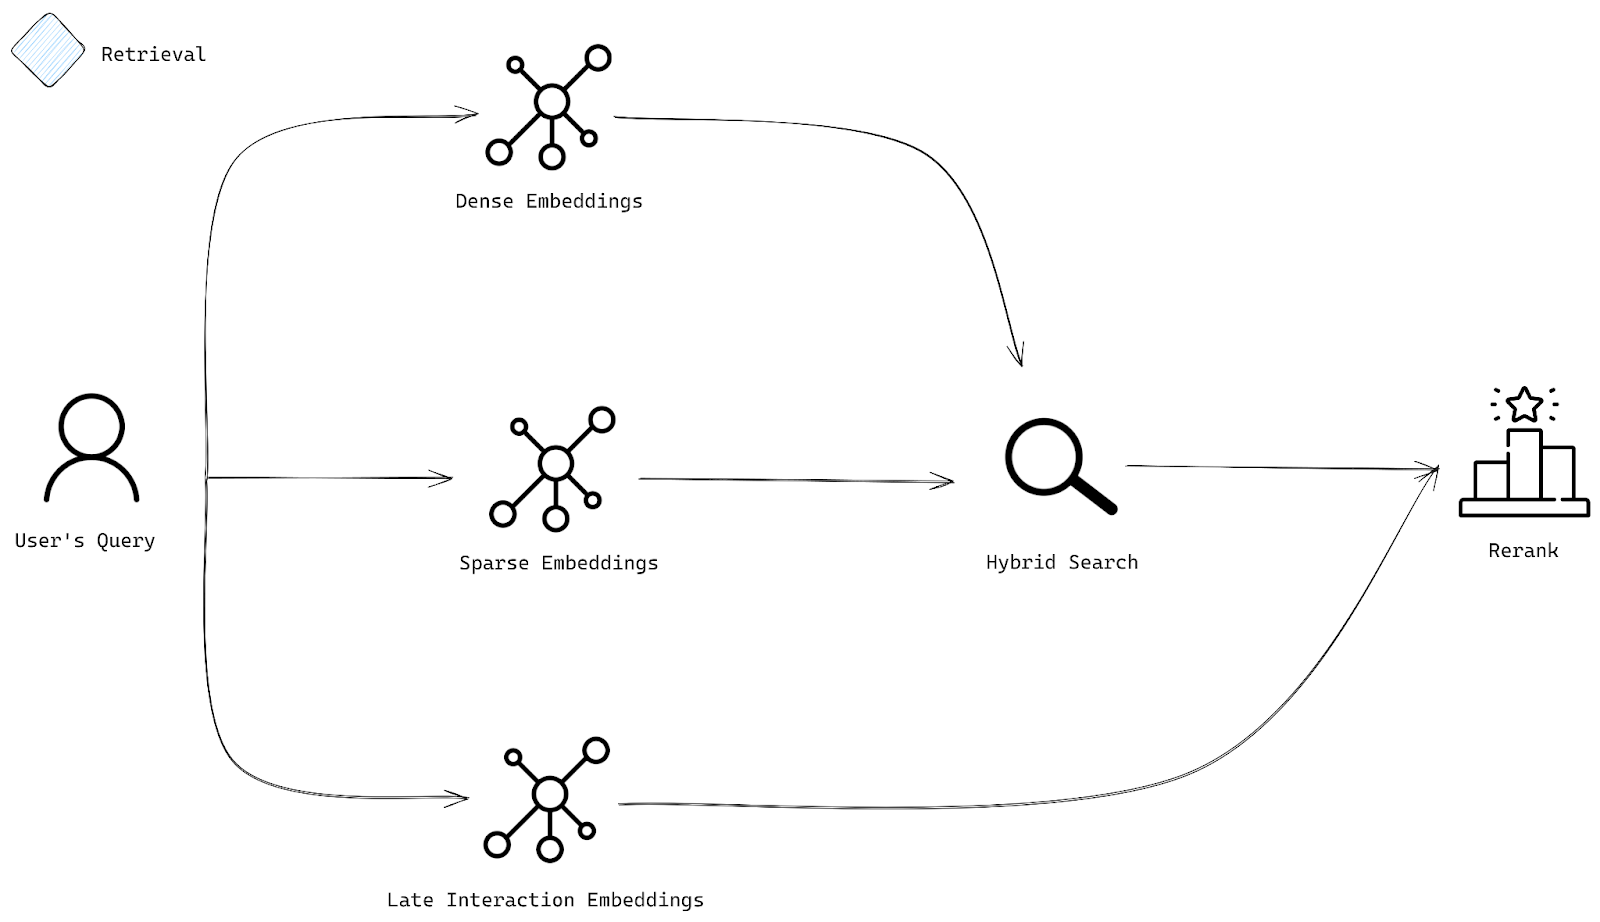
Qdrant混合搜索结合稠密和稀疏检索,通过ColBERT重排序提升搜索结果相关性。本文介绍如何在Qdrant中实现混合搜索,利用不同类型的嵌入创建高效搜索系统,确保最终结果符合用户意图,提升搜索体验。
完成下面两步后,将自动完成登录并继续当前操作。