Databricks 用同一 AI 代理对 528 个数据管道进行基准测试,比较过程式 PySpark 与声明式 Spark Declarative Pipelines。结果显示:声明式可在运行前预检结构错误,集群计算时间减少约 34 倍;代码量约为过程式一半(中位数 64 行对 131 行),且更一致;但两者对逻辑错误的检出率相近。声明式前期 LLM 令牌成本约高 2.3 倍(约 0.50 美元对 0.26 美元),但令牌成本固定,而集群浪费随数据规模增长,故生产规模下声明式更划算。
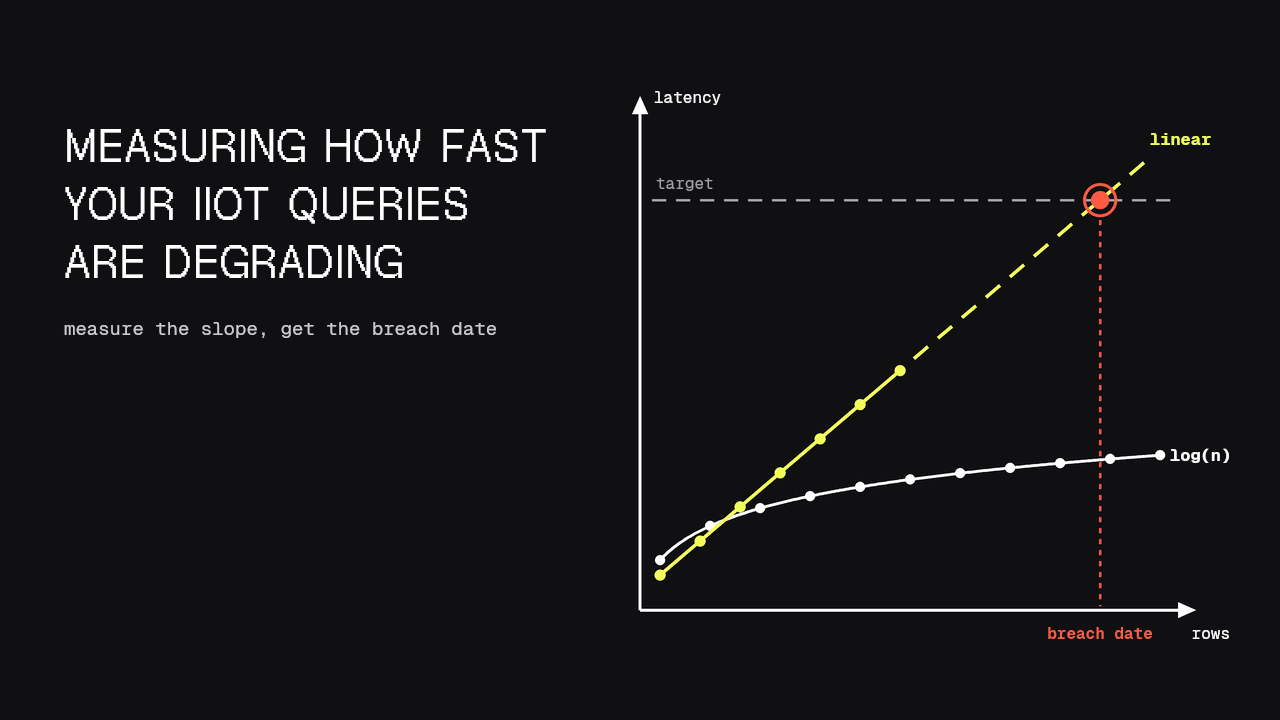
通过记录工业物联网数据库查询延迟与数据行数的关系并拟合曲线,可预测查询何时超出目标延迟,提前发现仪表板变慢问题,避免被动等待。
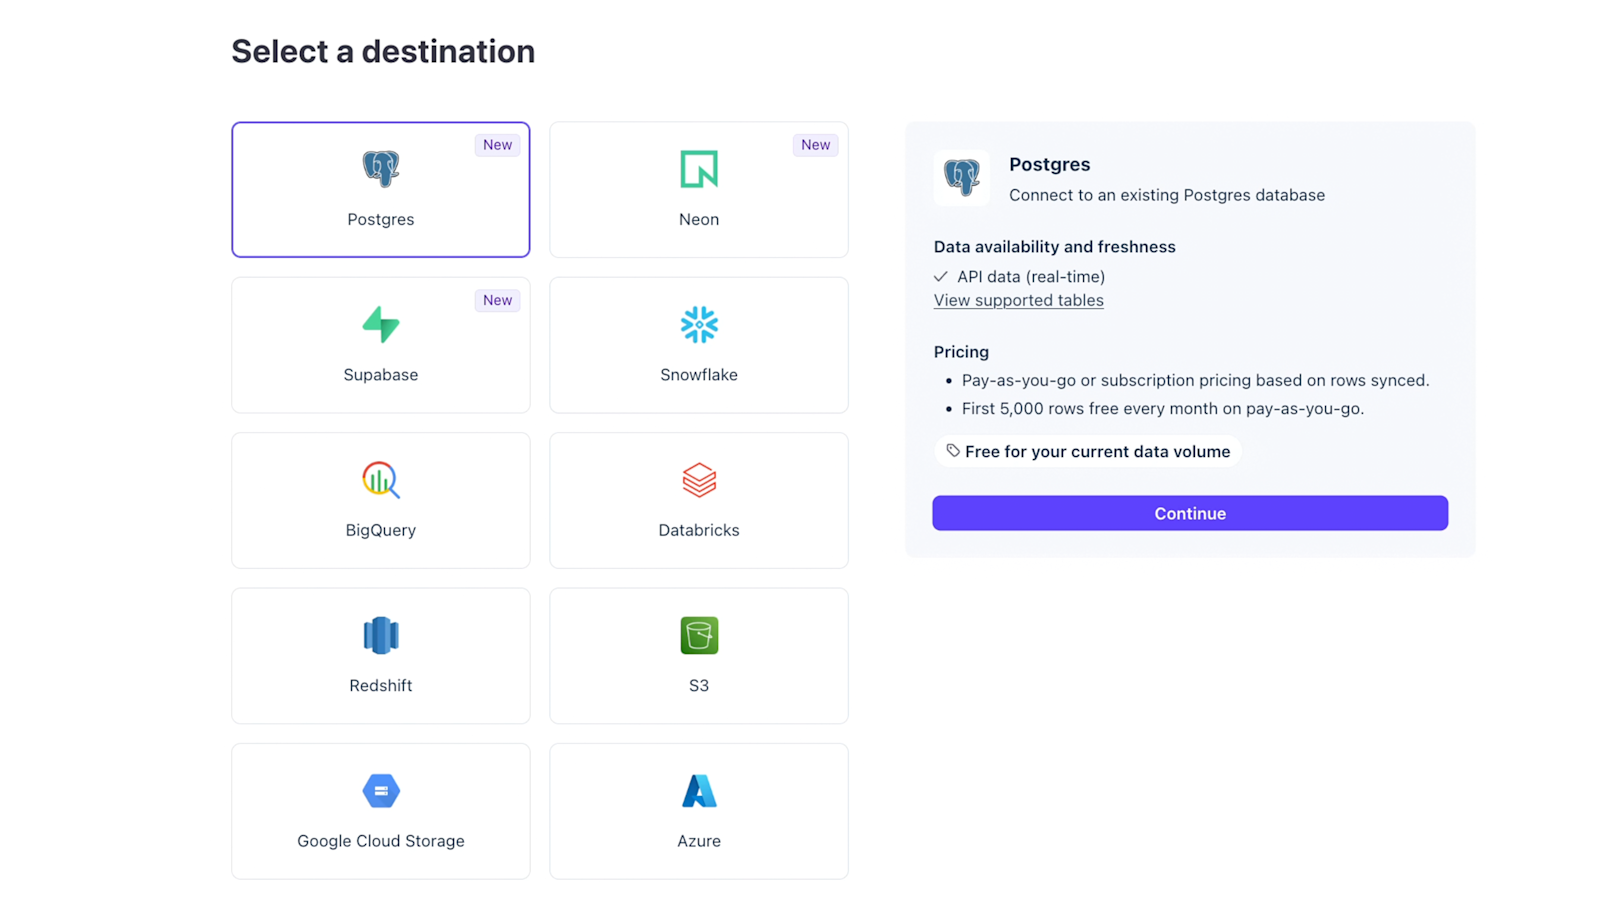
Stripe数据管道新增实时同步至Postgres功能,支持目标为Databricks Lakebase。Stripe可将支付、客户、订阅等数据在数秒内同步至Lakebase,供应用实时查询,无需自建API或webhook集成。应用可即时更新订阅权限、展示账单、构建销售仪表盘并推送个性化优惠。该功能已公开预览,可免费使用。
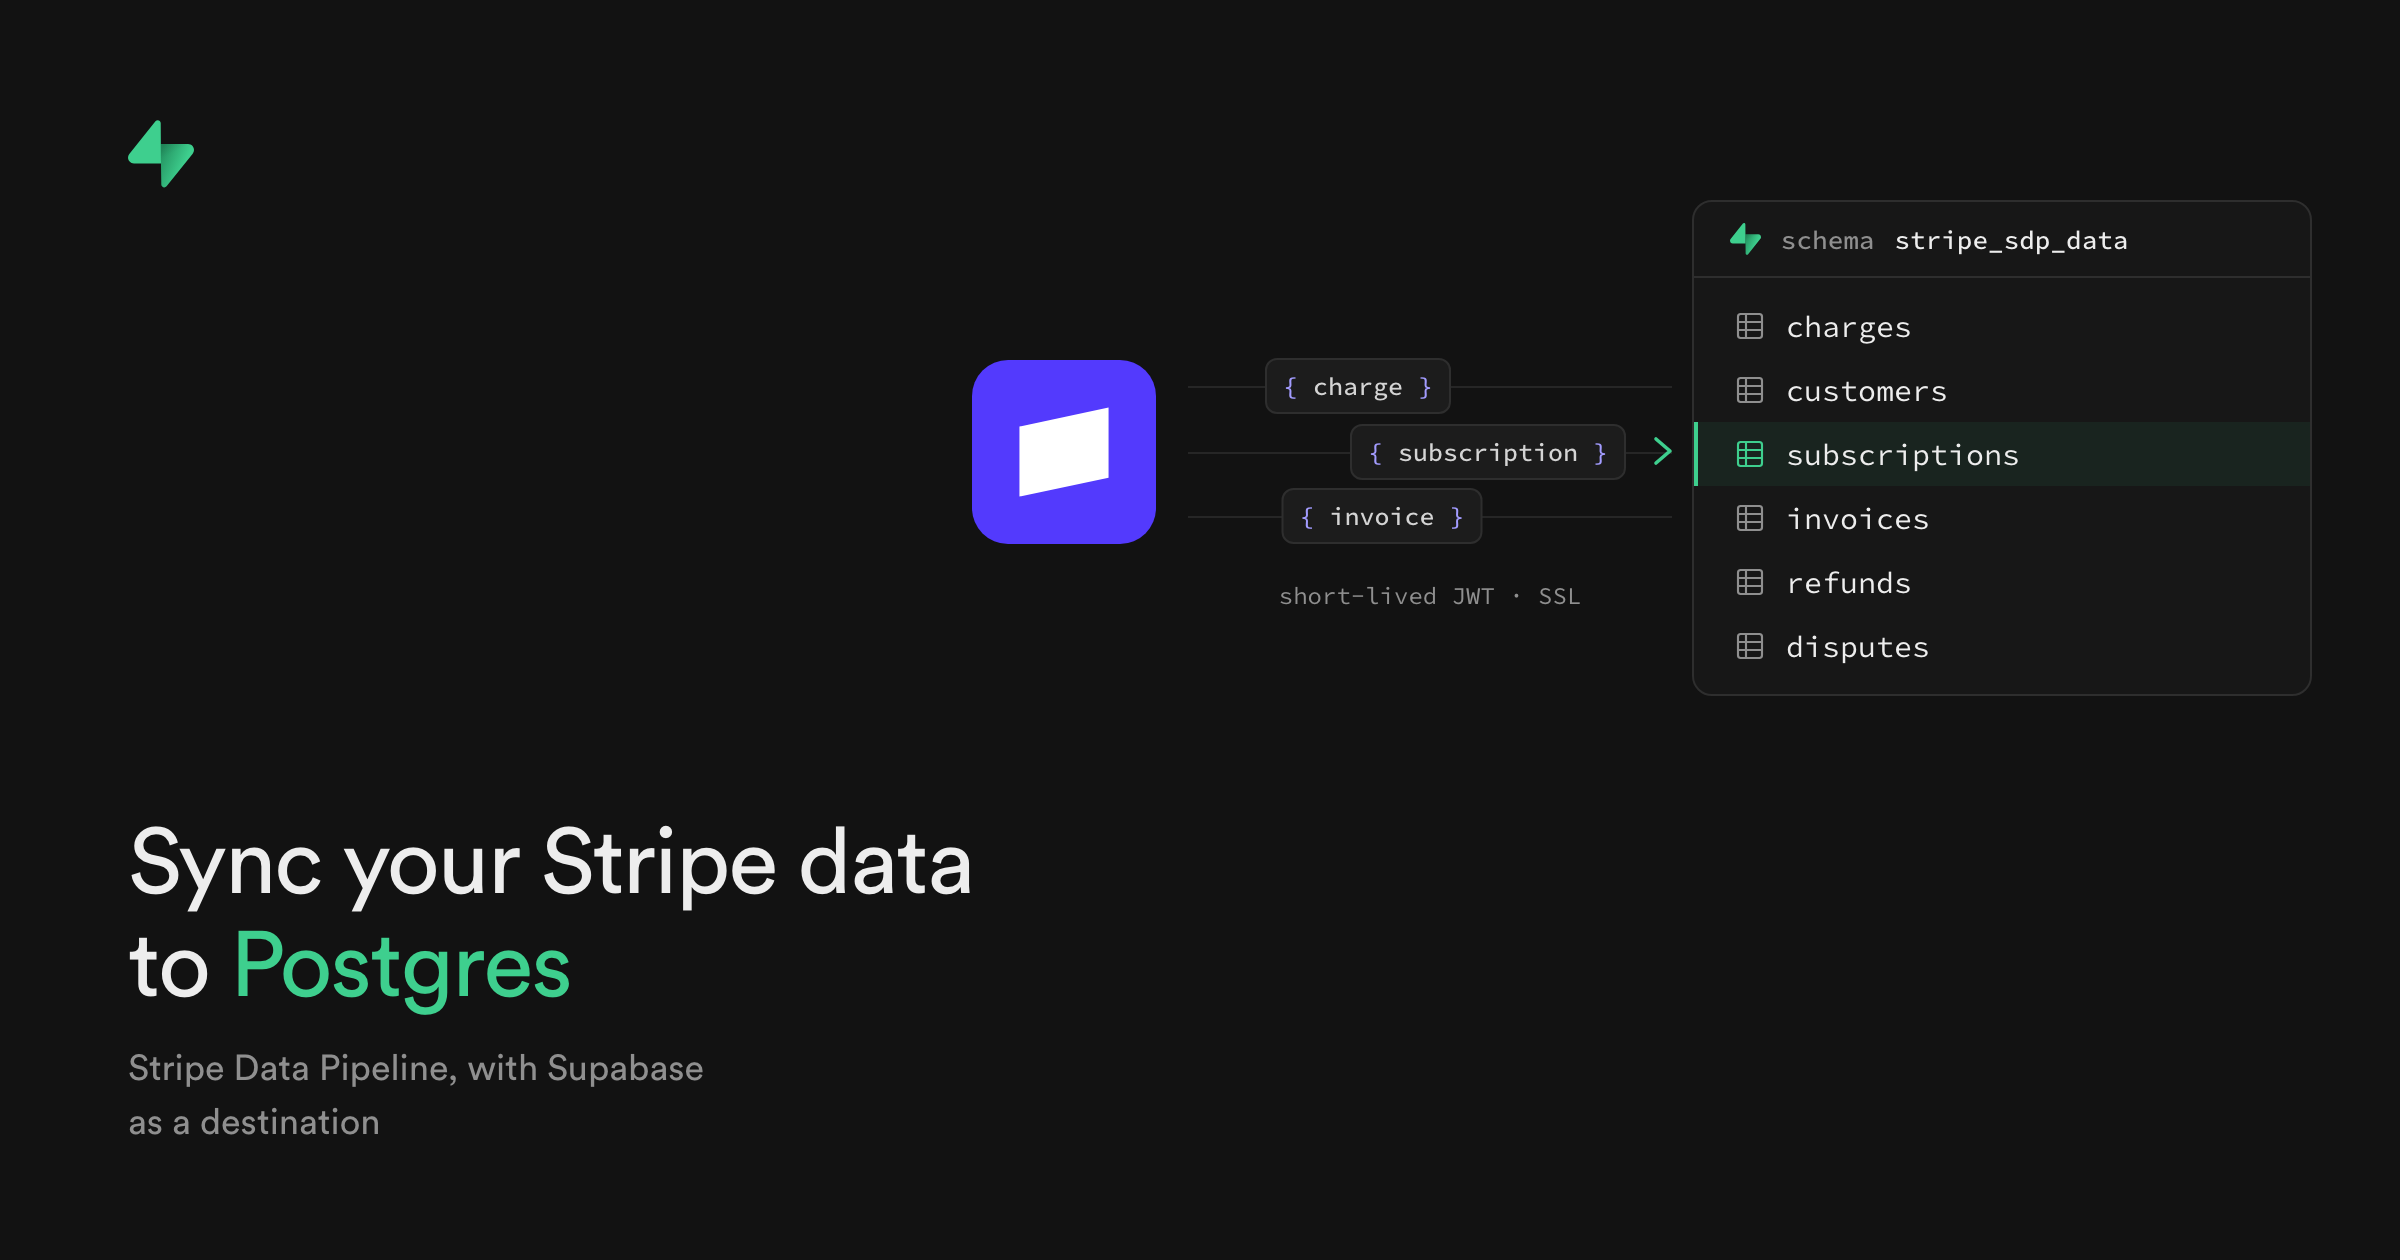
Stripe 数据管道新增 Postgres 支持,Supabase 成为首批可连接目标。用户可在 Stripe 后台直接连接 Supabase 项目,自动回填并持续同步支付、客户、订阅等数据到专用 schema,无需维护 webhook 或担心 API 限流。数据可用标准 SQL 查询,并与应用数据关联,实现功能门控和收入指标计算。
Stripe推出数据管道实时同步功能,可将支付、客户、订阅等数据直接同步至Postgres数据库,无需编写代码。系统自动回填并持续更新数据,定期校验一致性,省去开发者自建API和Webhook的维护工作。该功能已公开预览,免费使用,未来将支持更多数据平台。
湖仓系统第三阶段写入管道中,INSERT 先将数据写入 Parquet 文件并收集列统计,再原子注册到元数据目录。核心原则是先写文件后更新元数据,确保崩溃时仅产生孤儿文件,避免元数据指向缺失文件。事务提交时创建新快照,记录写入文件、列统计与审计日志。
将现有 dbt 项目迁移到 Databricks 无需重写模型或业务逻辑:更换 dbt-databricks 适配器、配置 profiles.yml、映射三级命名空间,并处理 regexp_substr、div0、object_construct 等 SQL 方言差异;用 dbt-audit-helper 逐模型比对输出,验证后通过 Lakeflow Jobs 调度生产,实现安全切换。
Intuit 在 TurboTax 报税数据处理中,需在保护 SSN 等敏感 PII 的同时支持等值查询。文章比较了概率加密、确定性加密、HMAC 和令牌化等方案,并涉及 AES、HKDF 密钥派生、密钥分离、KMS/HSM 密钥管理及本地与远程加密的权衡。核心观点是加密需结合 IAM、审计和最小权限,架构设计应兼顾安全与业务需求。
管道体积计算器可根据管道半径、直径、长度或体积等已知条件,估算管道容积与介质容量。计算公式为体积=π×半径²×长度,π约取3.14159,结果以立方米显示。
“老董工具箱”提供管道重量计算器,可输入钢管外径、壁厚、长度及钢材密度(碳钢、不锈钢、合金钢或自定义),计算每米重量和总重量,也能按目标重量反推所需长度。另有规格查询功能,并列出管道体积、箱子体积、能量转换、自流平地板、表面传热系数、装修地砖等相关工具。
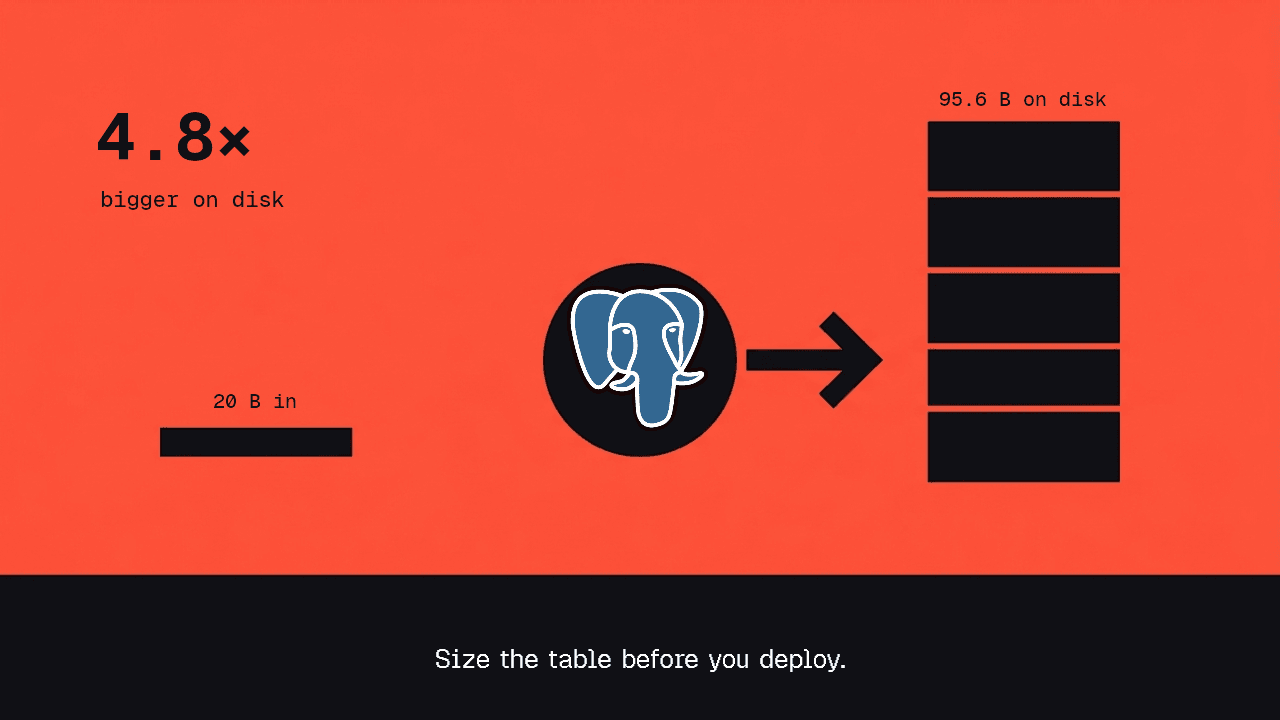
工业物联网数据库容量规划:20字节传感器读数实际占磁盘95.6字节,部署前需测量每行字节数、预估6310亿行规模、测试写入上限并评审表结构。
Redis Data Integration(RDI)新增多源管道功能,支持将Snowflake、MongoDB、Oracle、MySQL、PostgreSQL等多个源数据库接入单一管道,捕获并转换数据后加载到同一Redis目标库,形成统一低延迟数据层,减少应用层数据拼接和独立集成部署。未来将支持多管道,使单次RDI安装服务整个集成架构,便于分离工作负载并随需扩展。
DataTalks.Club 提供五个免费社区驱动的 Zoomcamp 课程:数据工程、机器学习、MLOps、LLM 应用开发和 AI 开发工具,涵盖数据管道、模型部署、RAG、AI 编程助手等实用技能,配有作业和项目。学员可参加直播同期班或按自己的节奏学习,材料长期开放,许多人借此提升技能、转行或晋升。
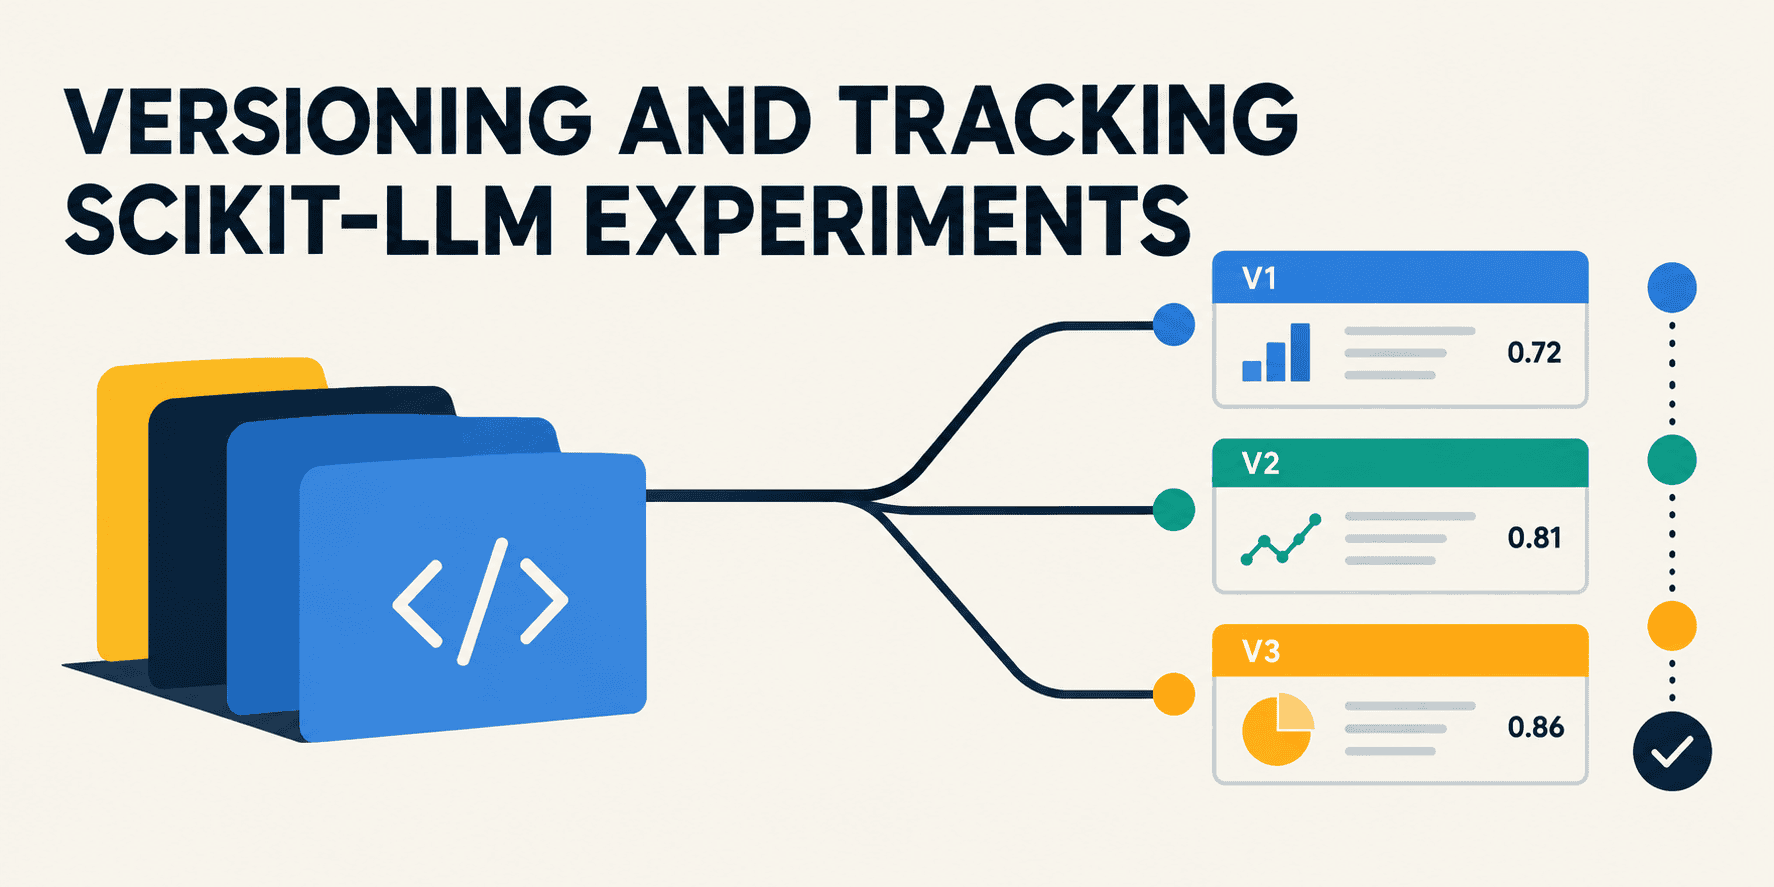
本文介绍如何使用Scikit-LLM与MLflow构建、跟踪、比较和注册集成大语言模型的scikit-learn管道。通过配置本地gpt4all模型执行和MLflow跟踪,记录基线及升级版管道版本,利用搜索API审计运行状态,并基于性能指标选择最佳模型注册至Model Registry,确保版本可复现和部署管理。
文章介绍如何通过GitHub Webhook和OpenTelemetry Collector的githubreceiver组件,零侵入地收集组织级CI工作流追踪数据。它无需修改各仓库工作流文件,自动覆盖所有现有及未来仓库,将工作流、任务和步骤映射为OTLP追踪跨度,并集成到现有追踪后端。文章还讨论了部署注意事项、数据量估算方法及获取团队支持的建议。
戴森发布两款新护发产品:Corrale CoolShine直发器(329美元)和Airsmooth烘干刷(249美元)。前者采用液体冷却管道,加热后迅速降温以减少热损伤;后者使用防缠绕环状刷毛,结合智能温控(每秒调节100次),减少毛躁并保护头皮。
EveryCityMap通过OpenStreetMap数据管道构建城市地图:先收集完整城市数据并重建边界,填充海陆,再分割为预览、核心、细节增量及存档四个PBF块,经CDN和IndexedDB缓存,最终用Canvas2D渲染。系统确保数据一致性,支持渐进加载和主题切换,当前稳定版含535个城市。
npm 注册表遭蠕虫攻击,恶意包自更新并窃取凭证,已进化多代,最新变种利用合法签名管道绕过验证。攻击源于自动化发布和长期凭证,影响 npm 及 Terraform 等基础设施。防御需固定依赖版本、限制来源、使用短期凭证、控制网络出口,并视构建管道为关键基础设施。
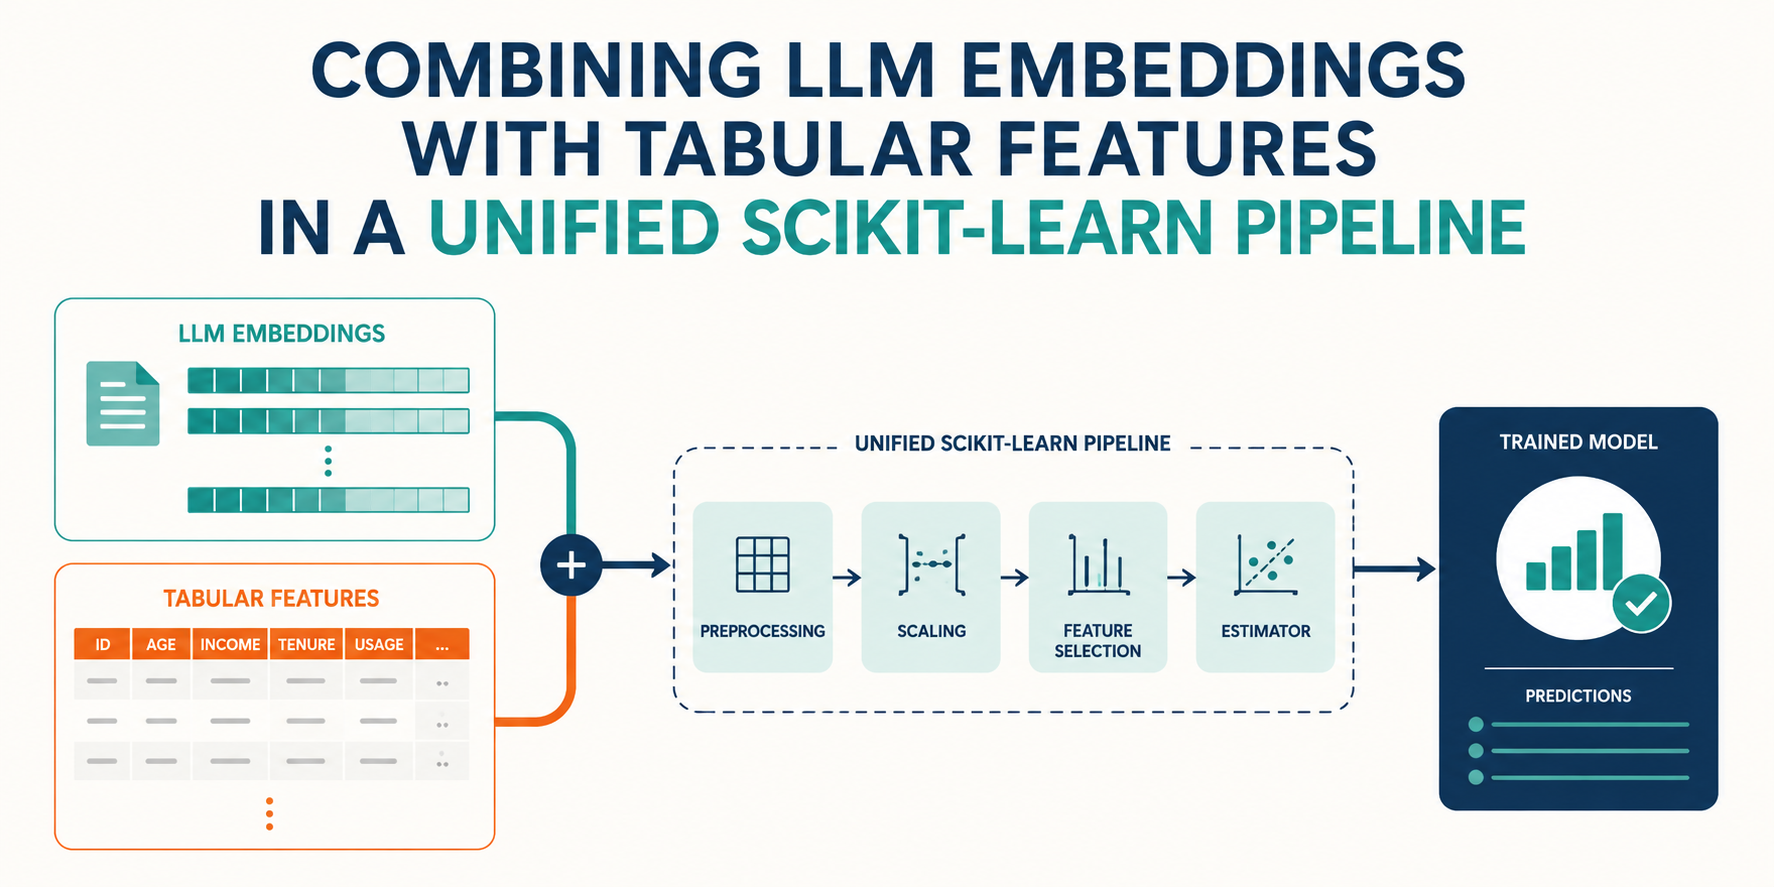
本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。
本文介绍etcd v3.5.33中Raft提交条目如何通过apply管道转为MVCC revision并触发Watch。核心是区分committed index与applied index:commit仅表示日志复制完成,apply才更新MVCC状态。applyAll循环处理快照和条目,treeIndex内存索引过滤revision后批量读bbolt。Watch在事务End时同步通知。apply滞后会通过ErrTooManyRequests背压客户端,排障需区分Raft复制慢还是apply慢。
完成下面两步后,将自动完成登录并继续当前操作。