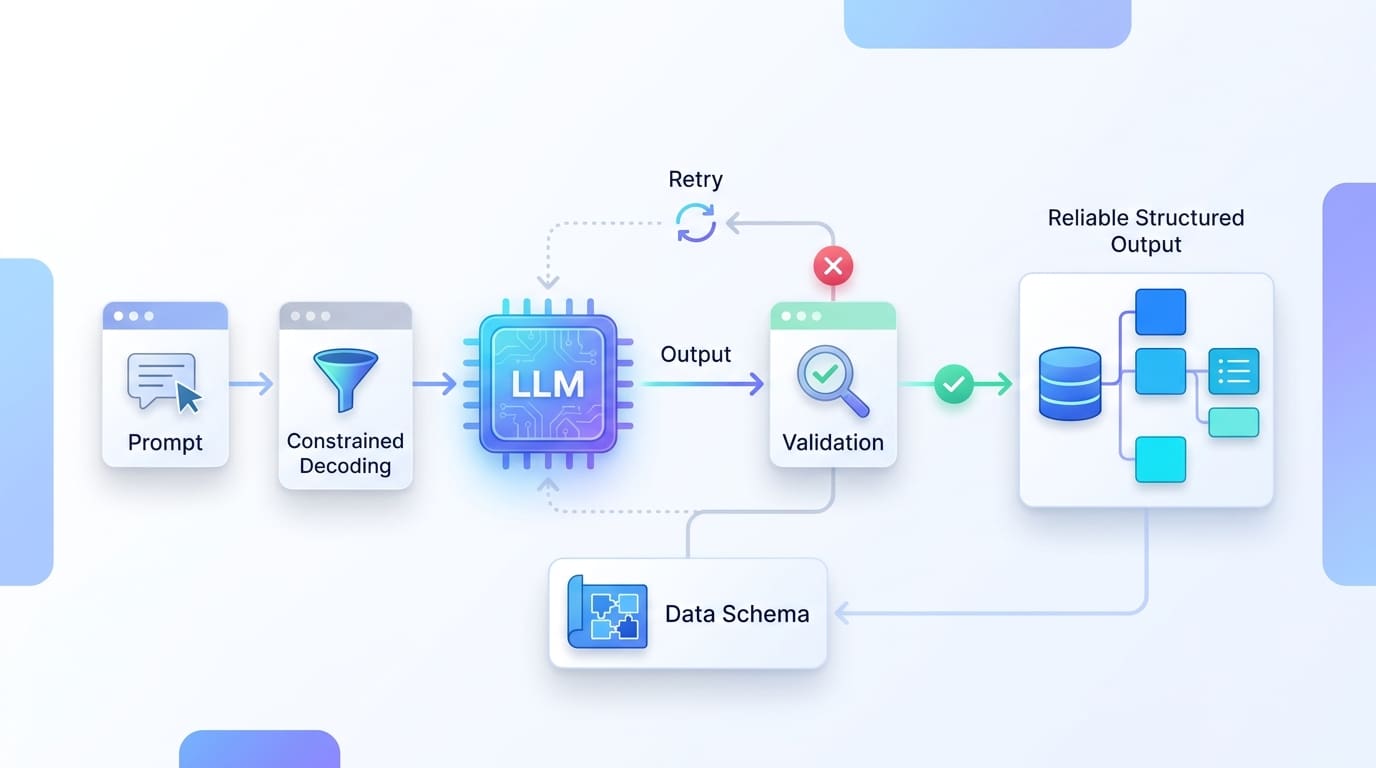
文章指出,仅靠JSON解析或模式校验不足以保证LLM结构化输出正确,例如发票金额12500与原文1250.00不符。应建立三层防护:用严格Pydantic契约校验形状;对照源文本检查引用、币种和金额一致性;仅在形状错误时有限重试(最多三次),并关闭SDK隐藏重试。优先使用约束解码减少格式错误,但保留源校验。结果分为接受、需人工复核、拒绝和形状错误,只有接受结果进入下游。
本文介绍实用约束解码(结构化生成),通过有限状态机在推理时屏蔽非法token,强制LLM输出符合JSON、正则等格式。以outlines库为例,展示如何用Pydantic模型约束输出,保证语法正确、节省提示词token,并提升小模型可靠性。虽首次运行较慢,但整体高效,适合需严格格式的场景。
本研究提出了一种基于自适应加权拒绝采样的快速受控生成语言模型方法,解决了局部约束解码的高成本和全局字符串分布扭曲问题。该算法显著减少了约束评估次数,并提供低方差的无偏重要性权重估计,实验证明其在多种应用中优于现有方法,提高了速度和性能。
CRANE系统结合约束解码与大型语言模型,实现复杂推理任务95%的准确率,保持自然语言流畅性并遵循逻辑约束,优于传统模型。
本文提出了一种基于词典的约束解码方法DECIDER,旨在通过特定目标概念控制生成文本的意义和风格。研究表明,该方法能有效引导生成结果,提升大型语言模型的决策性能。此外,介绍了选择性去偏差方法和成本敏感的推迟框架DeCCaF,以提高模型的预测性能和公平性,减少错误分类成本。
本文综述可控文本生成研究,重点包括:通过语义分离的潜在表示,结合变分自编码器与属性判别器,实现可解释、高效的多属性句子生成;后续方法涵盖对齐属性表示、因果结构模型、约束解码、MuCoCO优化算法、属性分布交集搜索、Gamma Sampling无训练采样及FVN离散潜空间等,在情感、主题、机器翻译和风格转移任务中提升控制准确性与生成质量。
本文综述了基于约束解码控制大语言模型生成的方法,包括:用形式语法约束保证结构化输出的语法正确性,提升信息抽取与实体消歧效果;用鉴别器引导树搜索控制长文本生成,避免微调;推测性对比解码兼顾质量与算力;概率位移确保关键词出现;GRACE以判别模型调整解码提升多步推理;控制解码用前缀评分器进行离策略强化学习;未来约束生成减少有害行为;递归解码改进seq2seq;以及医学报告生成与MaskSketch图像生成等应用。
完成下面两步后,将自动完成登录并继续当前操作。