文章指出用户反馈机制(如点赞)无法表达复杂体验,批评专业领域过度简化数据,忽视个体差异,建议关注价值观、细微差别和愿景,而非仅依赖数字,但此类反思常因缓慢而被忽略。
菲利普·伊索拉研究人类智能与机器智能的关系,专注于计算机视觉和机器学习。他认为理解AI的智能机制有助于安全有效地将其融入社会,研究内容包括自监督学习和表示学习,旨在揭示人类与机器智能的共同点。
大型语言模型(LLMs)在生成可靠输出时面临挑战。检索增强生成(RAG)通过外部知识改善这一问题,但基于向量的方法在处理复杂关系时存在局限。GraphRAG结合知识图谱,提升了准确性和可解释性,适合多跳推理。选择RAG或GraphRAG应根据具体应用需求。
本研究探讨了翻译低资源语言的挑战,提出将大型语言模型与检索增强生成结合的创新方法。研究发现,最佳模型通过检索与高级语言建模的结合,显著提升了专业和文化细微术语的翻译质量,并强调了与当地社区的伦理合作和领域知识的重要性,为提高翻译的准确性和流畅性提供了一个有效框架。
GNU较小通用公共许可证(LGPL)2.1在开源软件中具有重要意义,允许开发者在特定条件下将开源库与专有软件结合,促进合作。文章讨论了LGPL 2.1的历史、目的及其对社区的影响,强调其在自由与商业利益之间的平衡,尽管面临法律挑战,仍支持创新与社区合作。
微软公共许可证(Ms-PL)是开源许可的重要典范,促进了创新与社区合作。文章分析了其历史、优缺点及与其他许可证的比较,强调法律简洁性与商业自由的平衡。尽管Ms-PL降低了创新门槛,但也面临保护开发者权益的挑战,呼吁未来许可模式的演变以实现更公平的数字生态。
在SQL中,事务确保数据的完整性和一致性,分为隐式和显式两种。隐式事务自动管理,适合简单操作;显式事务需手动定义边界,适合复杂操作。事务遵循ACID原则,确保操作要么全部成功,要么全部失败,同时需考虑错误处理以维护数据库一致性。
本研究分析了ChatGPT在翻译阿拉伯誓言时的表现,指出其在宗教和文化理解方面存在明显不足,强调了改进的必要性。
AssemblyAI挑战于11月24日结束,鼓励开发者利用其语音AI模型进行创新。参赛者需提交应用以赢取奖金和奖品,并可获得$50免费信用。重要日期包括11月13日开始、24日截止及12月5日公布获奖者。
Java中的Scanner类用于获取用户输入,但开发者需注意一些细节。使用nextLine()可读取多行输入,而next()仅读取到空格。调用nextInt()等方法后,需使用nextLine()清除缓冲区中的换行符,以避免干扰输入流。建议在混合输入时谨慎管理缓冲区,并在使用后关闭Scanner实例。
作者使用Python创建了一个用于亚马逊注册的CAPTCHA绕过脚本。尽管经过多次测试,脚本在处理复杂CAPTCHA时仍不稳定,尤其是第二个CAPTCHA。作者寻求优化建议,并分享了脚本的基本步骤和所需库。虽然脚本有效,但偶尔会出现卡顿,且未能解决FunCaptcha问题。
GitHub更新透明中心,发布2024年上半年数据。DMCA下架通知因单一事件显著增加。GitHub面临管理挑战,政策团队为开发者和开源软件利益倡导。开源软件是经济基础设施,需谨慎管理以保持代码可访问性。信任与安全团队调整内容管理策略,并在《在线信任与安全杂志》探讨管理挑战和AI机遇。
本研究探讨了人工智能在写作中的应用,发现多词语建议能提升非母语人士的创造力,但降低效率。研究还分析了AI对写作质量和用户体验的影响,强调了文化偏见问题,并提出改善策略以促进文化多样性和公平性。
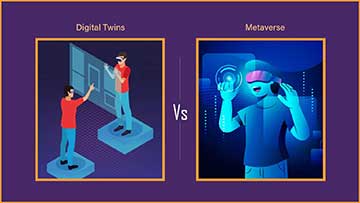
元宇宙和数字孪生是当前IT行业的热门话题,前者创造了完全沉浸式的3D环境,后者在虚拟领域中复制真实世界环境。23%的组织正在探索元宇宙和数字孪生的潜力,61%正在定义业务案例,16%需要专业知识来推进项目。元宇宙是全球3D网络,数字孪生是复杂虚拟模型。元宇宙对沉浸感要求更高,视觉效果质量较低,不需要物理对应物。数字孪生依赖于现有物理对象,严重依赖实时数据集成。数字孪生在塑造元宇宙中起到重要作用,提供真实感和功能性。
本文研究了大型语言模型(LLMs)在情感识别中的应用,提出了MERR数据集和Emotion-LLaMA模型,结合音频、视觉和文本输入,显著提升了情感识别能力。通过多模态信息和上下文调整,DialogueLLM克服了LLMs的局限性,并在多个基准数据集上表现优异,展示了其在多模态情感识别中的潜力。
该文综述多项自然语言处理研究,聚焦网络滥用、仇恨言论、假新闻与争议检测,涵盖边缘社区言论过度惩罚、争议战术框架、MythQA事实核查、众包知识图谱、伦理原则及论证挖掘,旨在提升检测准确性与公平性。
COPAL-ID是一个公开可用的印度尼西亚语常识推理数据集,结合了印度尼西亚的当地文化细微差别,提供了更自然的印度尼西亚文化领域内的日常因果推理描绘。研究发现,目前最好的开源多语言模型在COPAL-ID上表现不佳,与文化无关的XCOPA-ID相比,准确率显著降低,这说明这些语言模型在理解印度尼西亚本土细微差别方面仍然落后于人类。
本文研究了引导语言对幻觉出现的影响,发现正式性和具体性较高的引导语言会减少幻觉出现,但可读性与幻觉出现的关系不确定。
文章主要讨论表单字段的细微差别,强调在设计和使用表单时捕捉这些差别的重要性,以优化用户体验。
文章讨论了自定义表单控件的问题,指出这些控件会增加用户填写表单的时间,尤其对有特殊需求的用户(如盲人)造成困扰。标准浏览器控件设计考虑了可访问性,使用更高效。作者建议避免使用JavaScript自定义控件,认为内置控件已足够满足需求。
完成下面两步后,将自动完成登录并继续当前操作。