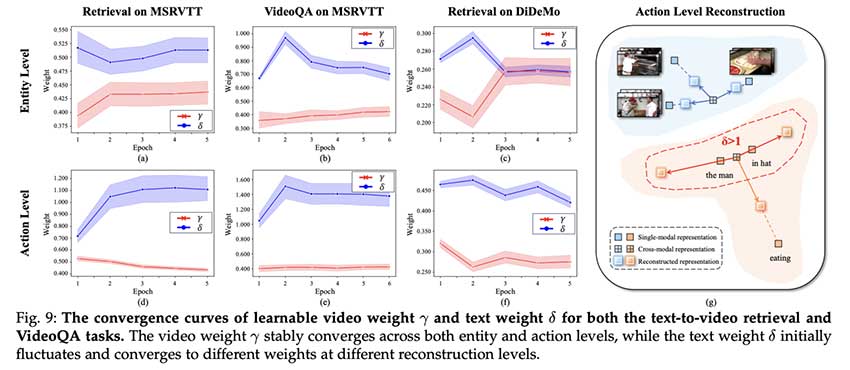
视频语言表征学习关注视频与文本描述的关系,HBI V2通过博弈论解决细粒度对齐问题,结合单模态和跨模态表征,提升了视频语言学习的效果。HBI V2在多项任务中表现出色,展现了其灵活性和有效性。
本研究提出了一种新的视频上下文关键词注意力模块,旨在提升视频时刻检索和高亮检测的上下文捕捉能力。实验结果表明,该方法在细粒度对齐方面显著优于现有技术。
本文介绍了多模态大型语言模型AlignGPT及其在文本到图像生成中的应用。通过人类反馈和细粒度对齐方法,显著提升了模型性能。同时,研究提出了新的评估框架GenEval,以分析生成模型的能力和不足,推动文本到图像模型的发展。
该论文提出了TG-3DFace和M3Face等多种基于文本的3D人脸生成方法,利用对比学习和细粒度对齐技术,实现高质量、语义一致的人脸图像生成。研究展示了文本引导的三维人脸合成和编辑的优势,提升了几何与纹理的一致性,并引入新的生成框架和编辑策略,显著提高了人脸合成的精度和质量。
本文综述视觉语言预训练模型的跨模态语义对齐机制,指出现有模型主要对齐对象和视觉词,忽略全局语义,存在固定句式、无视语法流畅性等问题。多项研究提出改进方案:单通道架构实现全局、图块—令牌、概念多层次对齐;MVPTR实现多层语义对齐;SemVLP结合单双流对齐不同语义粒度;CL2CM实现跨语言迁移;多粒度框架用于医学图像;聚类表示学习等,提升细粒度对齐与数据效率。
本文综述细粒度视觉—语言对齐研究:SPRM以弱监督学习短语与边界框对应;单通道架构通过跨模态重建和伪标签关键字预测实现多层级对齐;FILIP采用后期交互机制;Sparc改进短语嵌入;SRC进行正则化与解耦对比学习;LOUPE基于博弈论交互实现语义对齐;SelfAlign以自监督对比学习对齐;FineCo用细粒度对比损失处理视频;FineRewards引入两种语义奖励提升图文匹配。
完成下面两步后,将自动完成登录并继续当前操作。