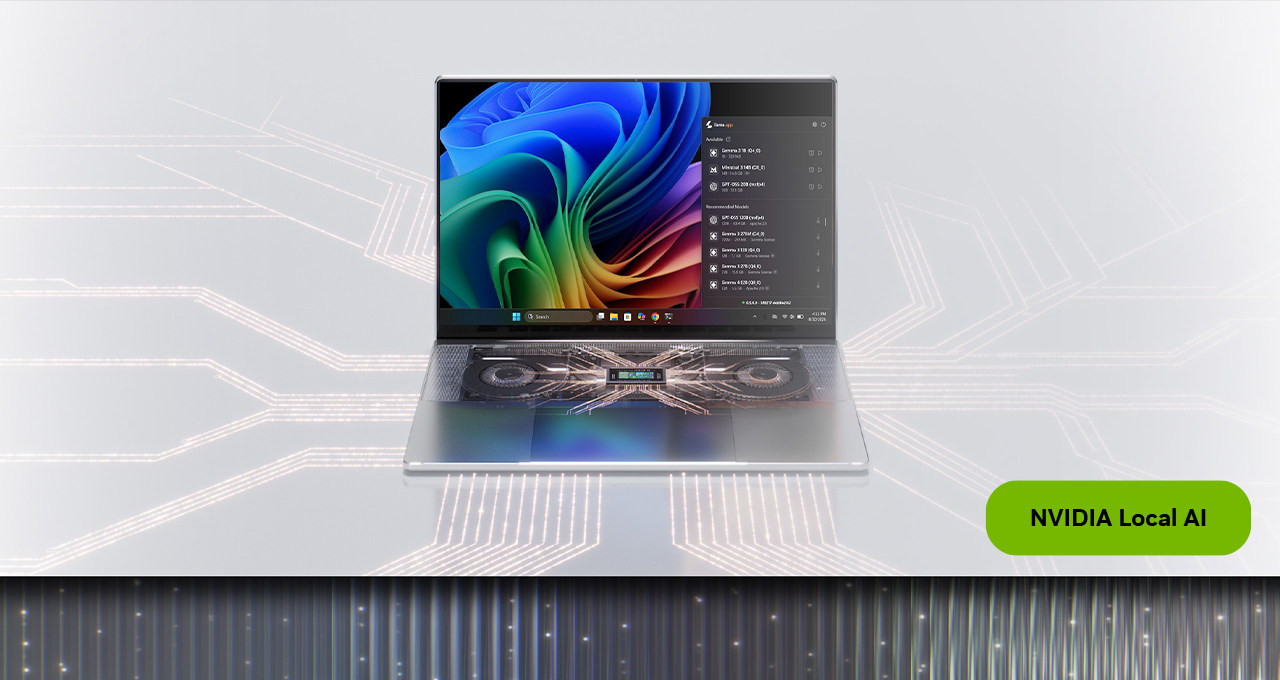
英伟达RTX Spark超级芯片将于10月16日随笔记本上市,整合游戏、创作与本地AI,最高128GB统一内存、1 petaflop算力。届时数千款应用、游戏和模型就绪,包括Nemotron 3.5 Bolt 74B本地智能体模型、PAIR正式版、Broadcast 2.3、DLSS 5及Adobe、Blender等优化。
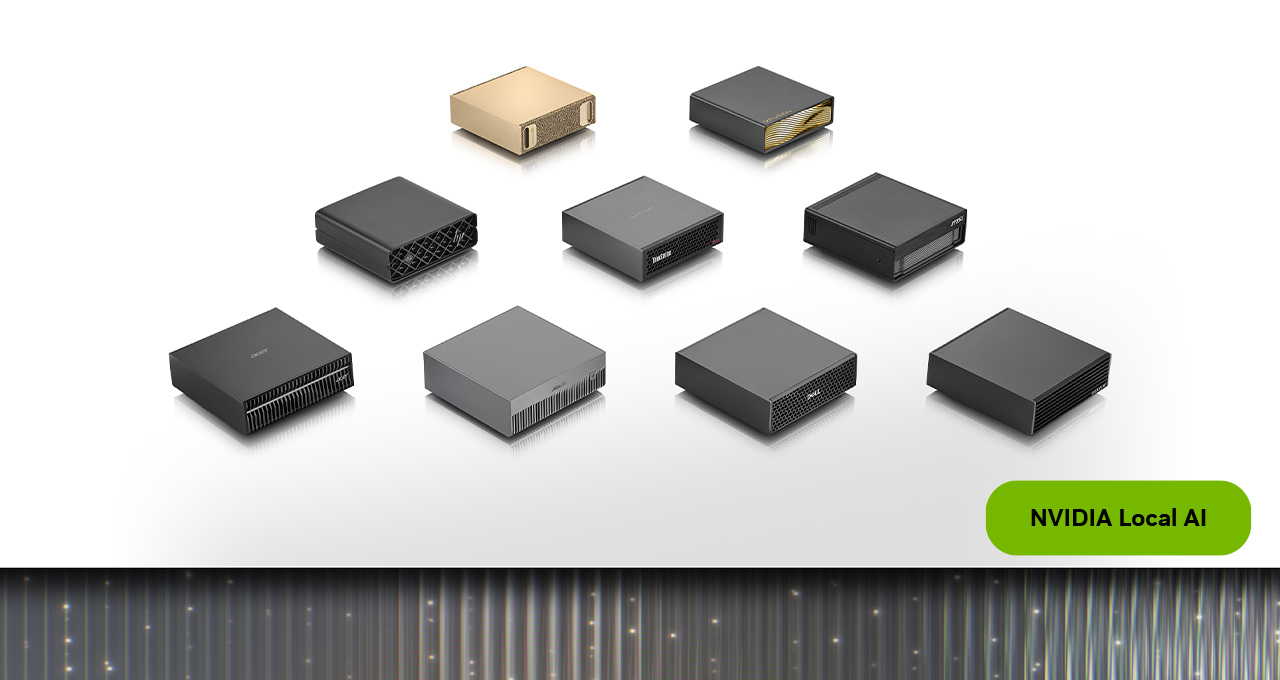
英伟达推出DGX Spark 64GB版,10月23日起由宏碁、华硕、戴尔等厂商发售,起价4999美元。该设备搭载GB10超级芯片与统一内存,支持本地运行最高千亿参数模型,预装完整AI软件栈。两台设备可通过Sync Cluster Assistant互联,内存池化至128GB,性能提升最高1.7倍,支持两千亿参数模型。
AI时代,芯片性能瓶颈从算力转向内存带宽。苹果、小米、英伟达等厂商通过统一内存、3D堆叠、HBM等技术提升数据传输速度,以应对大模型对数据的巨大需求。这源于“内存墙”问题,即算力增速远超内存带宽,导致处理器等待数据。未来芯片设计需让数据少走弯路,硬件物理法则仍不可逃避。
苹果未开发布会直接上线新款 Mac Studio,顶配 512GB 统一内存回归,可本地运行数百 B 参数大模型。M5 Ultra 带宽达 1.2TB/s,SSD 升级 PCIe 6.0。其价值不在省订阅费,而在数据主权,适合法律、医疗等敏感场景,是普通人可正规购买的大容量本地 AI 一体机。
本文探讨了英伟达的“统一内存”架构,旨在合并CPU和GPU的内存,以提升性能和简化数据传输。文章分析了传统分离架构的局限性,强调统一内存在AI和游戏应用中的优势,同时指出其在内存类型选择和市场策略上的挑战。
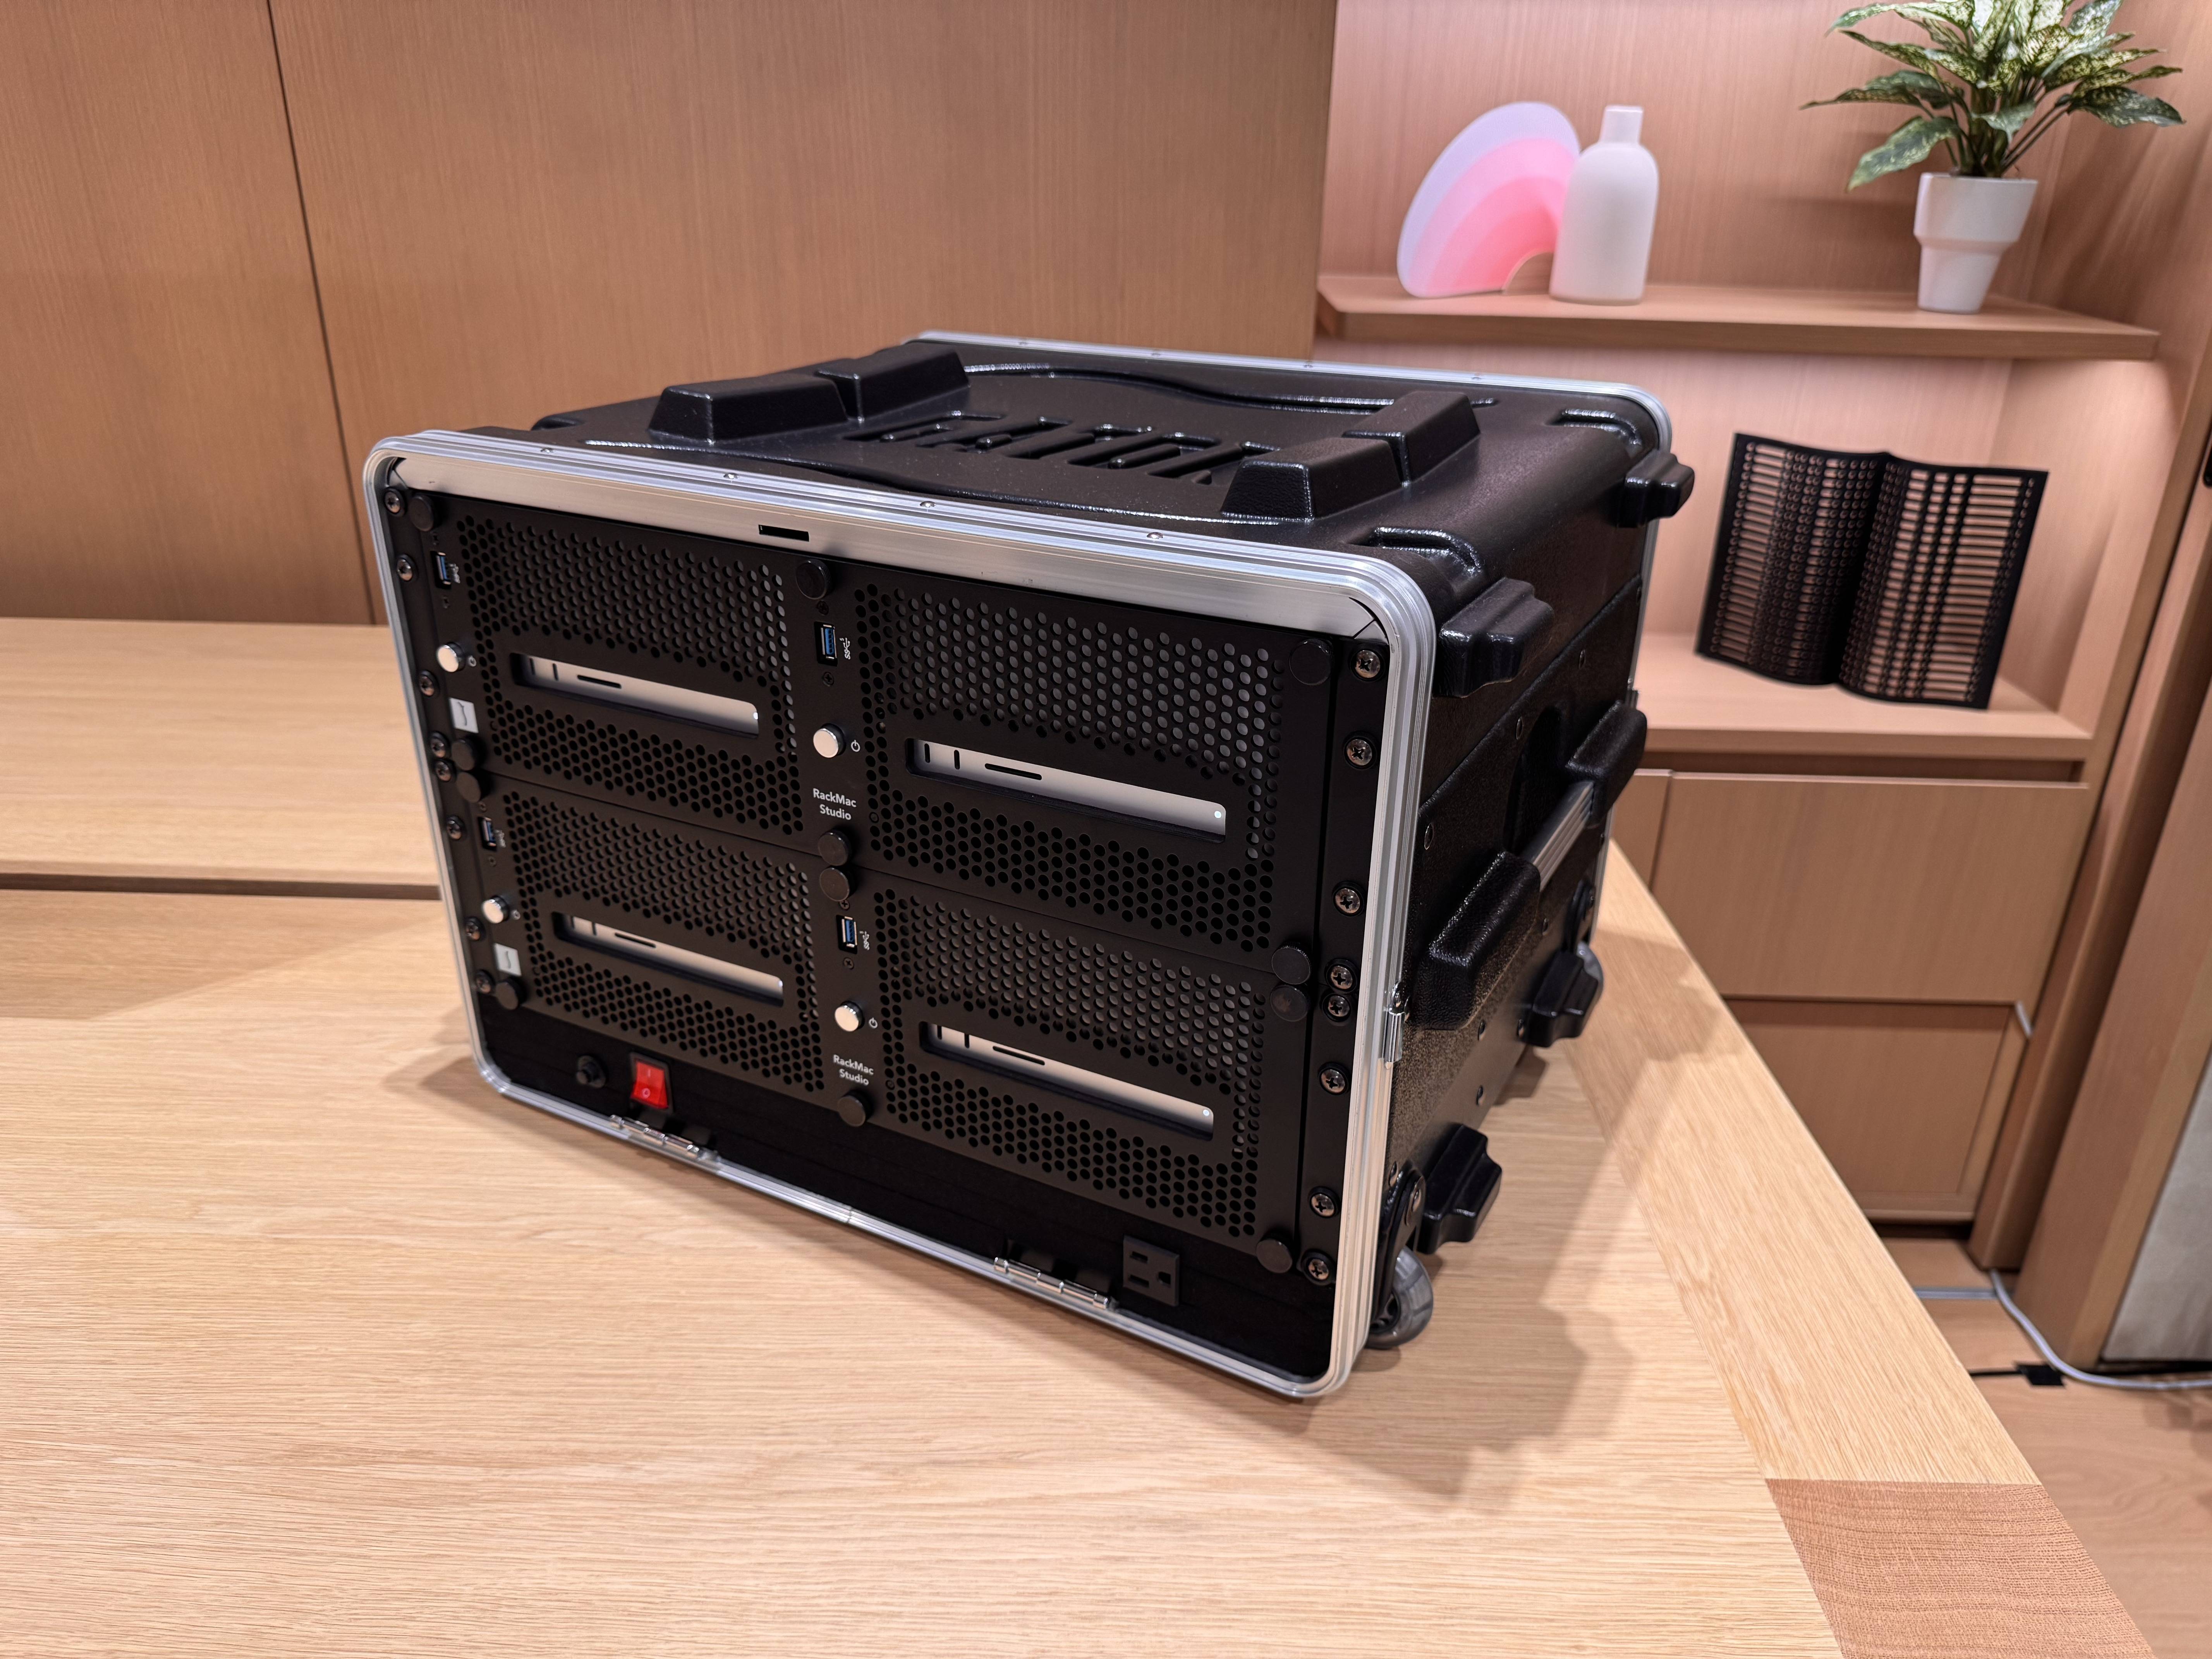
Exo Labs将四台M3 Ultra Mac Studio串联成AI集群,通过Exo V2平台实现模型自动拆分与并行推理,提升本地推理能力,降低成本与功耗。苹果的统一内存架构为中小团队提供了新的AI应用定位。
CUDA统一内存(受管内存)是CUDA编程的基础,旨在简化内存管理并提高GPU与CPU之间的数据共享效率。
完成下面两步后,将自动完成登录并继续当前操作。