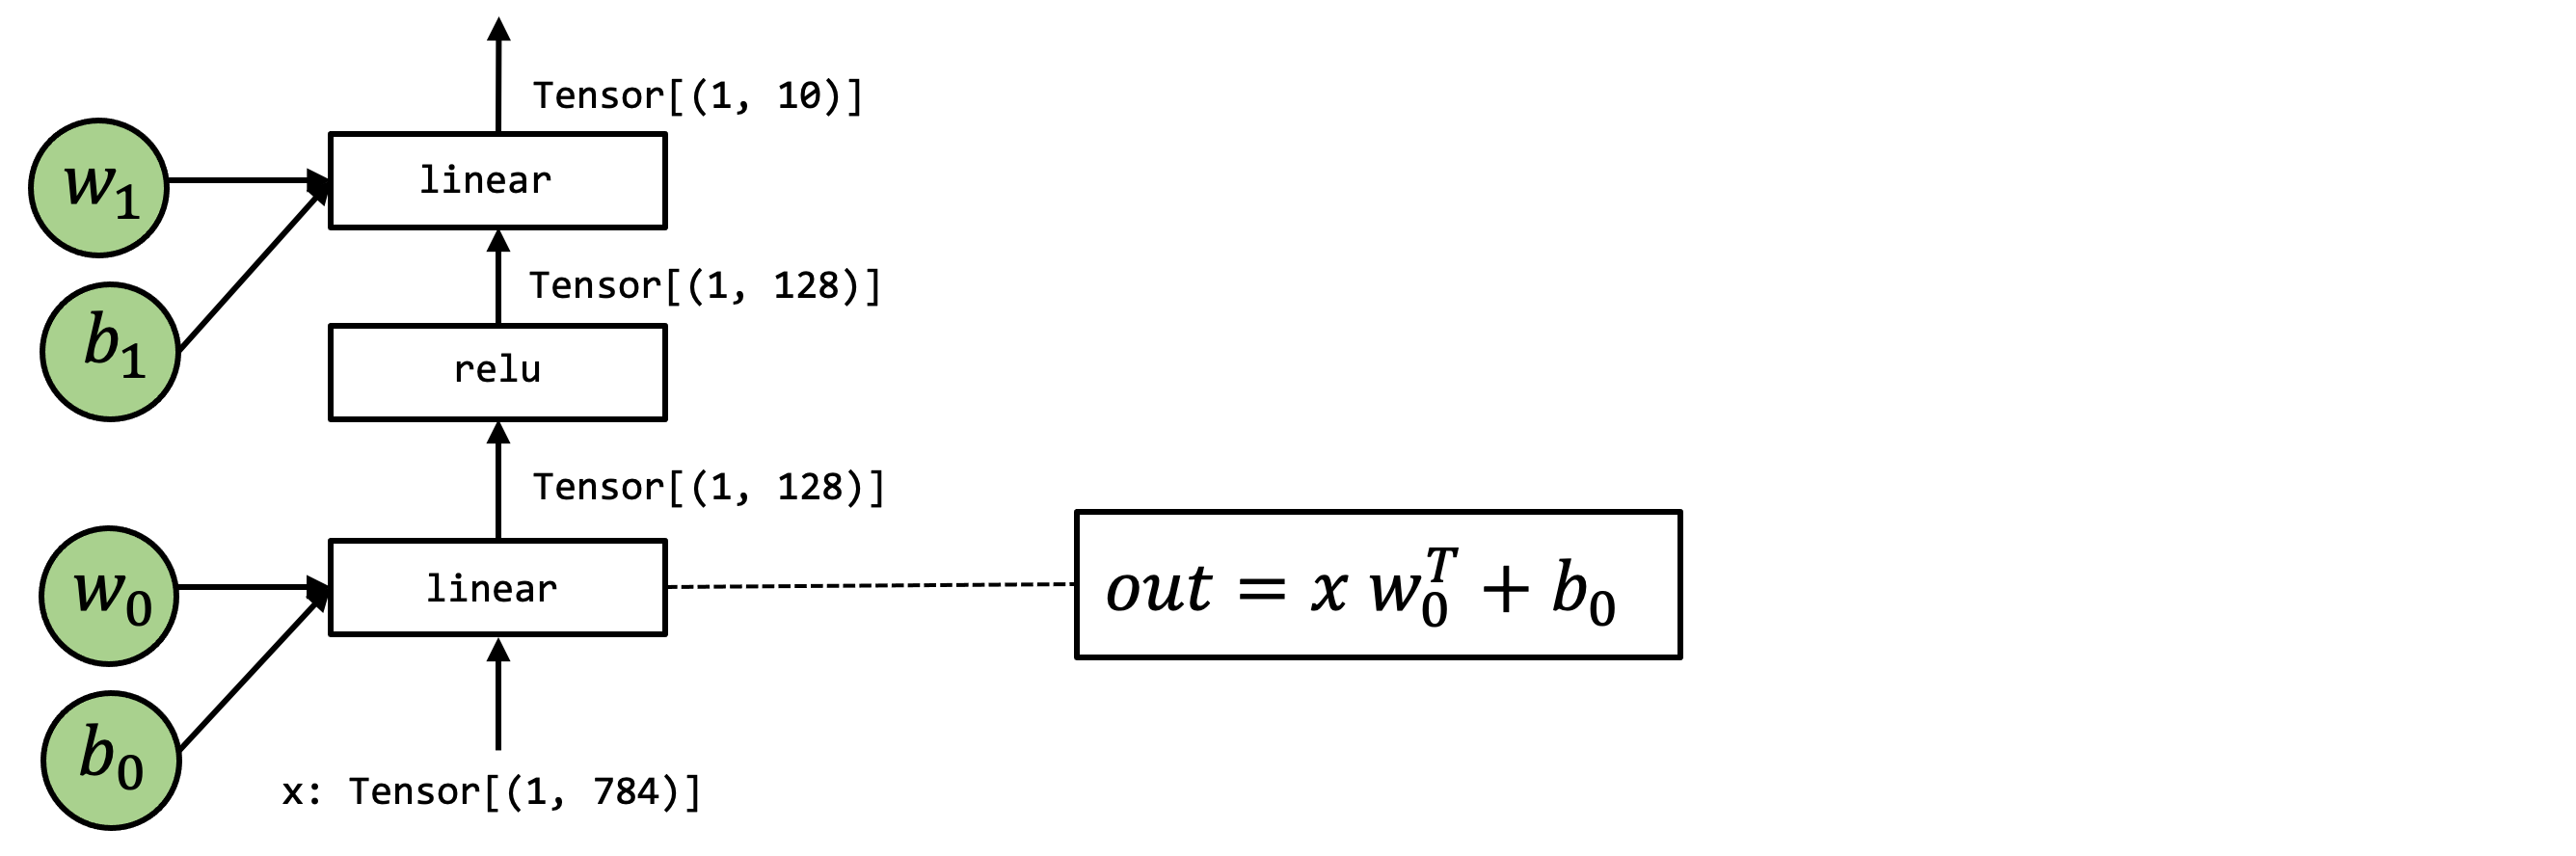Praneos Labs 在相同硬件与源码下,对 Go 1.2 至 1.27 共 26 个版本进行无缓存压测。结果显示,Go 1.27 比 1.23 快 11.5%,比 1.2 快约 41%。性能提升主要来自 Go 1.5–1.7 的编译器重构和 1.24–1.27 的 runtime 优化,中间七年吞吐量基本平稳。map 密集型和频繁重分配的程序提速明显,纯数值计算自 1.7 后几乎无变化。Go 与 C 的差距多源于手写 SIMD 指令,在标量对比下差距已缩小至 0%–30%。
JVM即时编译(JIT)对Java性能至关重要,支撑Valhalla、Leyden、Panama等OpenJDK项目,并持续演进以适应语言、应用、部署和硬件发展。本演讲概述JIT近期性能改进与重要进展。
微软将参加9月14至18日在科罗拉多州奥罗拉举行的CppCon 2026并设展台,演讲涵盖AI辅助开发、MSVC、Visual Studio与VS Code、编译器优化、C++安全及语言设计,重点包括《盗贼之海》代码库启用/W4 /WX的经验、VS 2026新编译器优化与基于采样的PGO、以及工具难以发现的C++运行时安全问题。大会还邀请开发者填写年度调查问卷。
本文探讨了GPU算子工程的最新趋势,包括Hopper架构的TMA和wgmma特性、FP8到FP4的精度降低、ThunderKittens库的简化编程模型,以及编译器自动化优化算子的未来。强调理解硬件执行模型的重要性,以有效利用新工具和指令,整体方法论围绕数据复用、访存优化和性能分析展开,旨在提升算子开发效率。
寄存器分配是编译器优化的核心,旨在将虚拟寄存器映射到有限的物理寄存器。该过程包括活跃性分析、干涉图构建及多种算法(如Chaitin-Briggs图着色和线性扫描)。良好的寄存器分配能显著提升程序性能,减少内存溢出。现代编译器如LLVM采用贪心策略和区间分裂技术,以提高分配效率和代码质量。
本文讨论了MLIR中Region和Block在控制流表示中的重要性。Region提供了嵌套和隔离控制流的能力,使MLIR能够表达复杂的程序结构。与LLVM IR的扁平基本块模型不同,MLIR通过嵌套Region实现结构化控制流,使用Block参数替代phi指令,简化了数据流分析和控制流管理。Region的设计支持Lambda式抽象,确保值的可见性和隔离,促进编译器优化。
本文讨论了MLIR中的Affine和SCF方言。Affine方言通过强约束实现精确的依赖分析,适用于循环优化,其循环边界和下标必须是仿射函数,适合多面体编译。SCF方言则提供更通用的控制流操作,不受此限制,适合更广泛的应用。两者结合使编译器能够在不同层次上进行优化,提升性能。
本文分析了SPEC CPU 2026中的FP Rate负载特性,探讨了不同编译器和选项对性能的影响。比较709.cactus_r和722.palm_r基准测试后发现,使用“-march=native”选项显著提升性能,尤其在浮点运算和向量化方面。LLVM 22在向量化和指令生成上优于GCC 14,导致更低的错误预测率和更高的执行效率。编译器优化对浮点应用的性能提升至关重要。
Apache TVM 更新至 0.21.0 版本,中文文档已同步。TVM 是一个深度学习编译框架,支持多种硬件。Relax 是其图抽象方式,用于优化机器学习模型。文章介绍了如何使用 Relax 表达神经网络模型的结构与数据流,并提供了高层与底层实现的代码示例,强调数据流块和无副作用函数的重要性,以便于编译器优化。
2026年3月27日,Rust会议将在巴黎举行,讨论Rust的高级特性、编译器优化和异步编程等主题。Concryptor是一个用Rust开发的多线程加密引擎,支持AES和ChaCha20加密,性能优越,但仍处于实验阶段。
ACCESS_ONCE() 是 Linux 源码中的宏,确保编译器不会合并或重新获取对标量类型的访问。它通过将变量转为 volatile 类型,防止编译器优化引发错误。READ_ONCE() 和 WRITE_ONCE() 适用于非标量类型,主要用于进程与中断处理之间的通信,确保内存访问顺序性。
在CSAPP Data Lab中,讨论了如何判断一个整数是否为最大二的补码(0x7fffffff)。由于整数溢出可能导致未定义行为,编译器优化可能产生错误结果。通过构造复杂表达式来避免简单模式的优化,从而实现正确判断。强调开发者应避免依赖未定义行为,并使用编译器警告和运行时检测工具以确保代码的健壮性。
本文讨论了C语言中的整型溢出和未定义行为,特别是CSAPP Data Lab中的isTmax函数实现。通过分析编译器优化对未定义行为的影响,作者展示了如何设计代码以避免错误,强调开发者应遵循语言标准,避免依赖未定义行为,并使用工具检测潜在问题。
该视频讨论了HotSpot C2自动向量化器的发展与改进,介绍了SuperWord算法及其增强,未来计划包括依赖图管理、别名分析、向量化盈利性和性能回归,适合对编译器优化和JVM性能感兴趣的观众。
SSA(静态单赋值)形式在编译器优化中至关重要,要求每个变量仅被赋值一次,简化数据流分析,提升优化效率。文章介绍了SSA的定义、支配树构造、φ函数放置及经典优化算法,强调了SSA在现代编译器(如LLVM和GCC)中的应用,并通过Python实现展示了SSA的构造过程及其在编译器优化中的重要性。
C++中的段错误(segfault)通常由未初始化变量、作用域错误或编译器优化引起。确保变量正确初始化,并使用调试工具(如GDB和Valgrind)可以帮助定位问题。优化级别可能影响代码行为,需谨慎处理。
本研究提出了VecTrans框架,旨在解决大型语言模型(LLM)在编译器优化中的向量化挑战。该框架通过识别并重构潜在的向量化代码区域,结合编译器的精确性与LLM的适应性,显著提升了性能。实验表明,VecTrans成功向量化了46%的传统编译器无法处理的例子,平均速度提升2.02倍。
本文分析了Go语言在性能测试中的不足,特别是在十亿次循环和百万任务场景下,其速度和内存开销不如C和Java,主要由于Go编译器优化不足和Goroutine内存占用较高。希望Go团队能加强编译器优化,以提升性能。
本文探讨了AOT编程中的节点依赖图,强调节点的层级关系和依赖算法。通过示例代码展示了依赖图的构建,并指出AOT编译器在处理未构造类型时的不足,期待未来的优化。
第三周我们学习了编译器优化技术,包括死代码消除、强度削减、循环展开等。这些优化帮助编写高效代码,并通过编译器标志进行性能调优。开发者还可以使用记忆化和预计算提升性能。
完成下面两步后,将自动完成登录并继续当前操作。